SkillBamboo
Каждый раз, когда лимит подписки заканчивался посреди работы, я косился на свою RTX 3090 и думал, что видеопамять у меня просто простаивает. Логичный ход был поставить Qwen 3.8 27B и гонять кодинг-агента локально, без лимитов и без оглядки на счётчик. На деле всё оказалось не так радужно, потому что на длинном контексте модель еле ползла, а Claude Code к ней вообще не подключался. Пришлось разбираться, и выяснилось, что карта тут почти ни при чём, всё упирается в движок, шаблон и кэш. Ниже по шагам, как собрать это так, чтобы Claude Code работал с Qwen локально и выдавал около 70 токенов в секунду.
Почему Qwen 3.8 27B на RTX 3090 упирается не в видеокарту
На октябрь 2026 года Qwen 3.8 27B, по одной из оценок, лучшая модель для программирования из тех, что запускаются на потребительских видеокартах. 3090 её тянет, вопрос только в том, как.
Механика скорости агента простая – она складывается из трёх вещей. Первая это движок: сборка, заточенная под архитектуру карты, в замере ниже (вместе со сжатым кэшем) заметно быстрее универсальной. Вторая это chat template (шаблон, по которому диалог превращается в промпт): с неподходящим шаблоном Claude Code с моделью просто не работает. Ну и третья, KV-кэш.
Перед ответом модель прочитывает весь промпт и сохраняет промежуточные «заметки». Это и есть KV-кэш. Он лежит в видеопамяти рядом с весами модели и получает только то место, что осталось после них. Поэтому модель не стоит подбирать впритык к памяти карты: модель на 32 ГБ на карте с 32 ГБ не оставит места под кэш. У нас модель весит 15 ГБ, так что на 24 ГБ остаётся запас и под кэш, и под длинный контекст.
Шаг 1. Собрать llamAmpere: llama.cpp с CUDA под Ampere
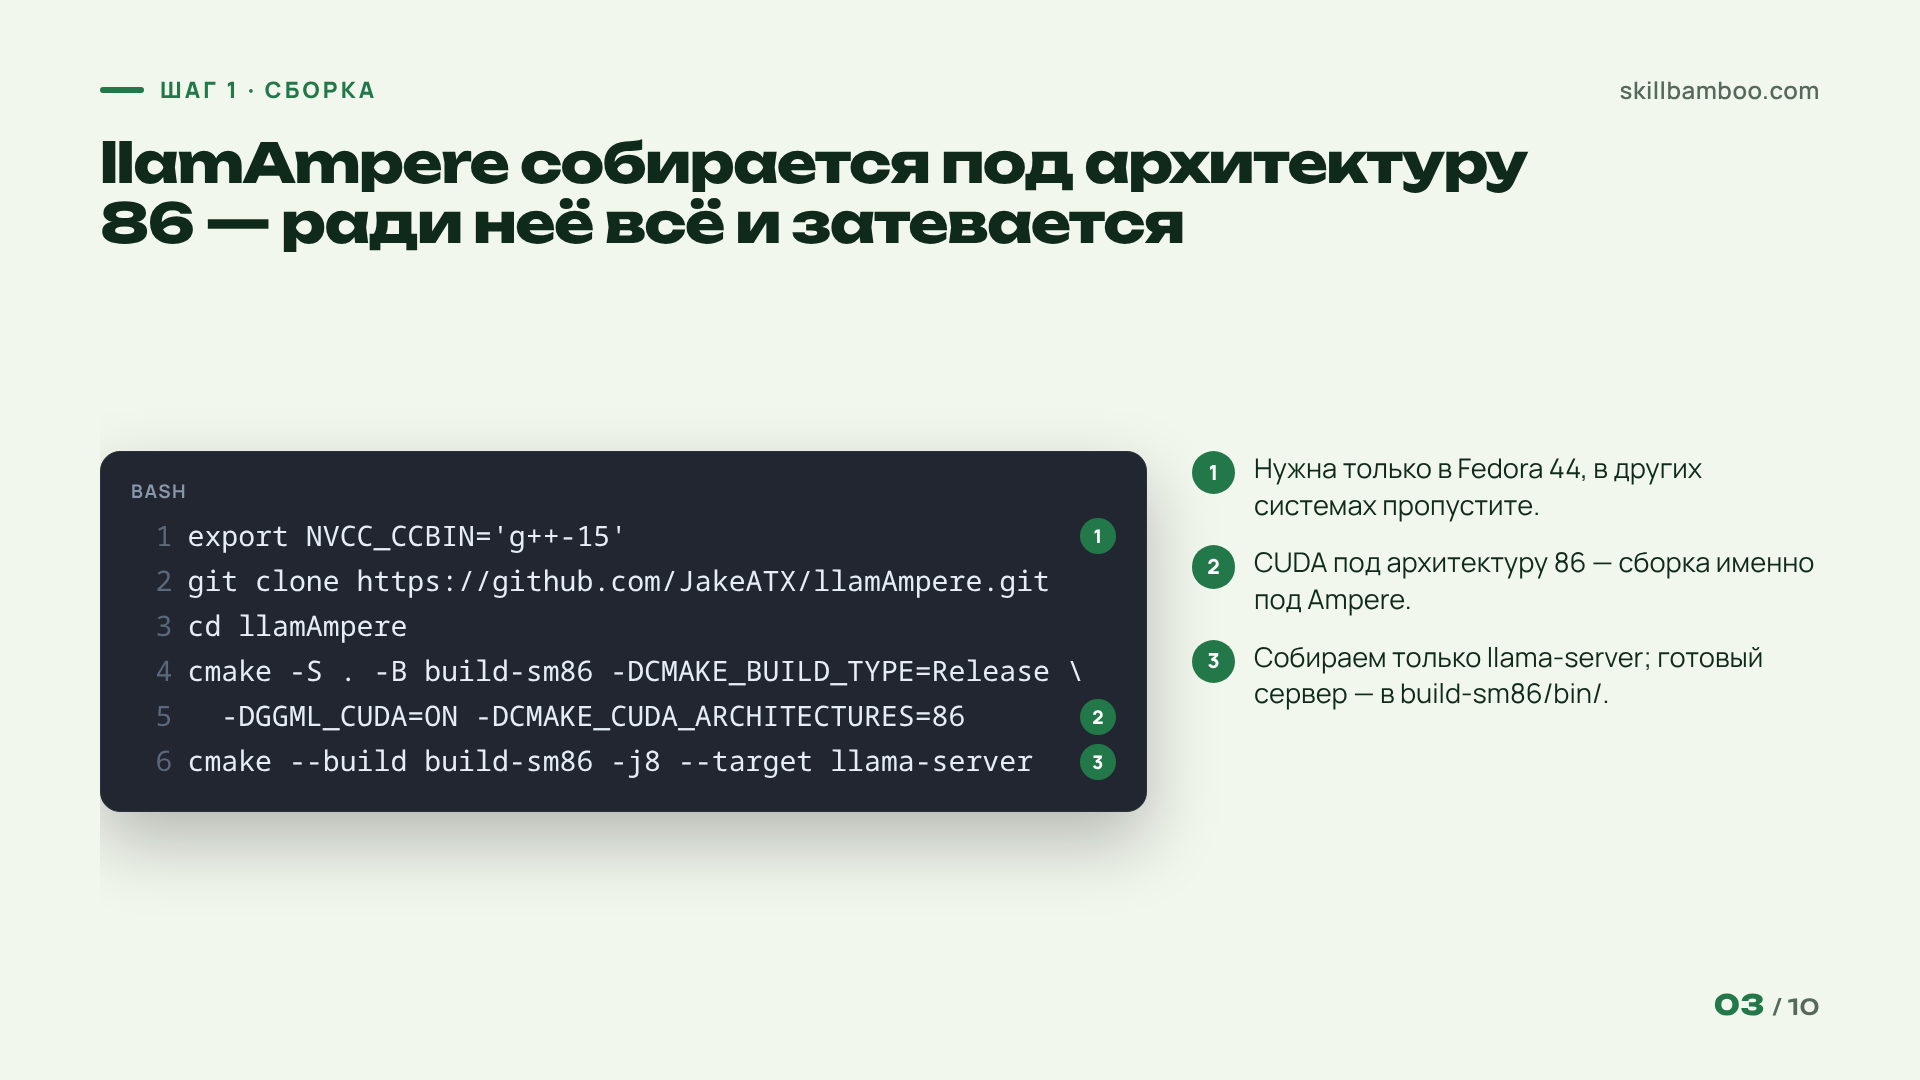
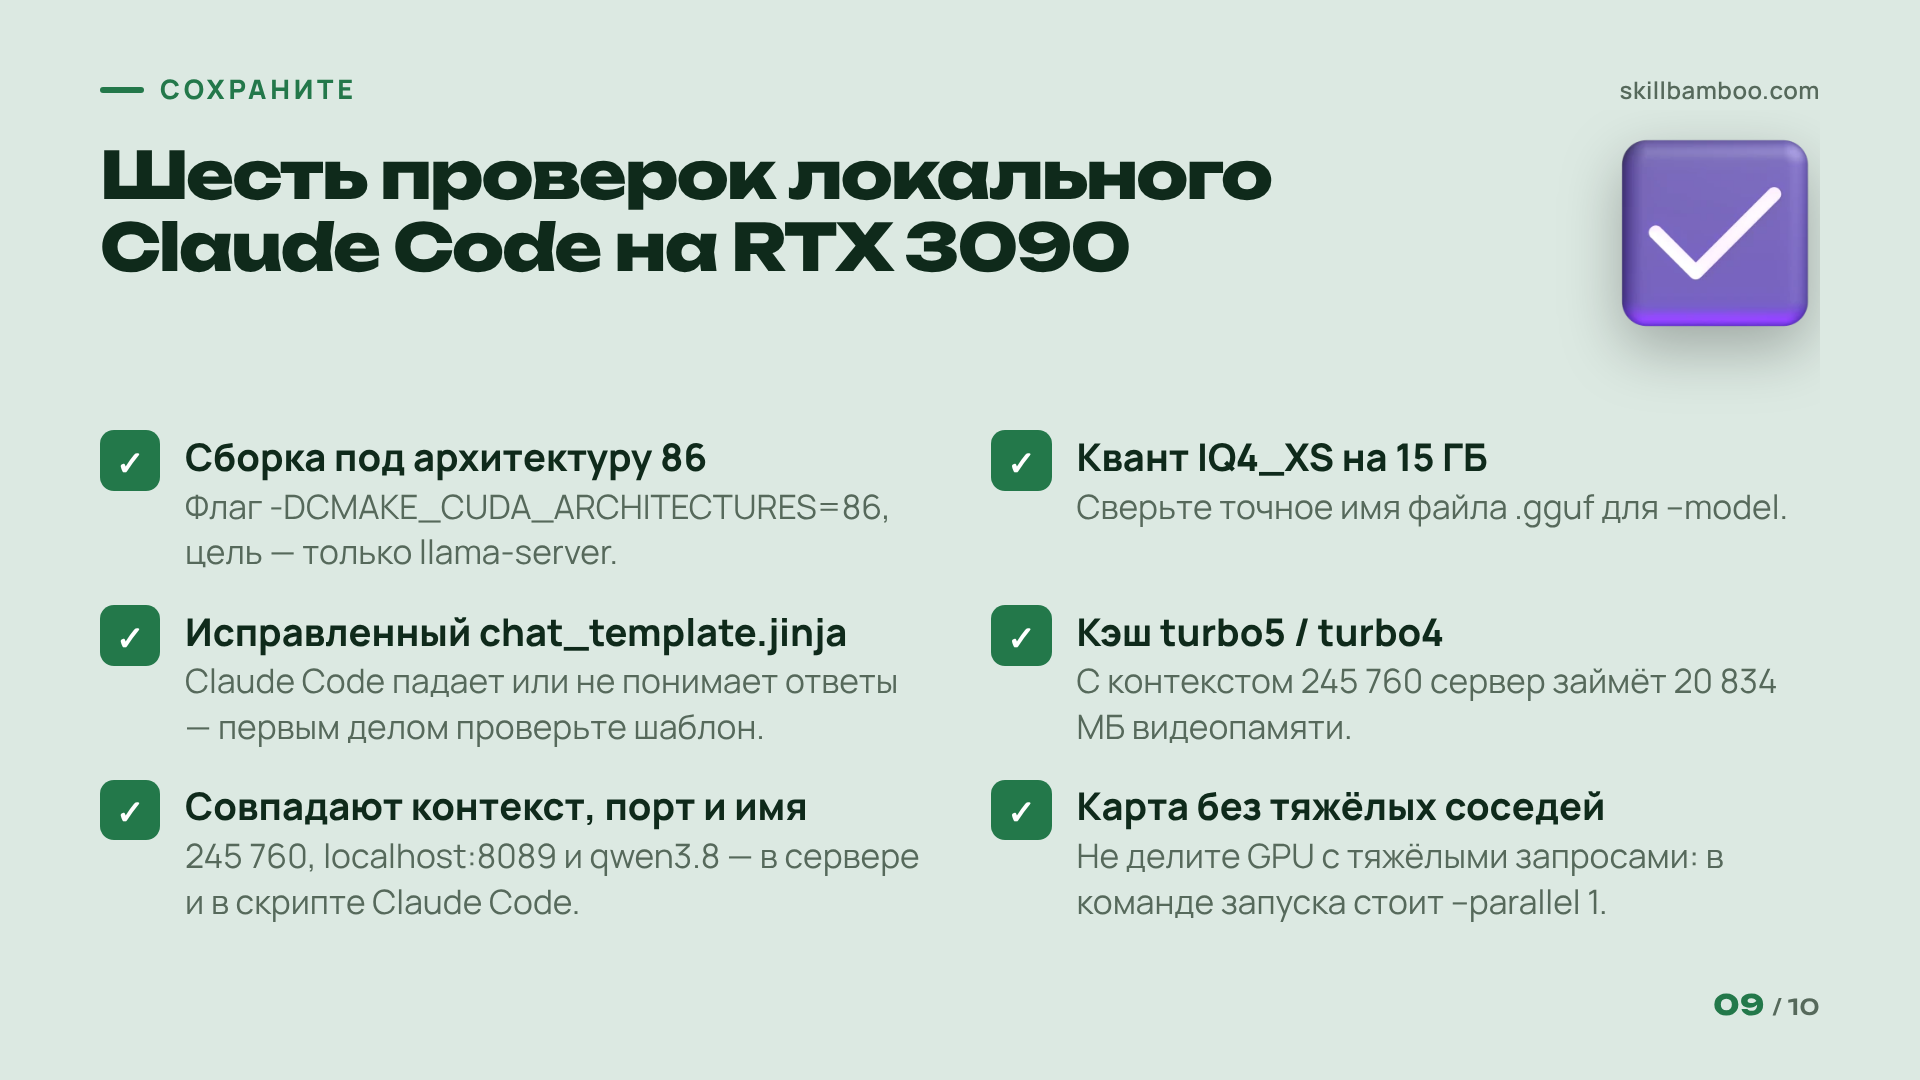
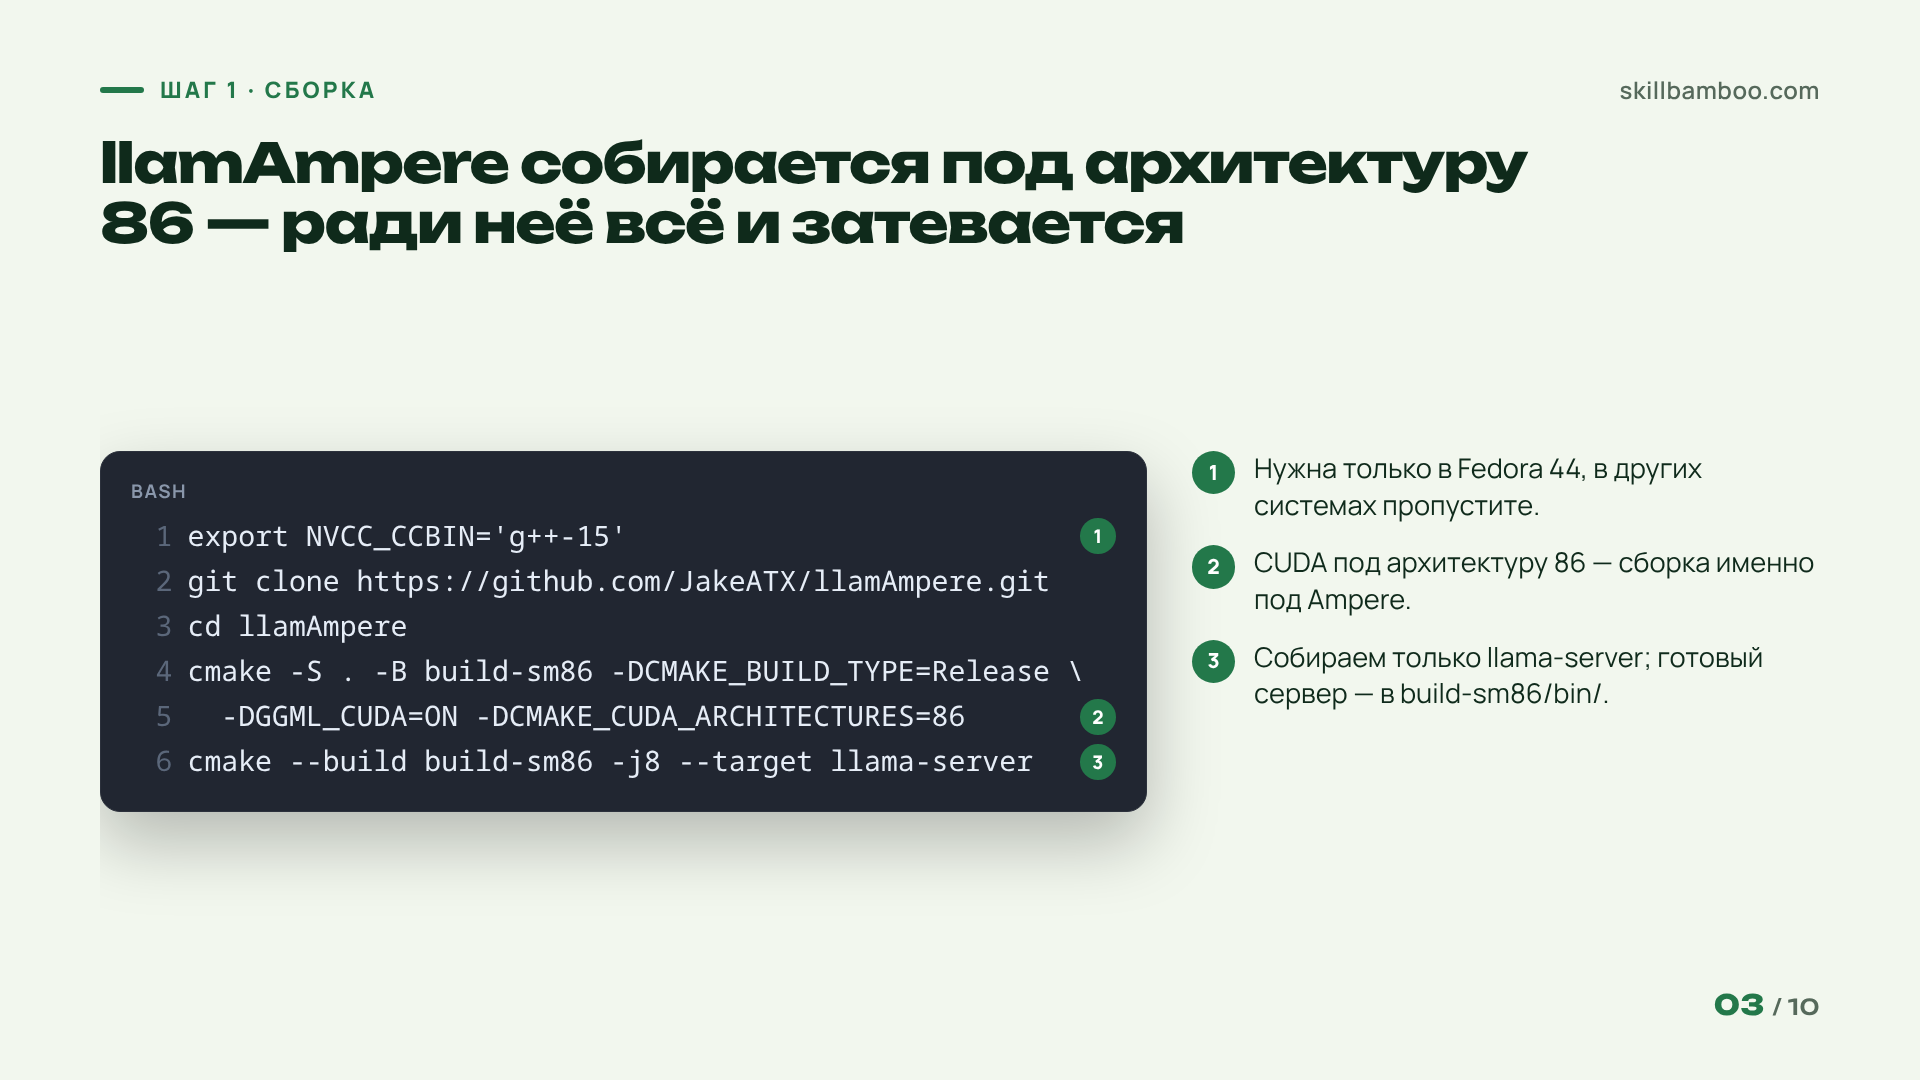
llamAmpere это форк llama.cpp, оптимизированный под видеокарты поколения Ampere, к которому относится RTX 3090. Собираем его с поддержкой CUDA под архитектуру 86, а цель сборки только llama-server: больше для агента ничего не нужно.
JakeATX/llamAmpere – форк llama.cpp для ускорения на RTX 3090
export NVCC_CCBIN='g++-15' # Только для fedora-44!
git clone https://github.com/JakeATX/llamAmpere.git
cd llamAmpere
cmake -S . -B build-sm86 -DCMAKE_BUILD_TYPE=Release -DGGML_CUDA=ON -DCMAKE_CUDA_ARCHITECTURES=86
cmake --build build-sm86 -j8 --target llama-server
Для сборки нужны cmake и gcc не новее 14; в Fedora 44 к системному gcc 16 придётся доставить пакеты gcc15 и gcc15-c++. Первая строка с компилятором g++-15 нужна только в Fedora 44, в других системах её пропустите. Флаг -DCMAKE_CUDA_ARCHITECTURES=86 и задаёт сборку под Ampere (ради него всё и затевается). Готовый сервер окажется в build-sm86/bin/llama-server.
Шаг 2. Скачать квант IQ4_XS и исправленный chat template
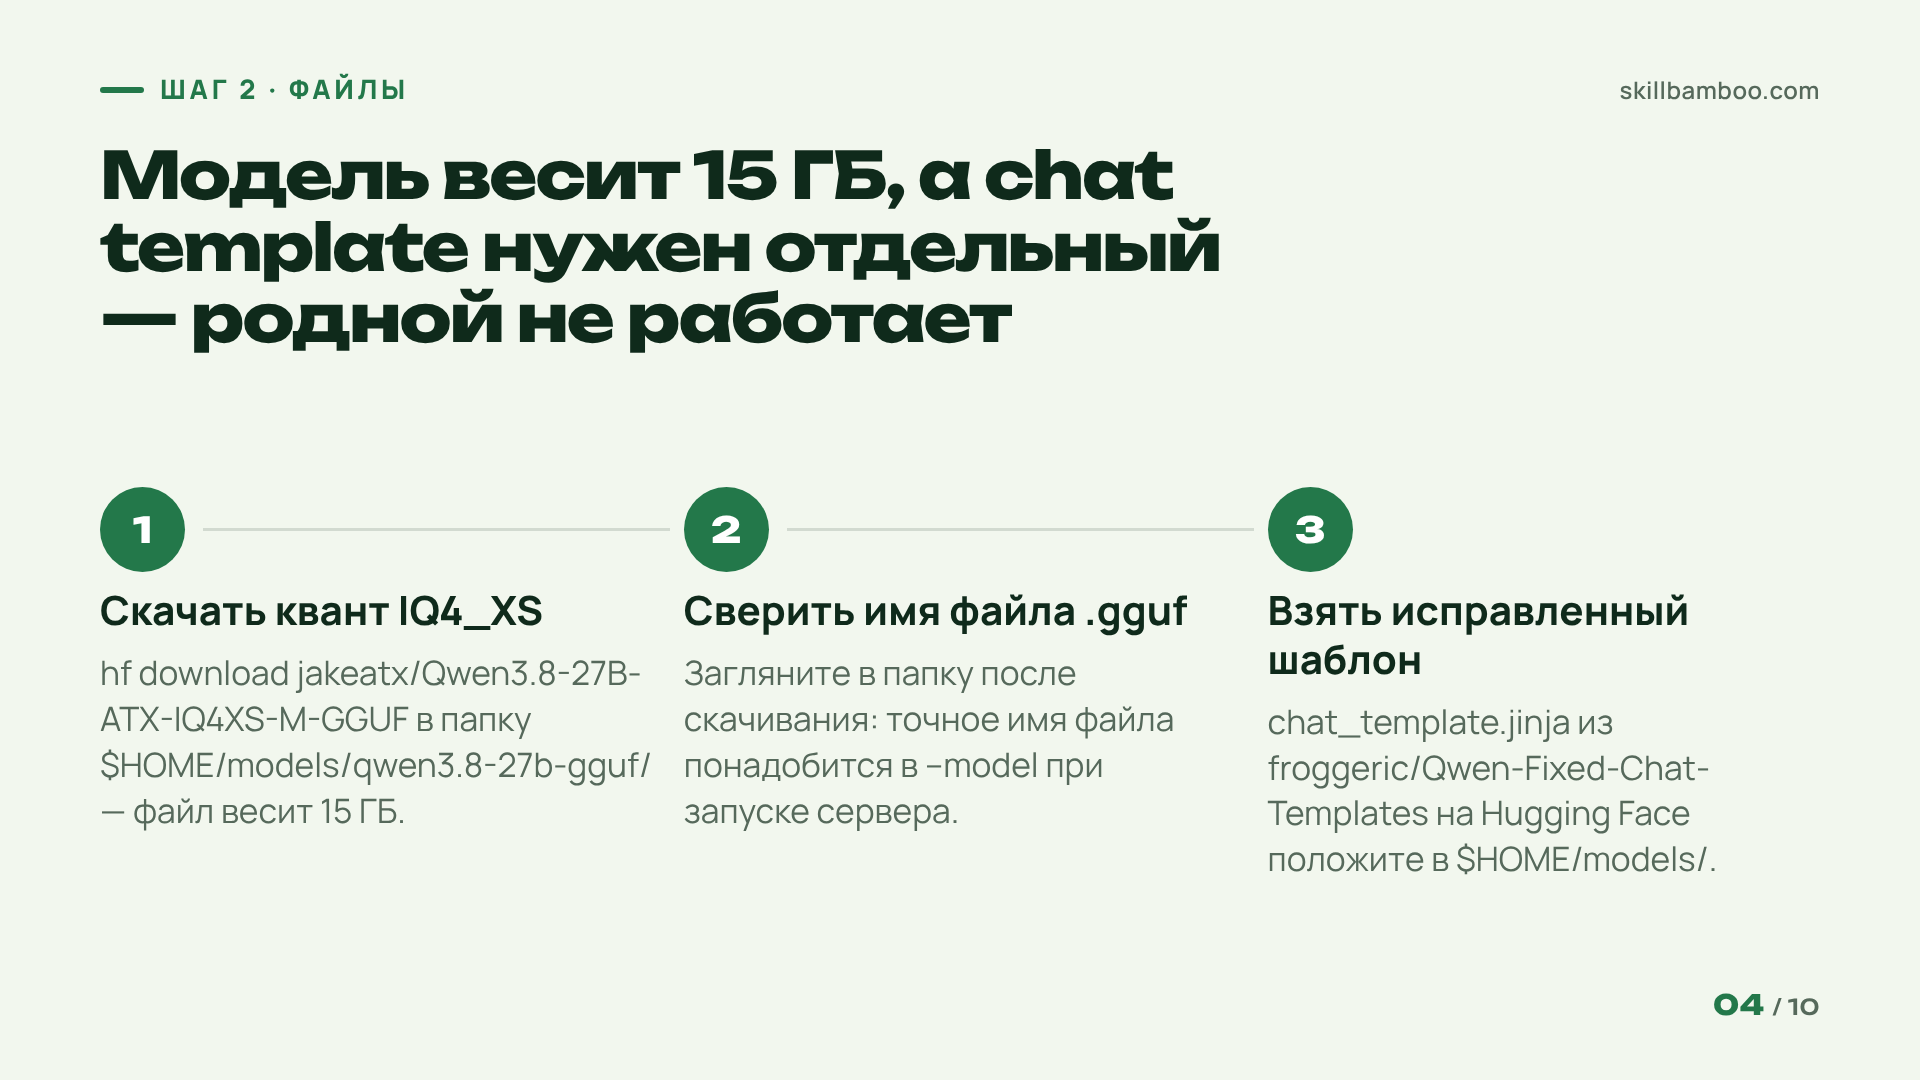
Полная модель в 24 ГБ не влезет, поэтому берём квантованную версию в формате GGUF с квантом IQ4_XS. Она весит 15 ГБ и скачивается клиентом Hugging Face:
jakeatx/Qwen3.8-27B-ATX-IQ4_XS-M-GGUF – квант Qwen 3.8 27B для llamAmpere
hf download jakeatx/Qwen3.8-27B-ATX-IQ4_XS-M-GGUF --local-dir $HOME/models/qwen3.8-27b-gguf/
После скачивания загляните в папку и сверьте точное имя файла .gguf: оно понадобится в команде запуска на следующем шаге.
Теперь шаблон. Со встроенным в модель chat template Claude Code не заработал, поэтому исправленный файл chat_template.jinja берём из репозитория froggeric/Qwen-Fixed-Chat-Templates на Hugging Face. Нужен отдельный исправленный файл chat_template.jinja, кладём его в $HOME/models/, и сервер подхватит его при запуске.
Шаблон – не мелочь
Если Claude Code падает или не понимает ответы модели, первым делом проверьте, что сервер запущен с исправленным шаблоном, а не со встроенным. Без него агент с локальной моделью не работает, как ни настраивай остальное.
Шаг 3. Запустить сервер: контекст 245 тысяч токенов и сжатый KV-кэш
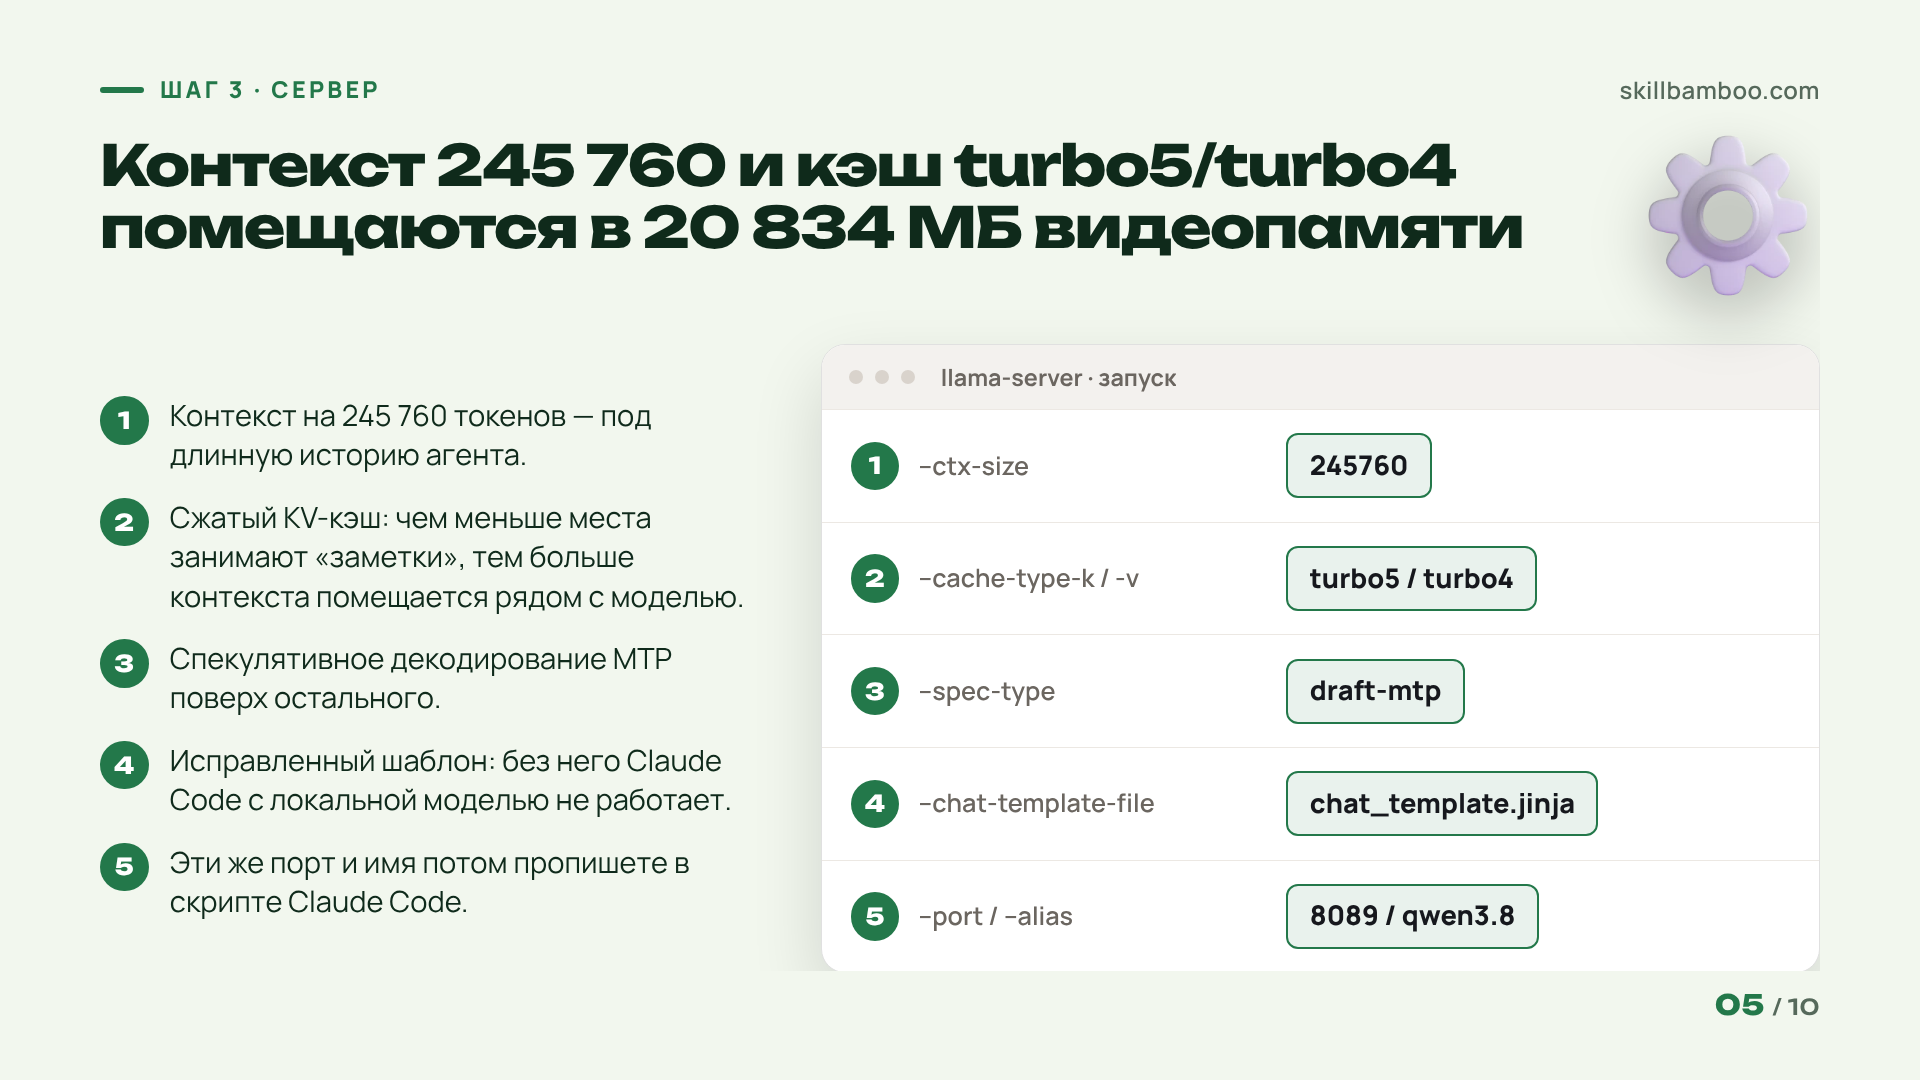
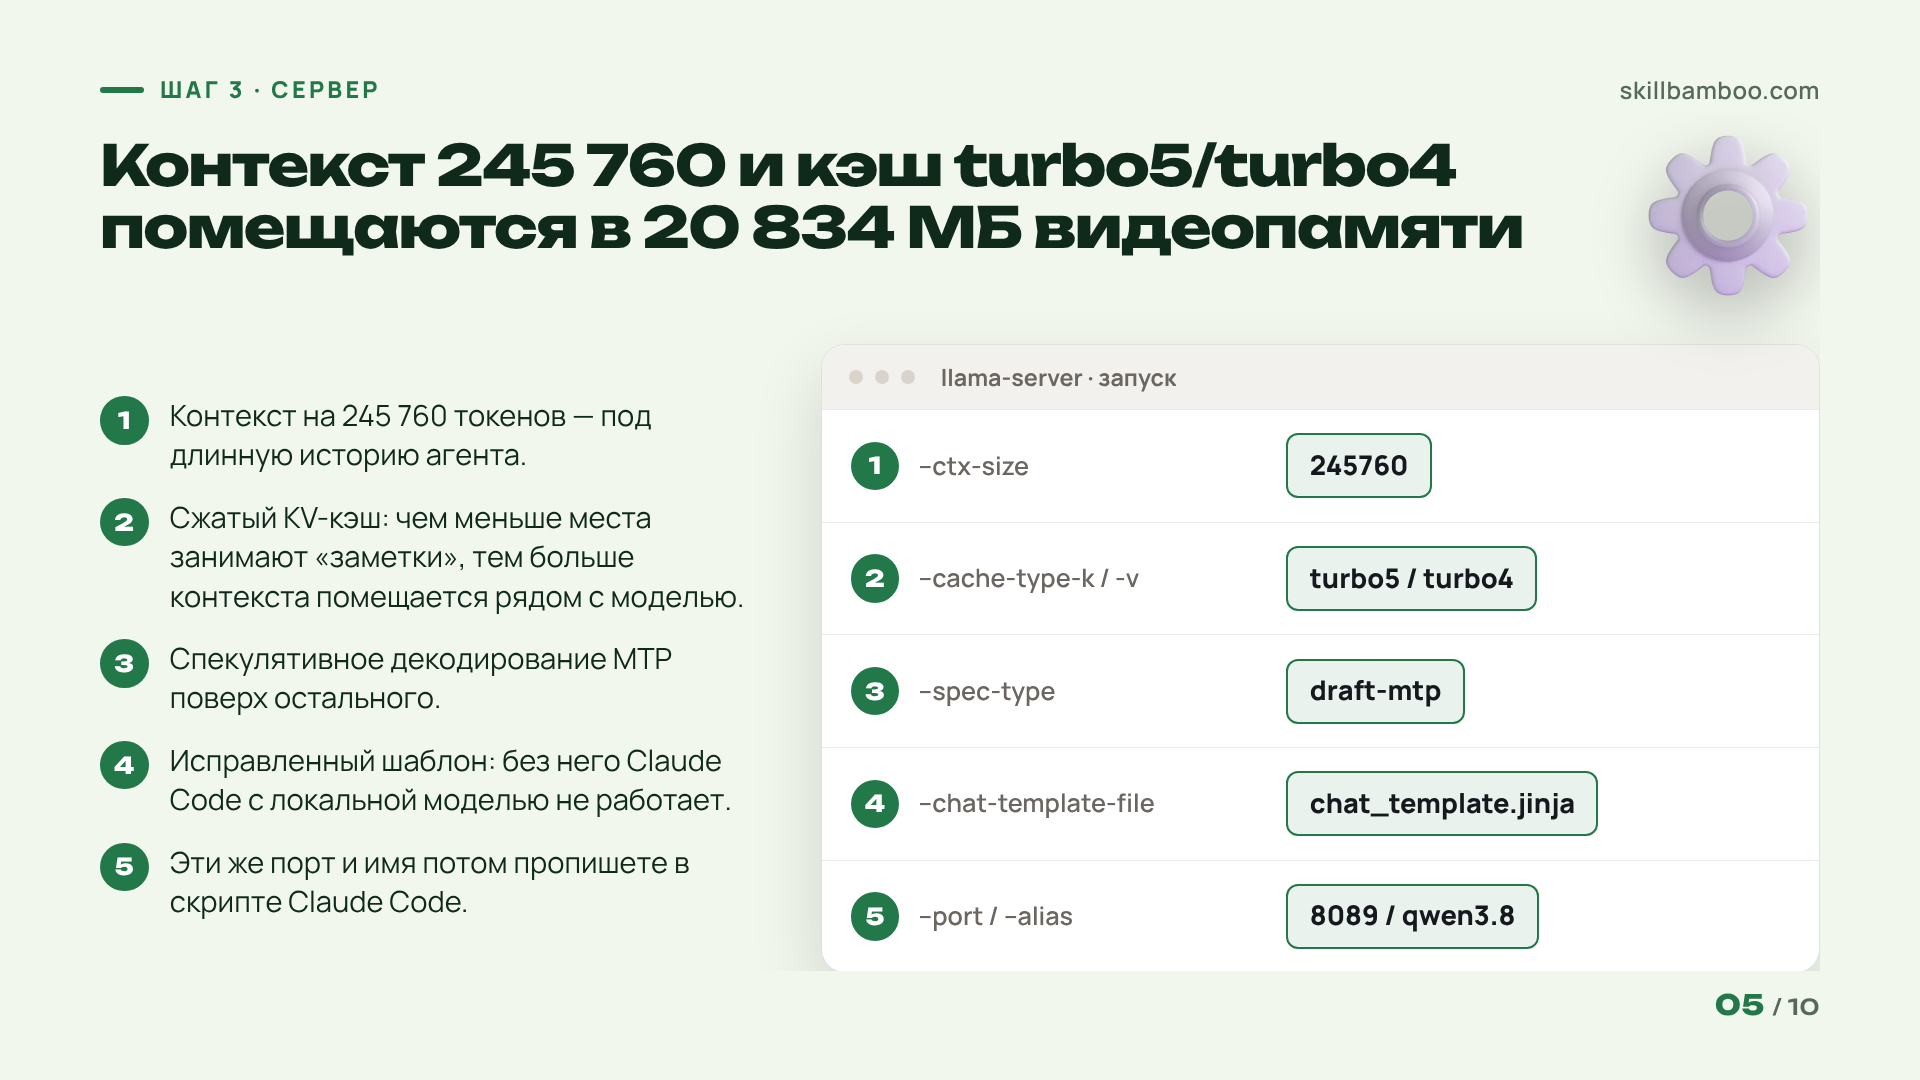
Дальше уже дело техники: собираем всё вместе. Сервер запускается с контекстом 245 760 токенов, всеми слоями модели на видеокарте, flash attention и сжатым KV-кэшем: тип turbo5 для ключей и turbo4 для значений. Сверху включено спекулятивное декодирование MTP (draft-mtp), а сервер слушает порт 8089 и отдаёт модель под именем qwen3.8.
./build-sm86/bin/llama-server \
--ctx-size 245760 \
--batch-size 4096 \
--ubatch-size 1024 \
--threads 8 \
--threads-batch 8 \
--n-gpu-layers 99 \
--flash-attn on \
--cache-type-k turbo5 \
--cache-type-v turbo4 \
--parallel 1 \
--jinja \
--spec-type draft-mtp \
--spec-draft-n-max 4 \
--spec-draft-p-min 0 \
--spec-draft-vocab-map auto \
--model $HOME/models/qwen3.8-27b-gguf/Qwen3.8-27B-ATX-4-XS.gguf \
--chat-template-file $HOME/models/chat_template.jinja \
--host 0.0.0.0 \
--port 8089 \
--alias qwen3.8 \
--reasoning-format deepseek
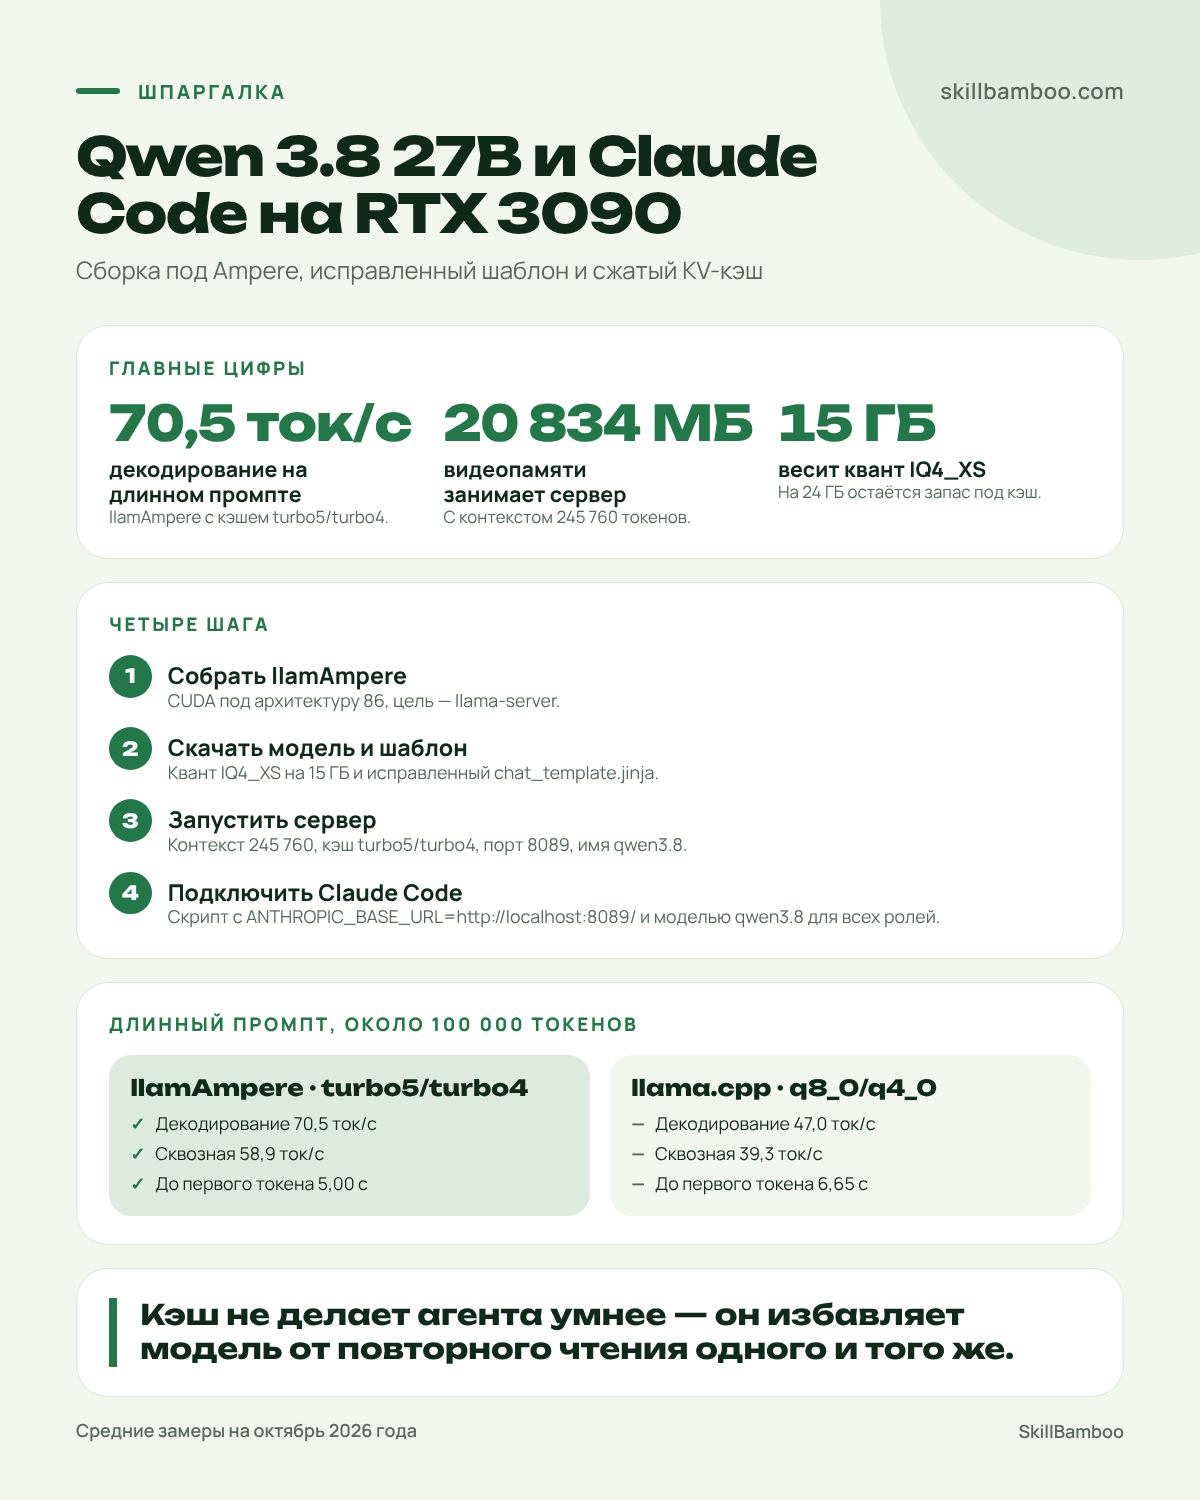
В --model подставьте имя файла, которое сверили на прошлом шаге. С такими параметрами сервер занимает 20 834 МБ видеопамяти, и на 24-гигабайтной карте остаётся запас.
Если сервер нужен только на этой машине, уберите из команды параметр --host 0.0.0.0.
Зачем сжимать кэш? Чем меньше места занимают «заметки», тем больше контекста помещается рядом с моделью. Когда память под кэш заканчивается, старые записи вытесняются, и при следующем обращении модель перечитывает всё с нуля. Для агента с длинной историей это прямая потеря скорости (=ждёте ответа дольше с каждым ходом).
Шаг 4. Подключить Claude Code к локальной модели
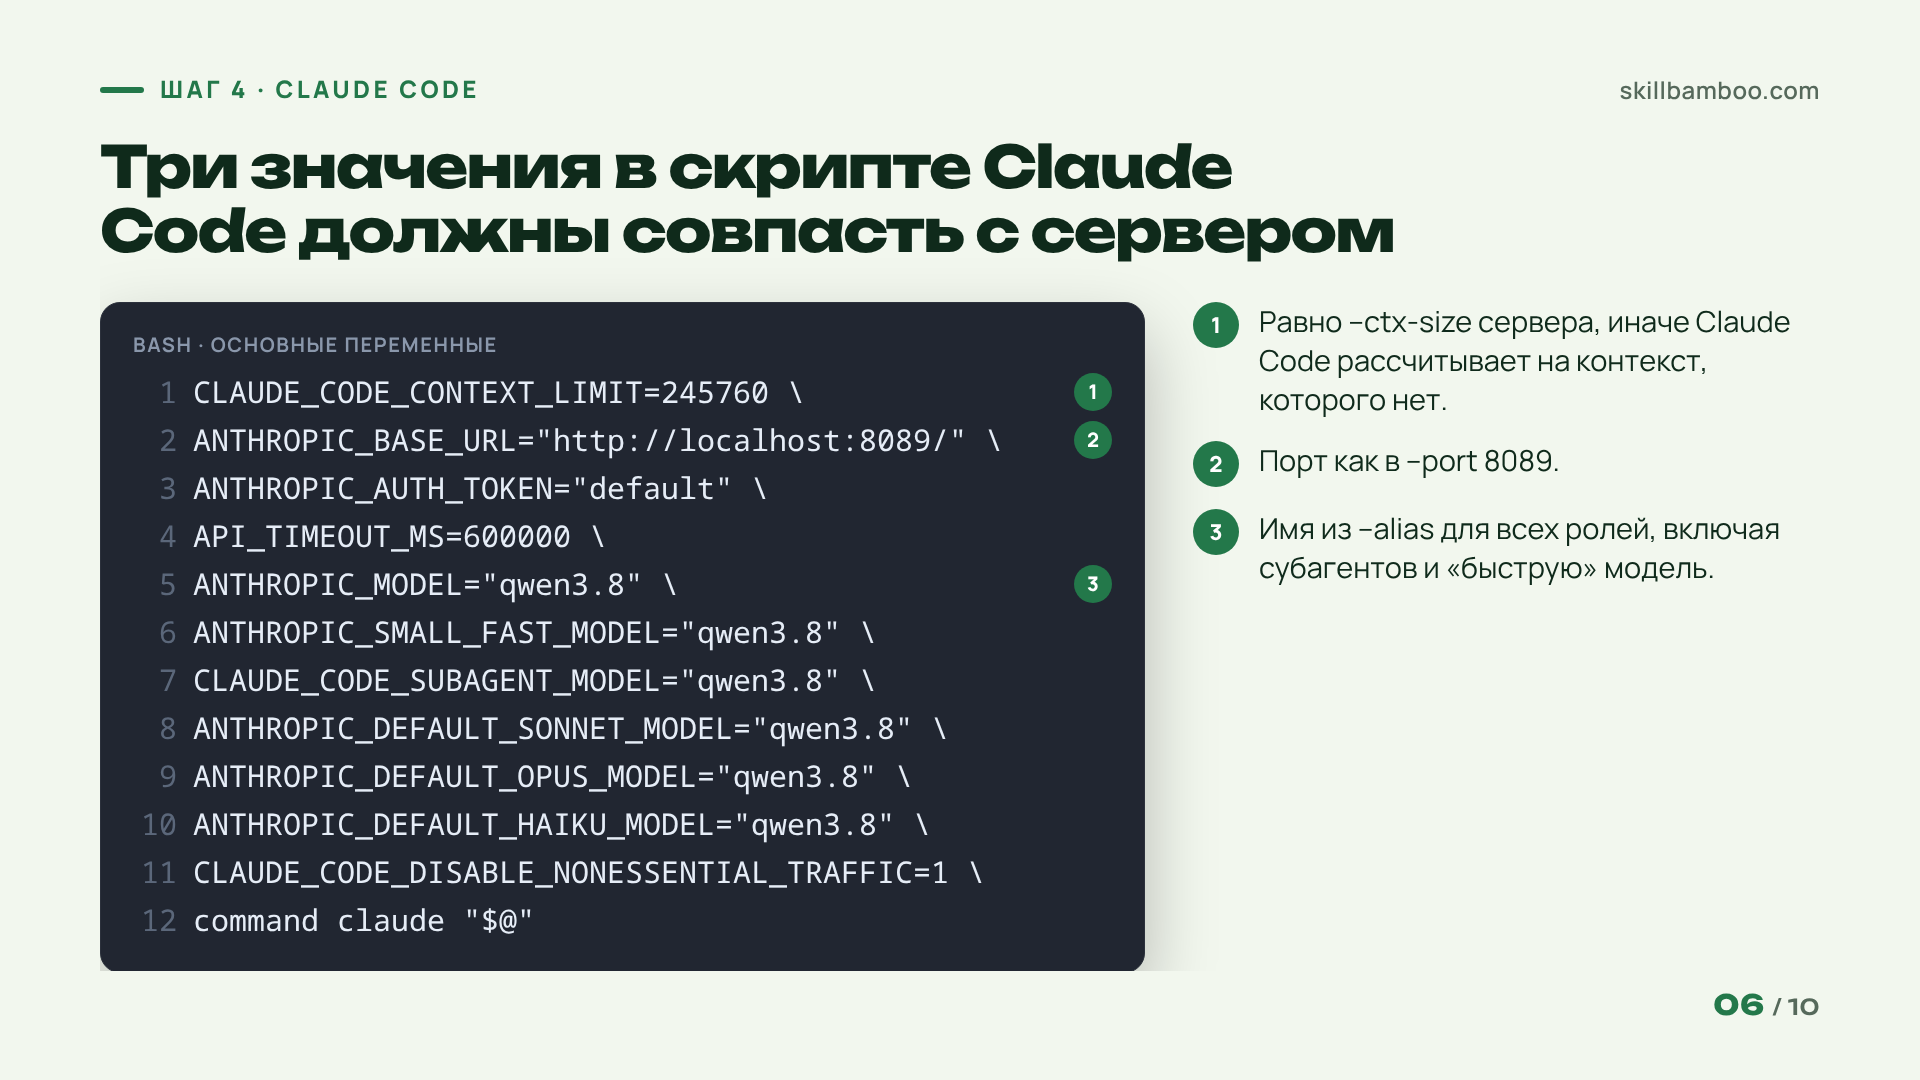
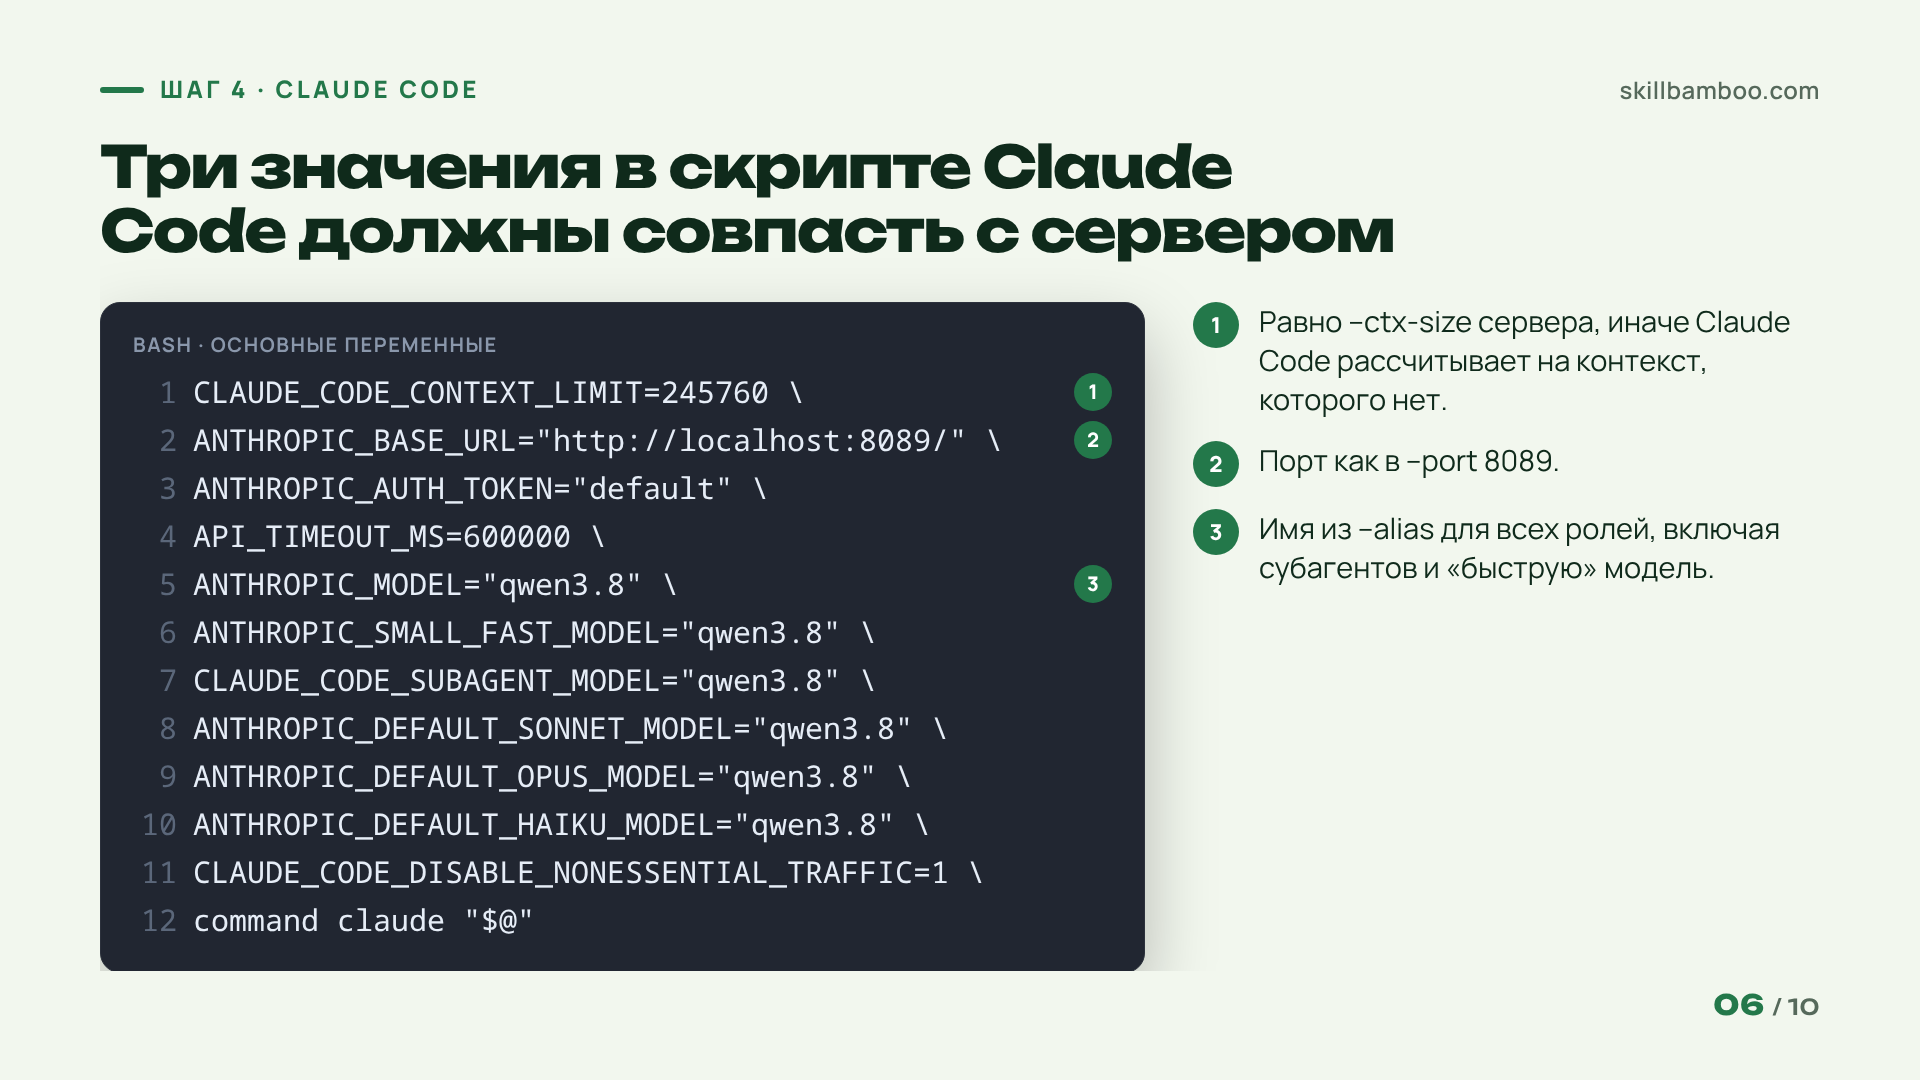
Claude Code умеет ходить не в облако, а в совместимый сервер, достаточно переменных окружения. Связка работает, но официально Anthropic не поддерживает подключение моделей не от Claude. Адрес http://localhost:8089/, лимит контекста 245 760, имя модели qwen3.8 для всех ролей, включая субагентов и «быструю» модель. Удобнее всего сохранить это как скрипт:
CLAUDE_CODE_CONTEXT_LIMIT=245760 \
AI_LOG_ENDPOINT="" \
ANTHROPIC_BASE_URL="http://localhost:8089/" \
ANTHROPIC_AUTH_TOKEN="default" \
ANTHROPIC_CUSTOM_HEADERS="Plugin-Type: claude-code" \
API_TIMEOUT_MS=600000 \
ANTHROPIC_MODEL="qwen3.8" \
ANTHROPIC_SMALL_FAST_MODEL="qwen3.8" \
CLAUDE_CODE_SUBAGENT_MODEL="qwen3.8" \
ANTHROPIC_DEFAULT_SONNET_MODEL="qwen3.8" \
ANTHROPIC_DEFAULT_OPUS_MODEL="qwen3.8" \
ANTHROPIC_DEFAULT_HAIKU_MODEL="qwen3.8" \
CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1 \
CLAUDE_CODE_LOG_LEVEL=debug \
ENABLE_LSP_TOOL=1 \
command claude "$@"
Три значения должны совпадать с запуском сервера: размер контекста, порт в адресе и имя модели из --alias. Разойдётся хоть одно, и Claude Code либо не найдёт модель, либо будет рассчитывать на контекст, которого нет.
В итоге получаем полноценный Claude Code на локальной модели: он разбирает и пишет код, пользуется инструментами и подолгу работает автономно, не зависая и не сыпля ошибками. Прикольно, и всё на своей карте.
Сколько это даёт: замеры против обычной llama.cpp
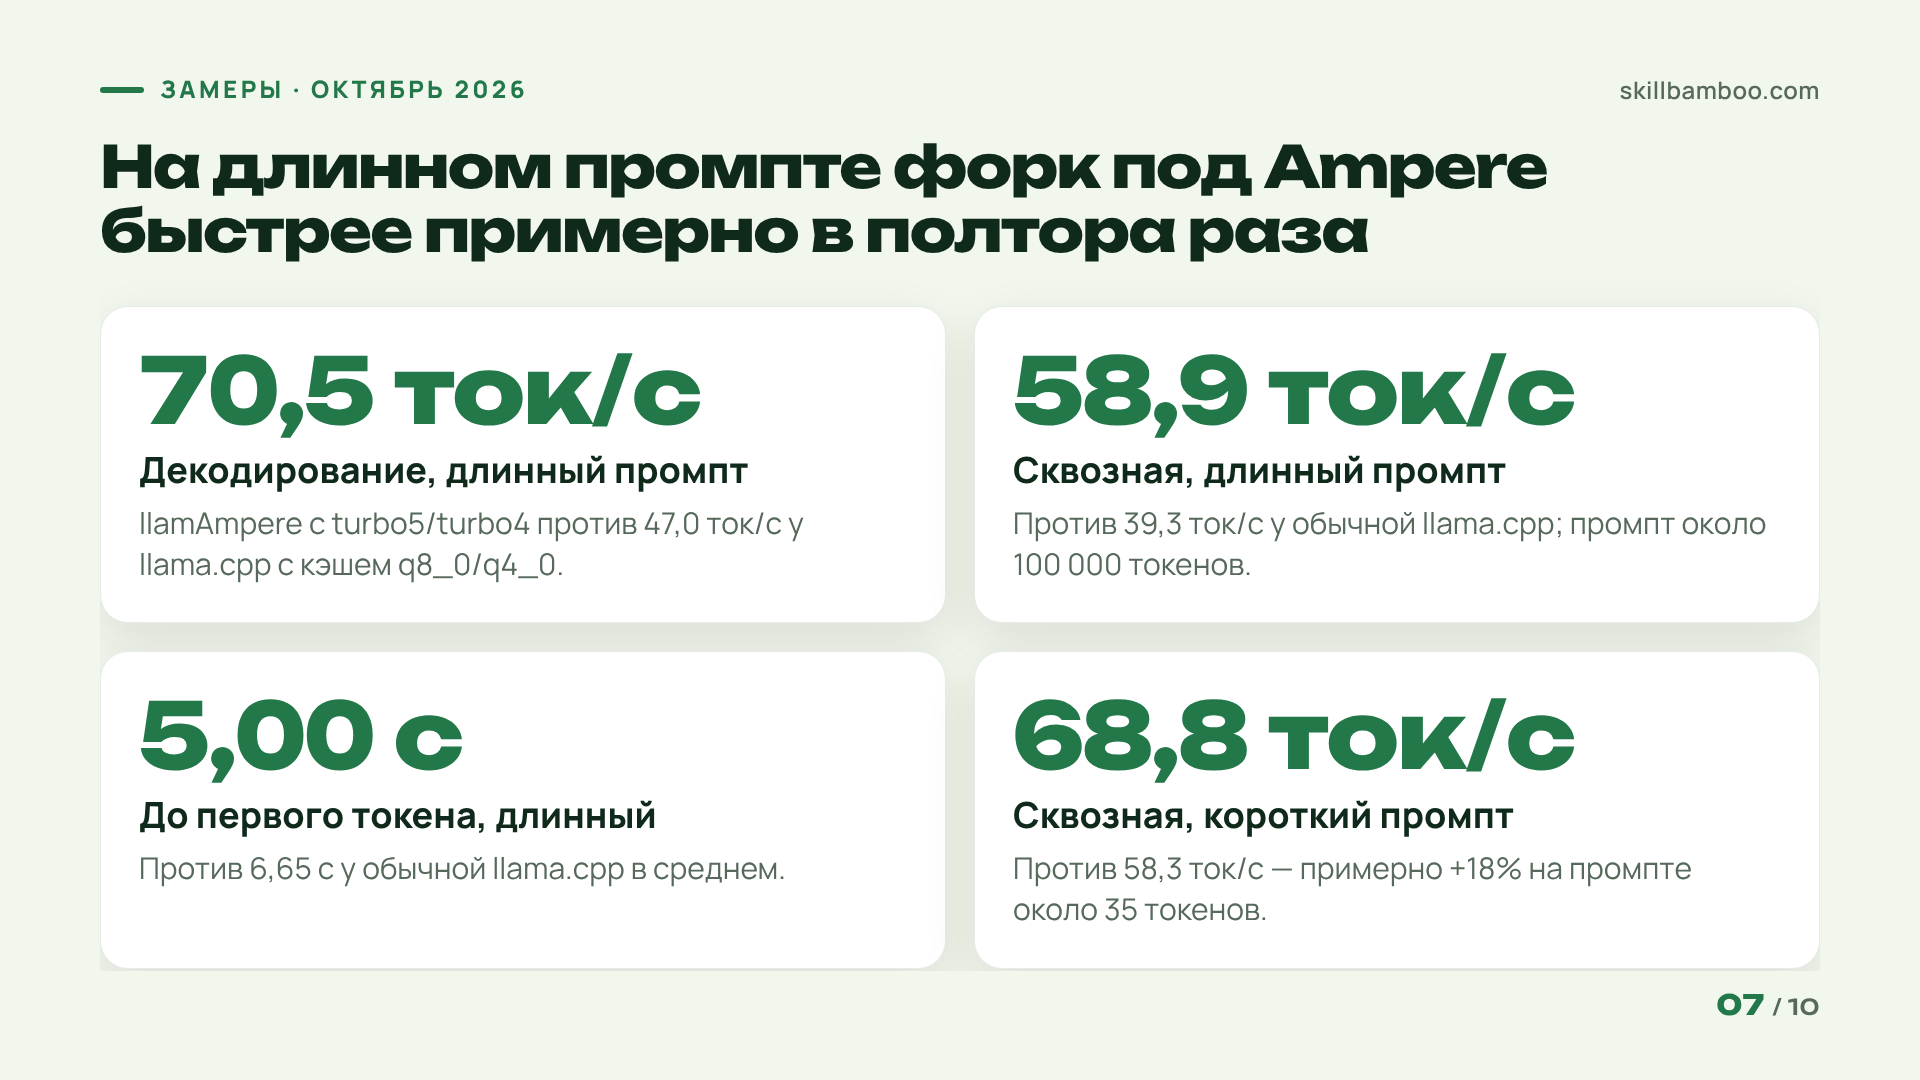
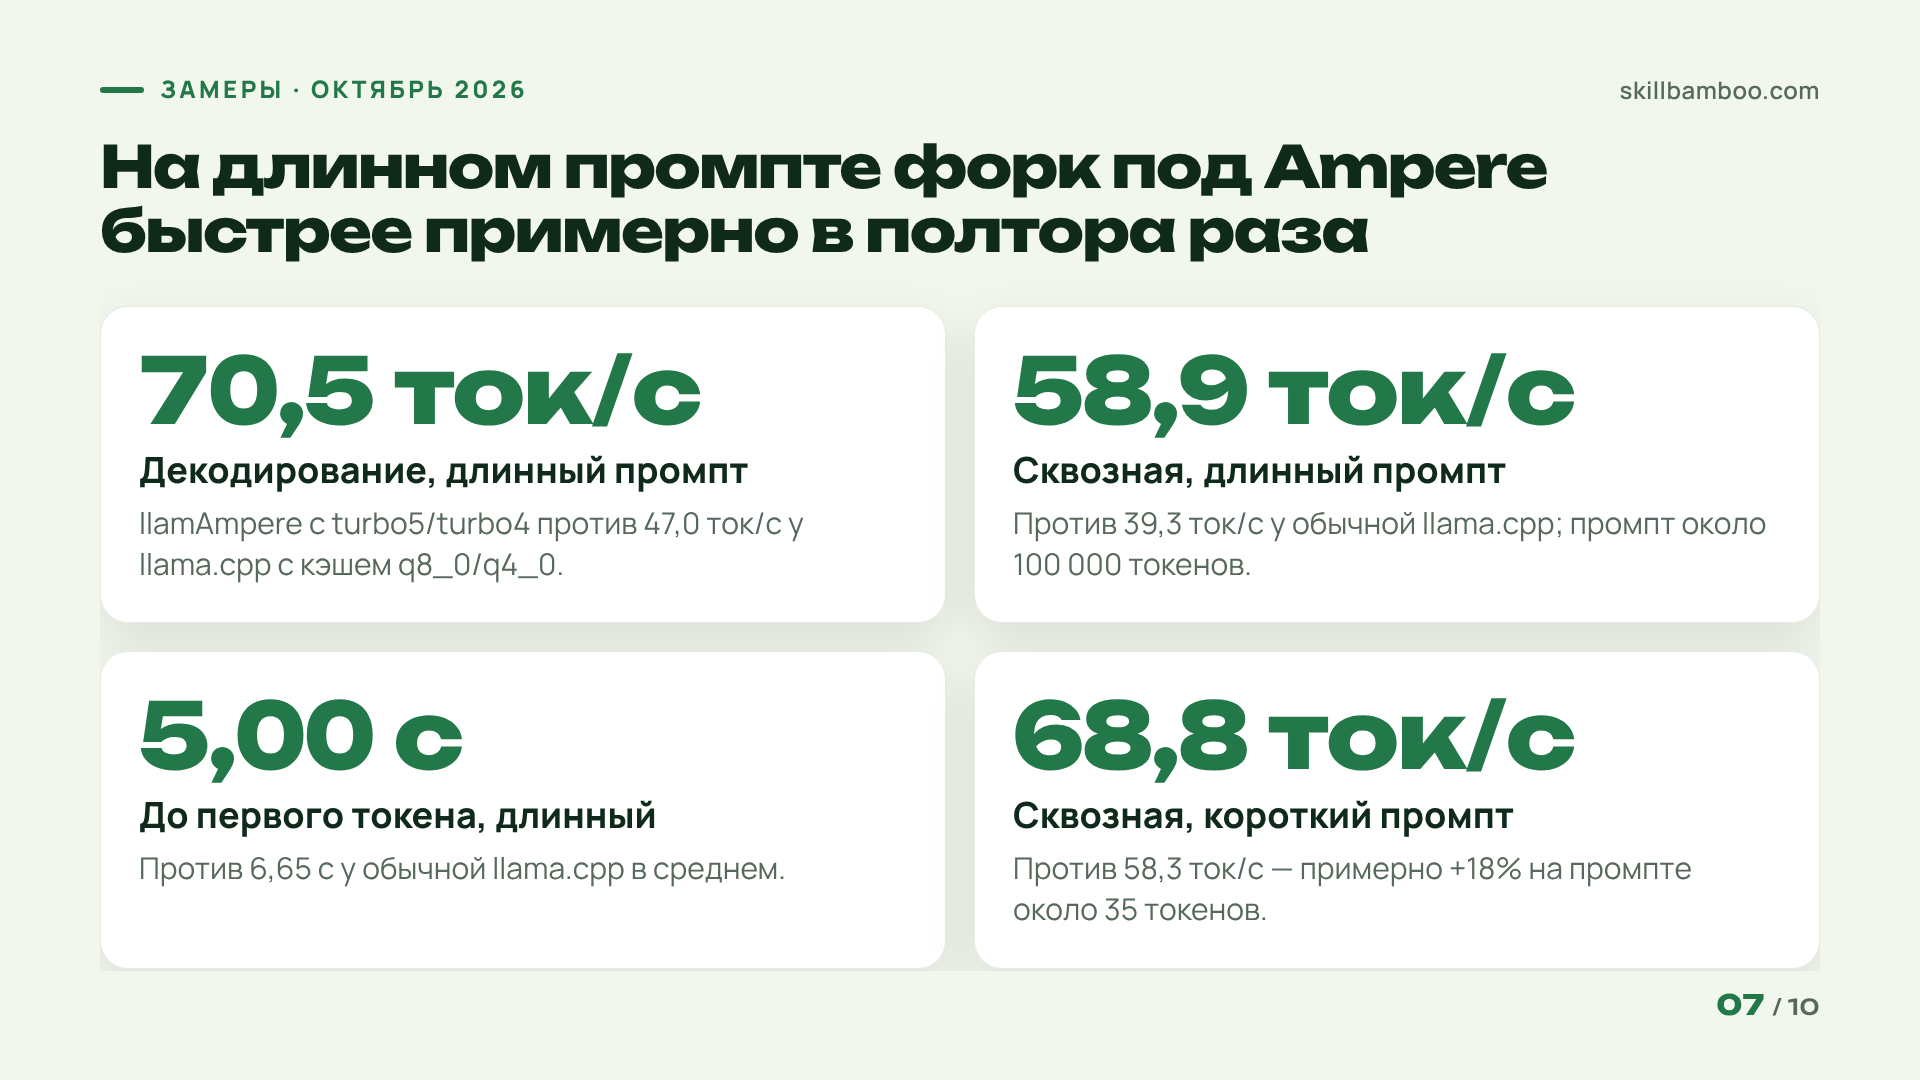
Для сравнения ту же Qwen запускали в обычной llama.cpp. Типов кэша turbo5 и turbo4 там нет, поэтому кэш был в q8_0 и q4_0. Скорость проверяли на двух промптах: коротком, около 35 токенов, и длинном, около 100 000 токенов. Средние по замеру на октябрь 2026 года:
| Движок · модель · KV-кэш | Промпт | До первого токена | Декодирование | Сквозная скорость |
|---|---|---|---|---|
| llamAmpere · Qwen 3.8 27B IQ4_XS · turbo5/turbo4 | короткий | 2,66 с | 79,1 ток/с | 68,8 ток/с |
| llama.cpp · Qwen 3.8 27B IQ4_XS · q8_0/q4_0 | короткий | 3,20 с | 67,4 ток/с | 58,3 ток/с |
| llamAmpere · Qwen 3.8 27B IQ4_XS · turbo5/turbo4 | длинный | 5,00 с | 70,5 ток/с | 58,9 ток/с |
| llama.cpp · Qwen 3.8 27B IQ4_XS · q8_0/q4_0 | длинный | 6,65 с | 47,0 ток/с | 39,3 ток/с |
На коротком промпте выигрыш скромный: сквозная скорость около 69 против 58 ток/с, это примерно +18%. На длинном разница уже ощутимая: 58,9 против 39,3 ток/с сквозной и 70,5 против 47,0 на декодировании, примерно в полтора раза. То есть для агента, который как раз живёт на длинном контексте, важна именно вторая строка.
Почему агенту важнее всего кэш
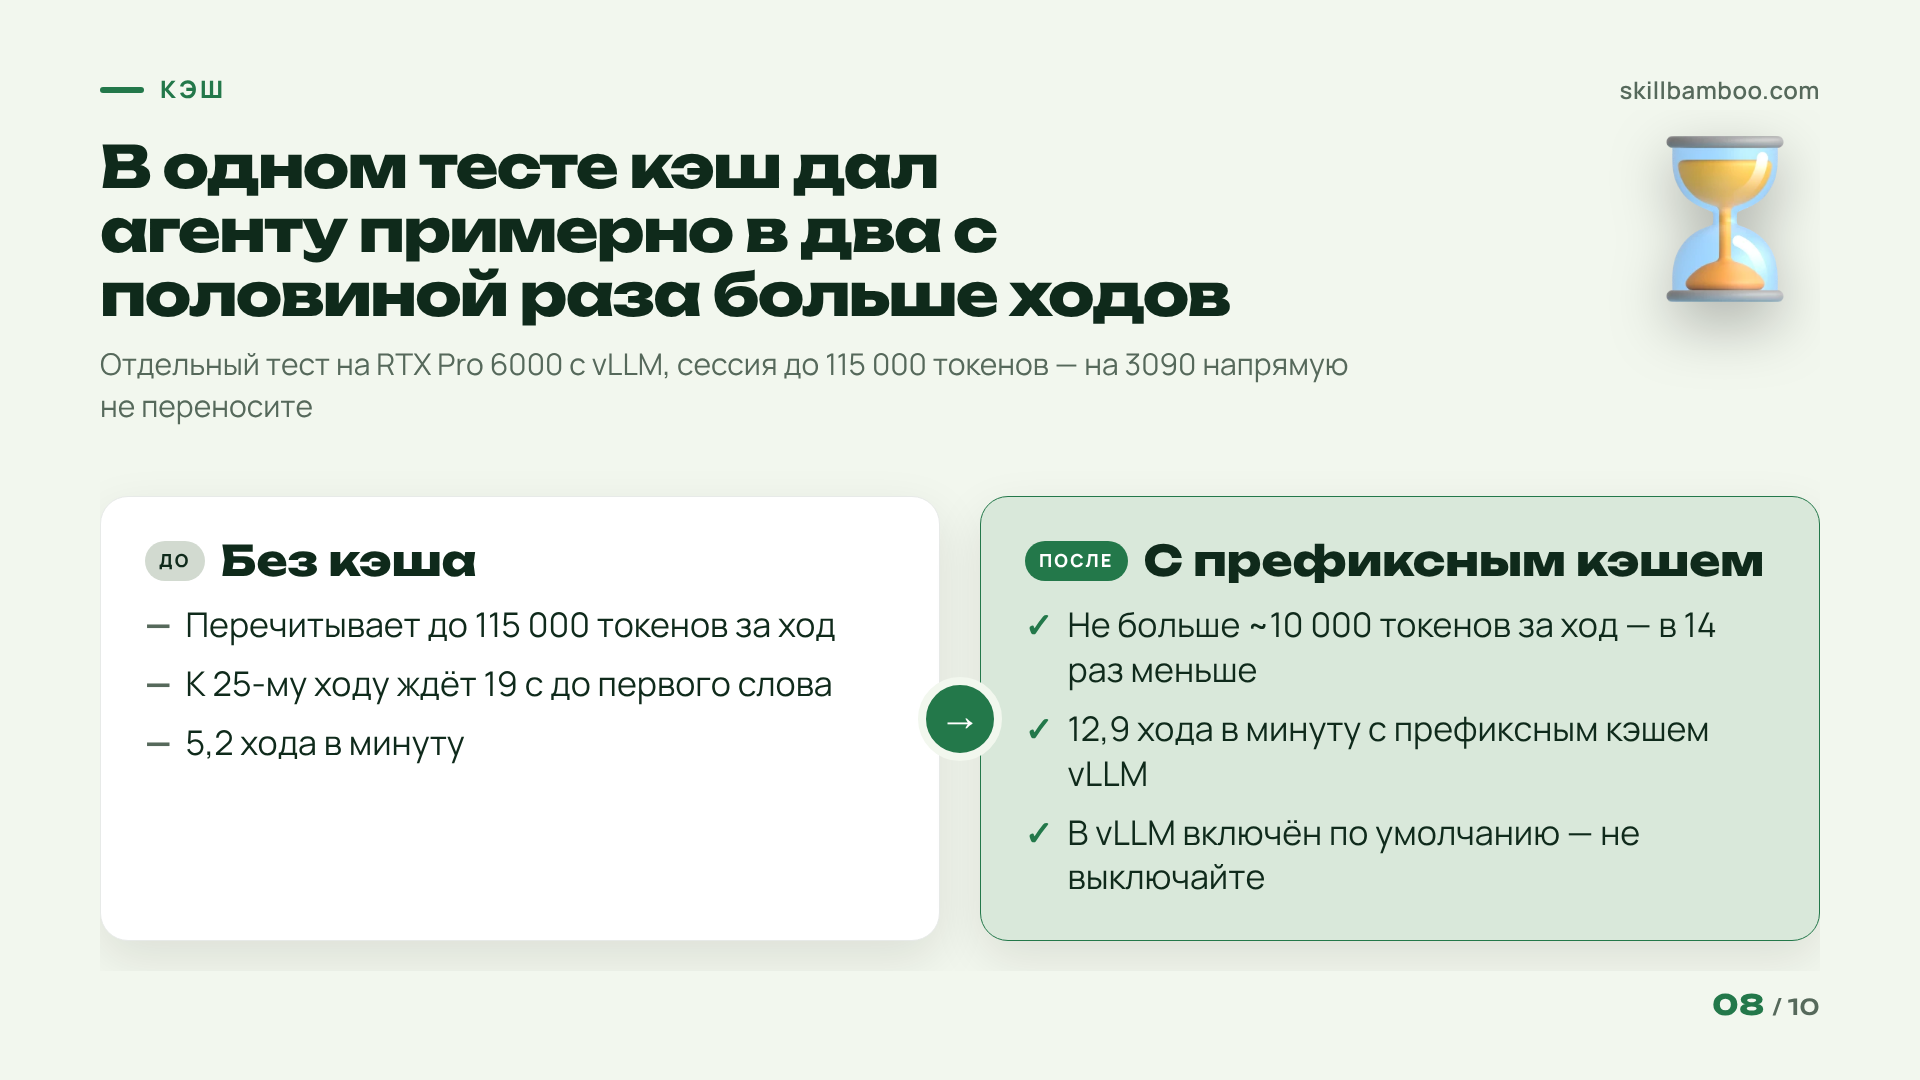
Движок даёт до полутора раз. Кратная разница для агента появляется в другом месте, в кэше. Агент на каждом ходу отправляет модели всю историю сессии, и без кэша модель её каждый раз перечитывает. В одном замере агентской сессии к 25-му ходу модель ждала 19 секунд, прежде чем написать первое слово.
Цифры этого замера взяты из отдельного теста на профессиональной RTX Pro 6000 с vLLM, где сессия разрасталась до 115 000 токенов. На вашу 3090 их напрямую не переносите, но механику они показывают хорошо:
- без кэша агент к концу сессии перечитывает 115 000 токенов за ход, а за всю сессию больше 2 млн;
- с префиксным кэшем он читает за ход не больше примерно 10 000 токенов (в 14 раз меньше, около 7% промпта);
- один агент без кэша делал 5,2 хода в минуту, с префиксным кэшем vLLM 12,9, с LMCache 12,8, то есть примерно в два с половиной раза больше.
Если вы работаете в vLLM, префиксный кэш там включён по умолчанию, не выключайте его. Когда всё помещается в видеопамять, больше ничего не нужно. Внешний кэш-сервер вроде LMCache хранит заметки вне vLLM, в оперативной памяти и даже на NVMe-дисках, и кэш переживает перезапуск модели. Цена: больше компонентов, более медленные перезапуски и сложности с настройкой на новых моделях.
Не делите карту с тяжёлыми запросами
Если запрос с кэшем обрабатывается на GPU вместе с большим запросом без кэша, выигрыш во многом теряется. Так что одному агенту лучше не делить карту с другими тяжёлыми запросами; в команде запуска выше и так стоит --parallel 1.
И трезвая оговорка: кэш не делает агента умнее. Он лишь избавляет модель от повторного чтения одного и того же.
Ключевые термины
- KV-кэш – Сохранённые промежуточные данные, которые модель получает при чтении промпта и переиспользует, чтобы не обрабатывать тот же текст заново.
- Префиксный кэш – Переиспользование KV-кэша, когда новый запрос начинается так же, как предыдущий, – например, при очередном ходе агента.
- Chat template – Шаблон, по которому сервер превращает диалог и вызовы инструментов в текст для модели; от него зависит, поймёт ли модель клиента вроде Claude Code.
- llamAmpere – Форк llama.cpp, оптимизированный под видеокарты NVIDIA поколения Ampere.
- TTFT – Время от отправки запроса до первого токена ответа.
- Сквозная скорость (e2e) – Скорость генерации в токенах в секунду с учётом всего времени с момента отправки запроса, включая обработку промпта.
Итог: что получилось и чего ждать
Весь путь укладывается в четыре пункта:
- Собрать llamAmpere под архитектуру 86
- Скачать квант IQ4_XS на 15 ГБ и исправленный
chat_template.jinja - Запустить llama-server с контекстом 245 760 и кэшем turbo5/turbo4
- Направить Claude Code на
localhost:8089скриптом с переменными
Что у вас теперь есть
У вас локальный кодинг-агент на RTX 3090: Qwen 3.8 27B декодирует около 79 ток/с на коротком промпте и около 70 ток/с на длинном, а Claude Code работает с ней без подписки за счёт переменной ANTHROPIC_AUTH_TOKEN в скрипте запуска. Движок под Ampere даёт примерно +18% на коротких запросах и около полутора раз на длинных. Следующий рычаг это кэш: следите, чтобы видеопамяти хватало на контекст, и не нагружайте карту параллельными тяжёлыми запросами. Умнее агент от этого не станет, зато ждать ответа с каждым ходом будет не дольше.
На этом все.
Проверьте себя
1. Вы скачали Qwen 3.8 27B из официального репозитория, сервер запускается, но Claude Code с моделью не работает. Что проверить в первую очередь?
- А. Увеличить размер контекста
- Б. Подключить исправленный chat template через --chat-template-file
- В. Купить карту с большим объёмом памяти
Показать ответ
Ответ: Б. Со встроенным шаблоном модели Claude Code не работает, исправленный шаблон решает проблему.
2. На длинном контексте обычная llama.cpp выдаёт около 47 ток/с декодирования на RTX 3090. Что из этого даст прирост на той же карте?
- А. Сборка движка, оптимизированного под Ampere, со сжатыми типами KV-кэша
- Б. Включение сервера на 0.0.0.0
- В. Увеличение параметра --parallel
Показать ответ
Ответ: А. llamAmpere на тех же условиях декодирует около 70 ток/с.
3. Почему агент с каждым ходом начинает отвечать всё позже?
- А. Видеокарта перегревается и сбрасывает частоты
- Б. История растёт, и без кэша модель каждый ход перечитывает весь промпт
- В. Модель с каждым ходом рассуждает дольше
Показать ответ
Ответ: Б. Без кэша к концу сессии модель перечитывает до 115 000 токенов за ход.
4. Модель весит 15 ГБ, а у карты 24 ГБ. Зачем нужен запас видеопамяти?
- А. Под KV-кэш: при его переполнении старые записи вытесняются и модель перечитывает всё заново
- Б. Запас не нужен, его можно отдать под модель побольше
- В. Под копию весов для ускорения
Показать ответ
Ответ: А. Кэш живёт в видеопамяти рядом с моделью и получает только остаток.
5. Когда имеет смысл ставить отдельный кэш-сервер вроде LMCache?
- А. Когда работает один агент и всё помещается в видеопамять
- Б. Всегда – он делает модель умнее
- В. Когда кэш не помещается в видеопамять или нужно, чтобы он пережил перезапуск сервера модели
Показать ответ
Ответ: В. LMCache хранит кэш вне сервера модели – в RAM и на NVMe.