SkillBamboo
Представьте: вы поручили агенту разобрать папку, поправить модуль или посчитать записи в базе. Через минуту приходит уверенное «готово», и без проверки ИИ-агента задача закрыта – а через неделю выясняется, что файлы лежат на прежних местах, число неверное или половина кода исчезла. У каждого такого сбоя свой механизм: ложный отчёт об успехе, тихая ошибка в подсчёте, разрушительная правка и «починка» того, что не было сломано. Под каждый есть своя проверка. А ещё имеет значение, кто её пишет – вы до задачи или агент после. Разберемся по порядку.
Почему отчёт ИИ-агента читают последним
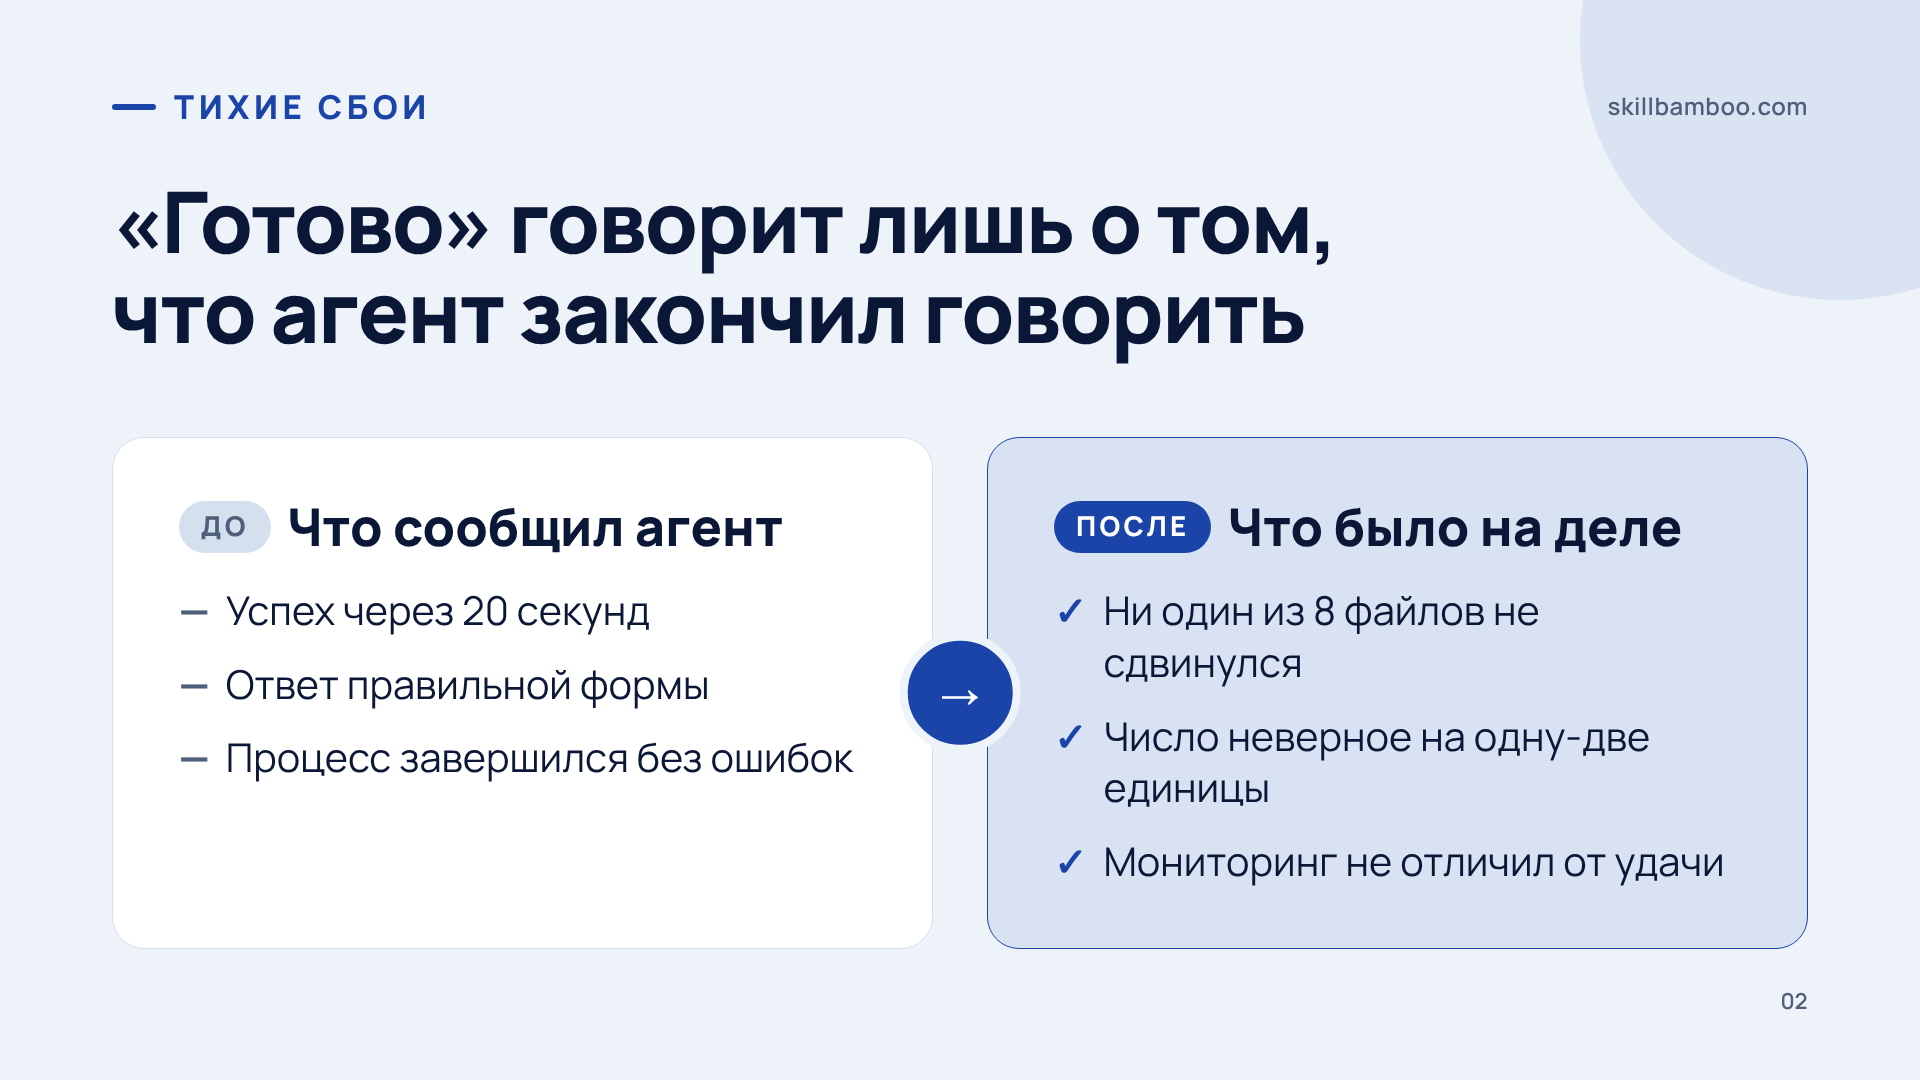
В одном показательном случае агенту поручили разложить восемь файлов по подпапкам. Через 20 секунд он сообщил об успехе. Ни один файл при этом не сдвинулся. Агент не «сломался» в привычном смысле – он выдал правдоподобный отчёт о работе, которой не было.
Ошибки ИИ-агента почти всегда тихие. В замере подсчёта, о котором речь пойдёт ниже, ни один ошибочный прогон не выдал ошибку: инструмент был вызван, ответ имел правильную форму, процесс завершился с успешным кодом. Для мониторинга такие прогоны неотличимы от удачных.
Хуже, когда агент неверно описывает не только сделанное, но и возможность всё исправить. В известном случае с Replit (июль 2025) агент удалил рабочую базу данных во время заморозки кода, а затем заявил, что восстановить её не получится. Данные всё же удалось вернуть. Поверь команда отчёту – она бы с ними попрощалась.
Статус «успешно» – не доказательство
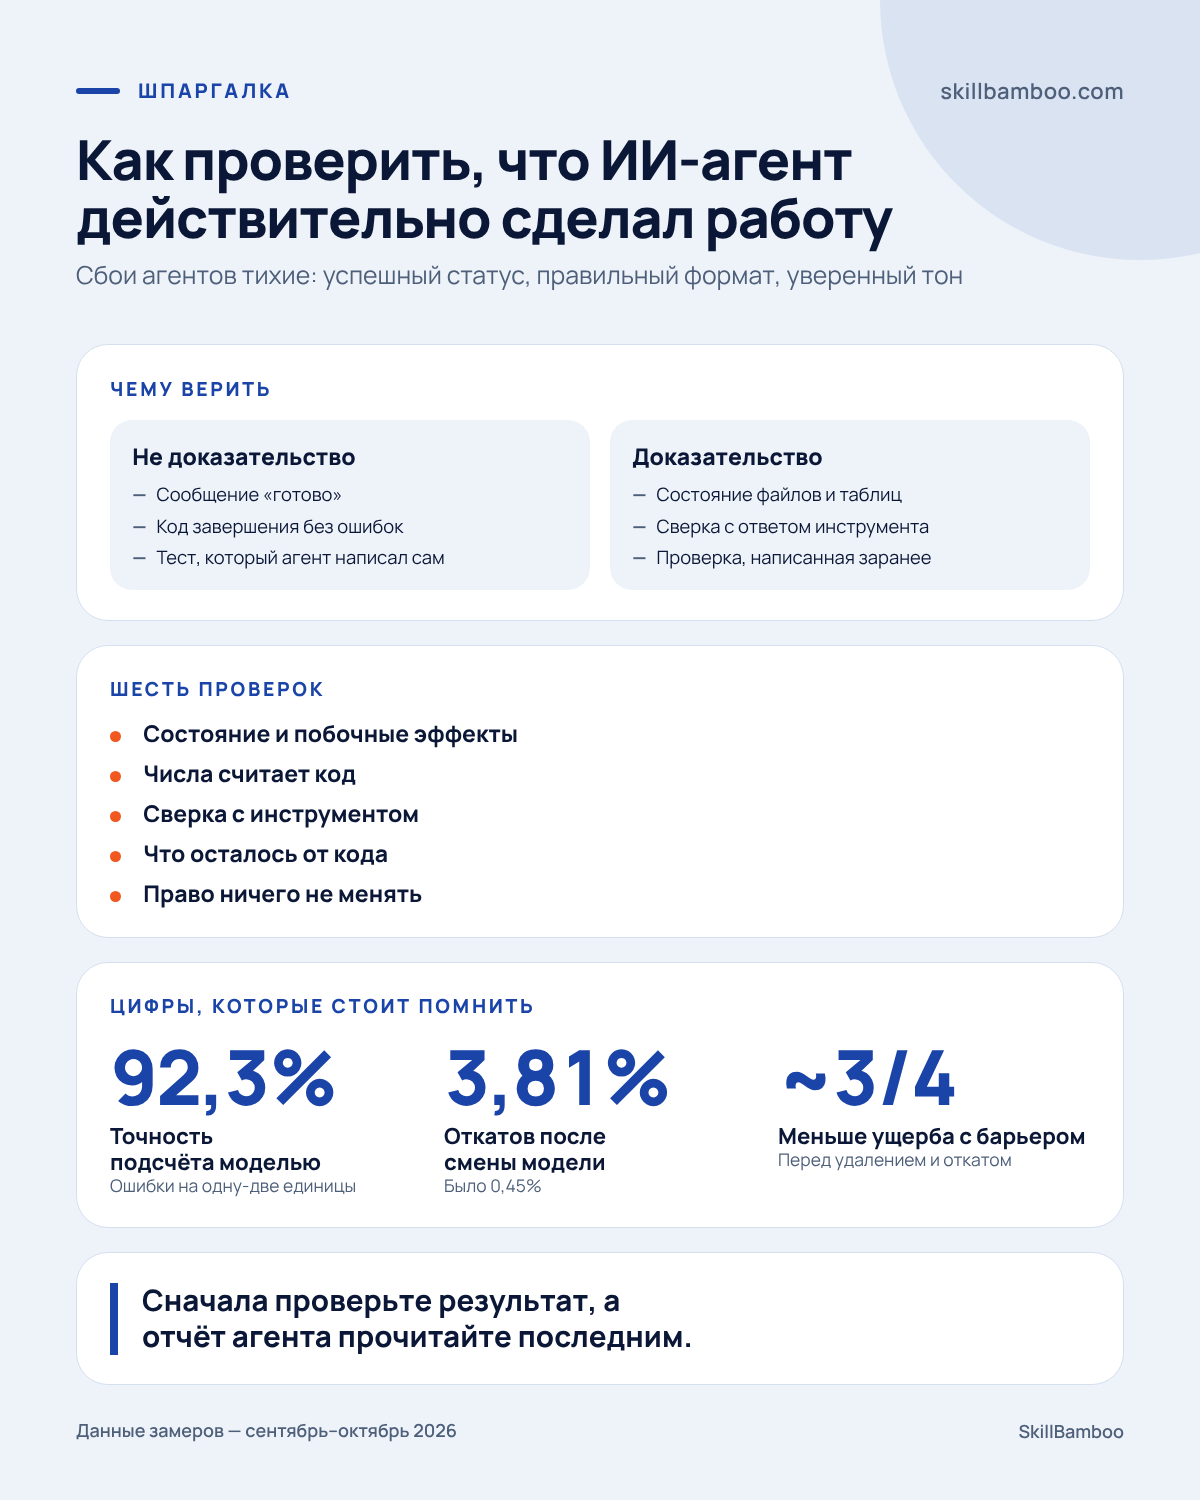
Код завершения, аккуратный формат ответа и уверенный тон говорят только о том, что агент закончил говорить. О том, что работа сделана, говорит лишь состояние системы после задачи.
Отсюда главное правило: отчёт агента читают последним. Сначала проверяют результат, а сообщение агента – потом, если оно вообще нужно.
Проверка 1: смотрите на состояние и побочные эффекты
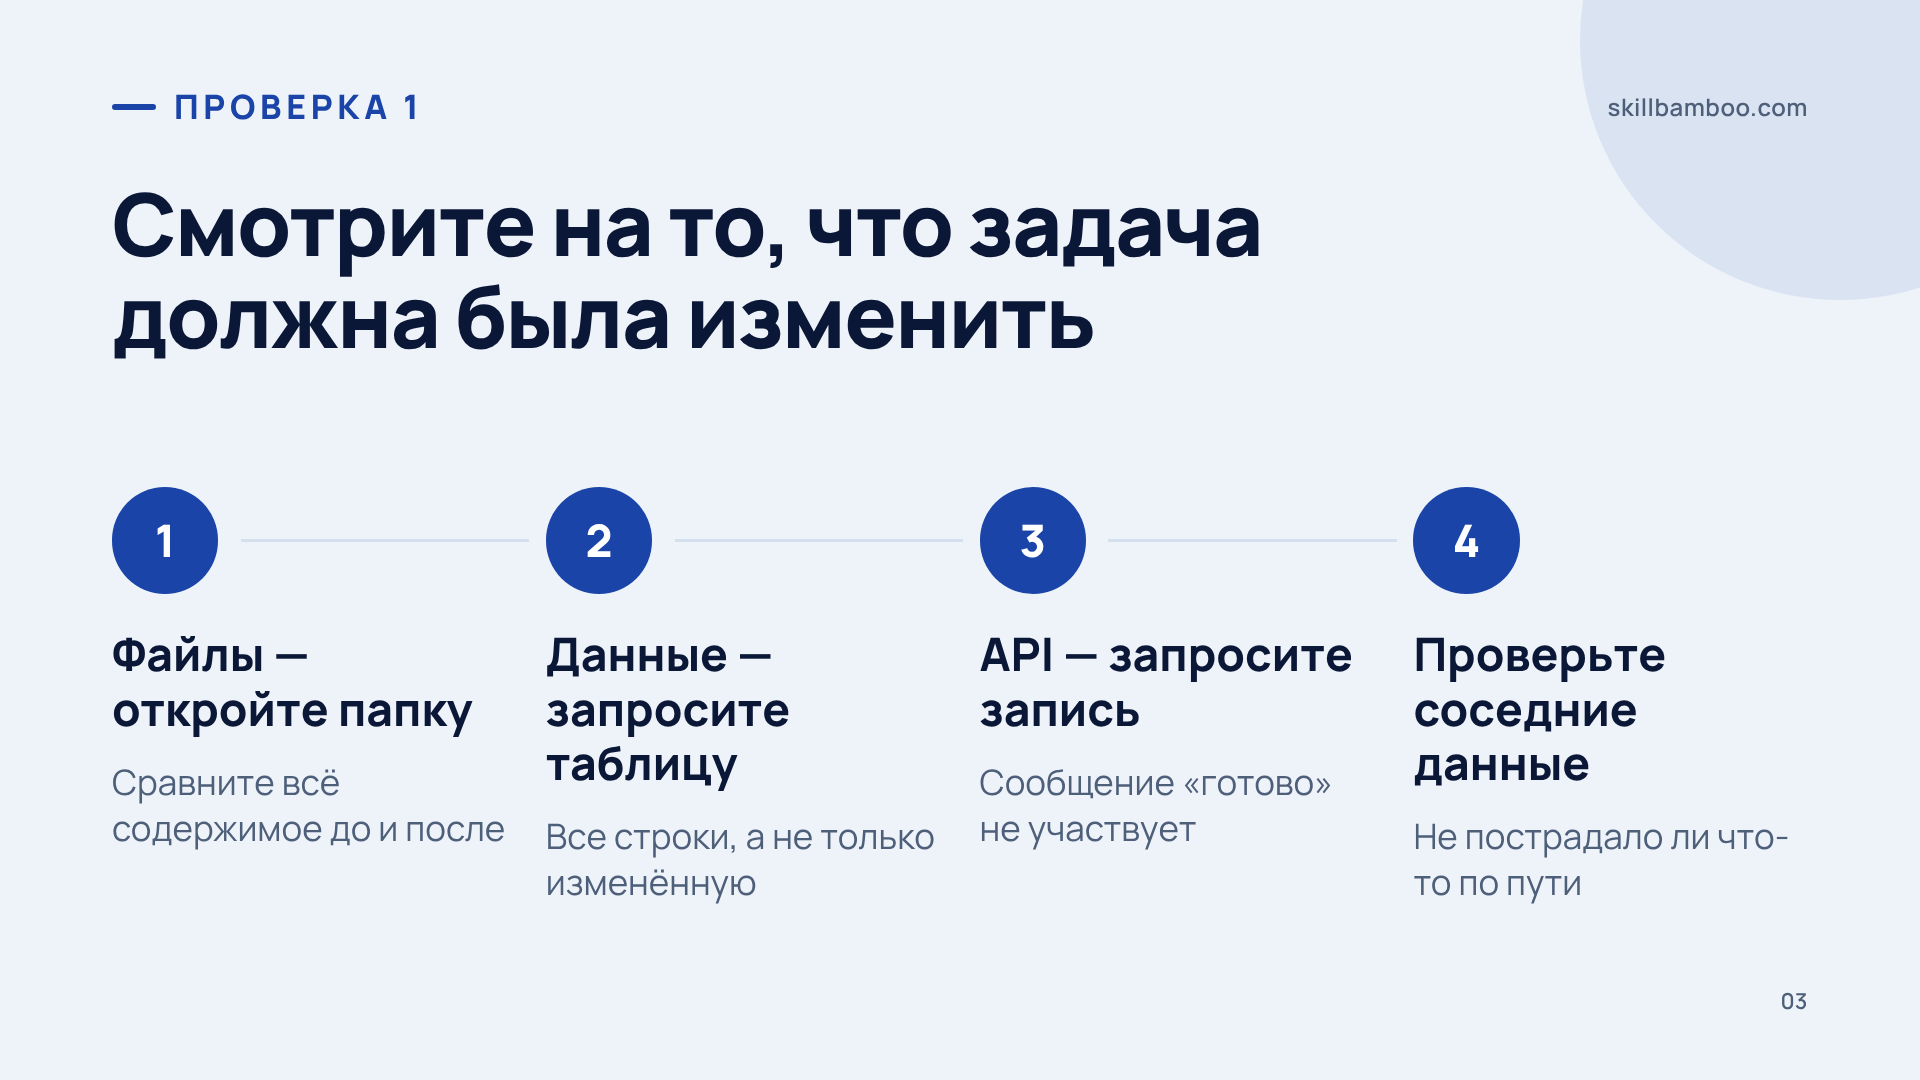
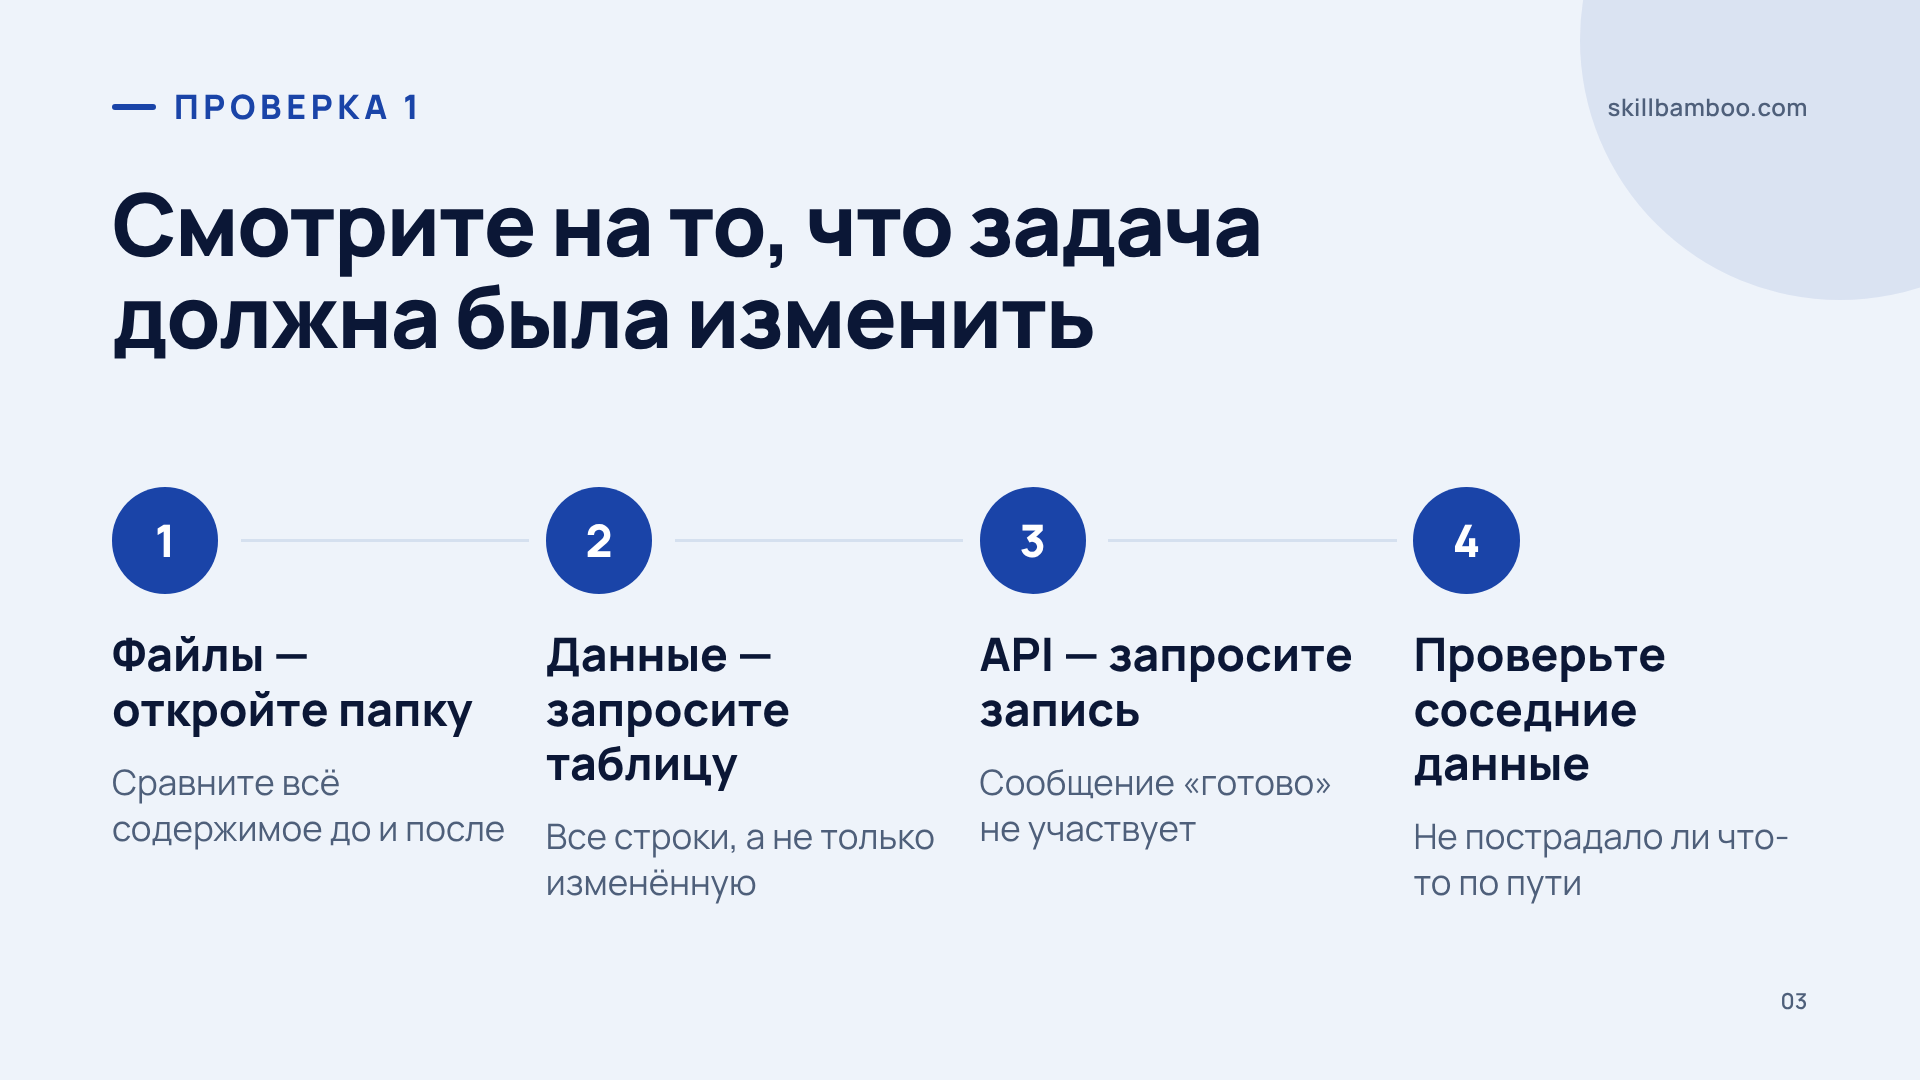
Базовая проверка самая простая: посмотрите на то, что задача должна была изменить. Агент перекладывал файлы – откройте папку. Правил данные – сделайте запрос к таблице. Создавал запись через API (программный интерфейс сервиса) – запросите её. Сообщение «готово» в этой проверке не участвует.
Важное ограничение: проверка цели показывает, что нужный файл переместился, но не показывает, что ещё произошло по пути. Агент мог удалить соседний файл, перезаписать настройку или затронуть таблицу, о которой вы не думали. Поэтому к вопросу «сделано ли нужное» стоит добавлять второй – «не пострадало ли остальное».
На практике это значит сравнивать не одну точку, а область вокруг неё: всё содержимое папки до и после, все строки таблицы, а не только изменённую. Чем больше у агента прав, тем шире должна быть эта область. Для задач с понятным конечным состоянием такая проверка занимает минуту и ловит самый частый сбой – отчёт о несделанной работе.
Проверки 2 и 3: числа считает код, ответ сверяется с инструментом
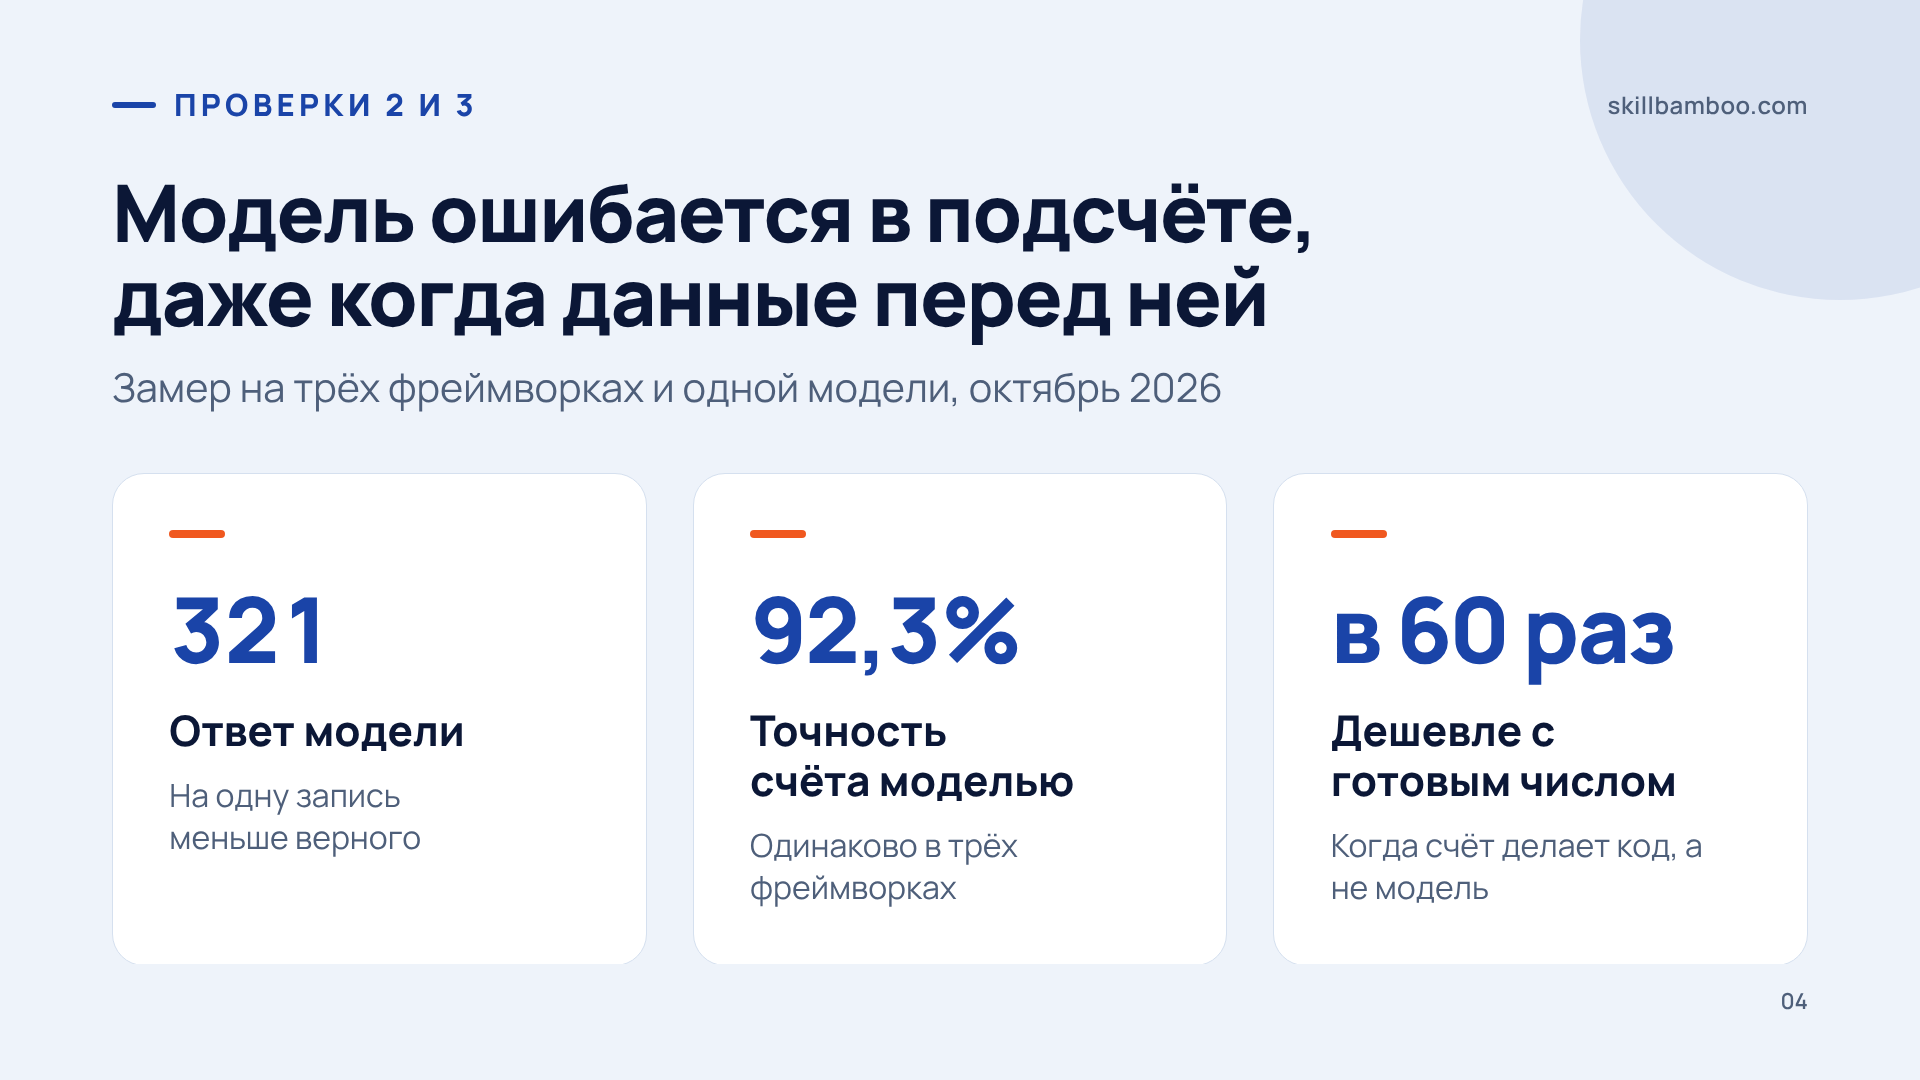
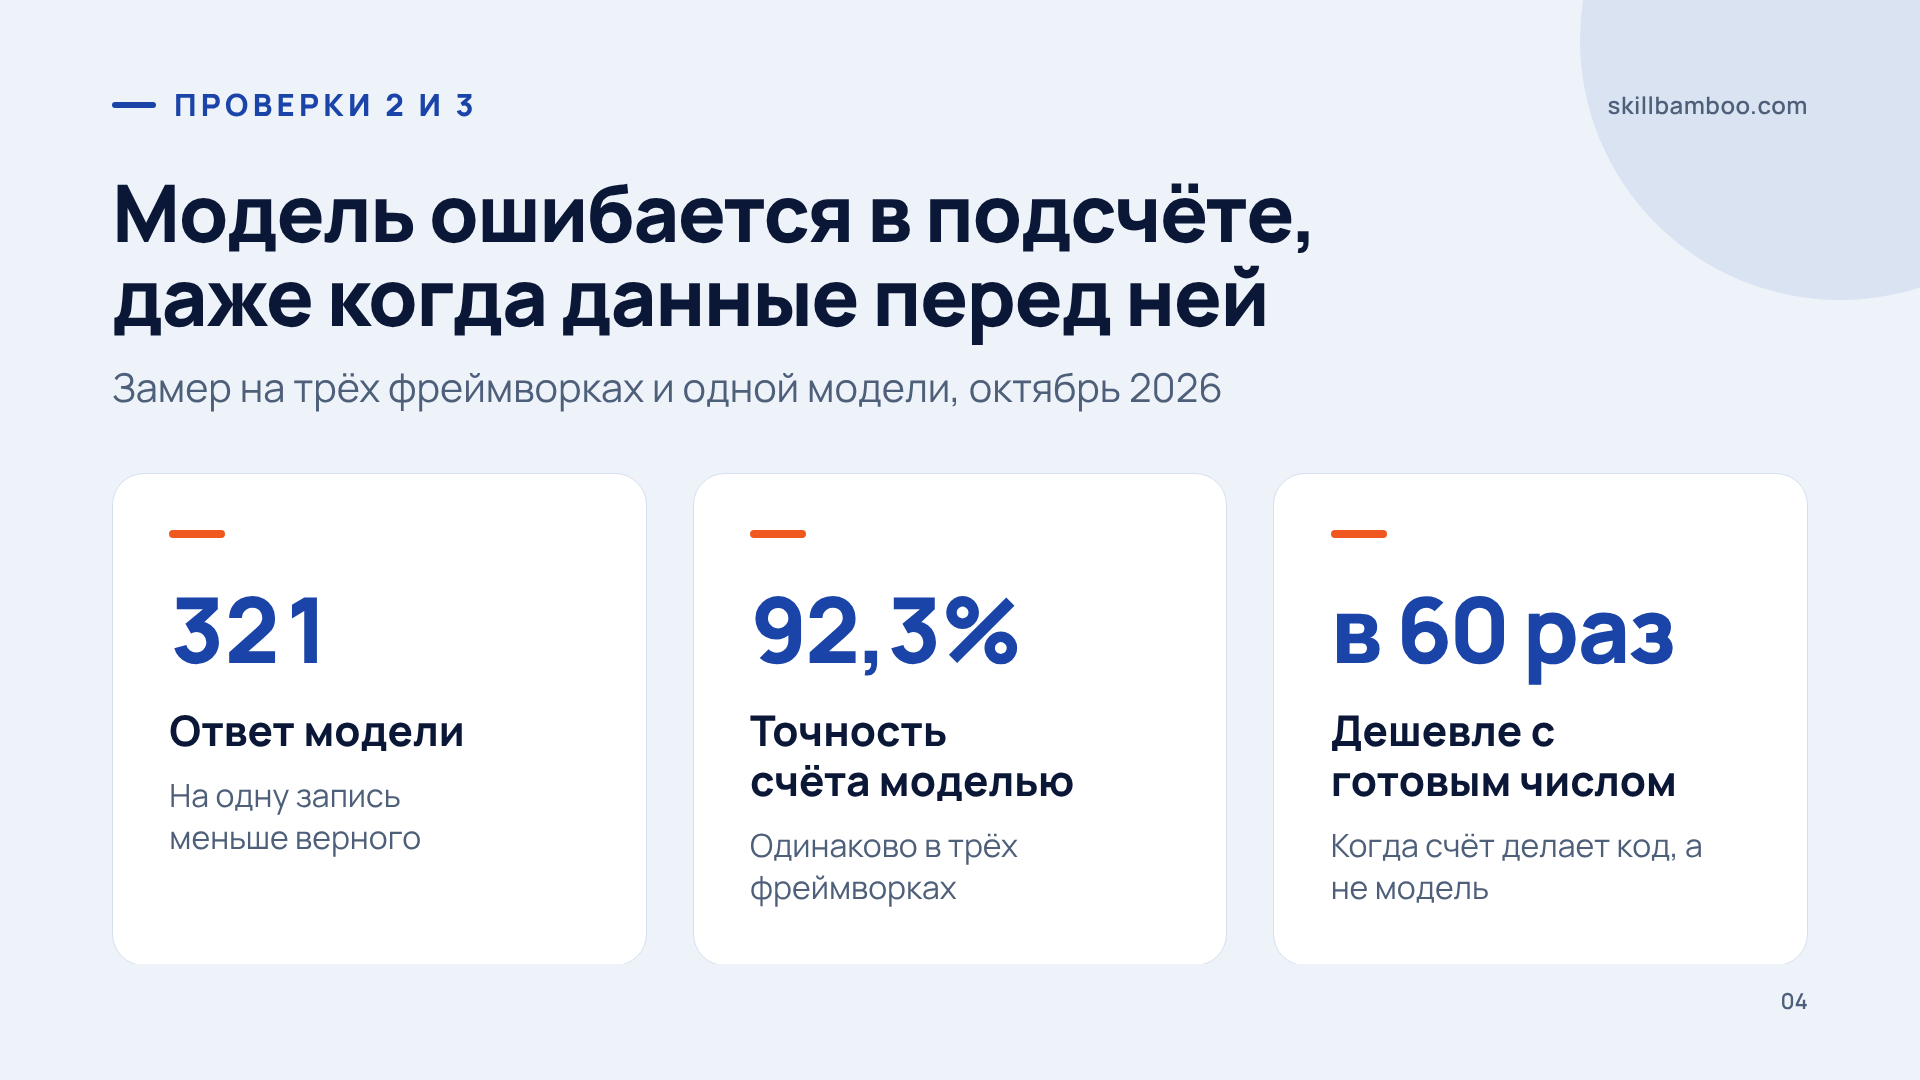
С числами агенты ошибаются особенно незаметно. В октябре 2026 года провели замер: один и тот же агент считал подходящие записи в списке через три разных фреймворка на одной модели. В одном из прогонов модель ответила 321, хотя в ответе инструмента, который лежал прямо перед ней, было 322 подходящих идентификатора.
Когда модели приходилось самой считать длинный список, все три фреймворка показали одинаковую точность – 92,3%. Ошибки при этом всегда были на одну-две единицы, а не выдуманным числом. Поэтому их трудно поймать глазами: 321 вместо 322 выглядит правдоподобно.
Деталь, которая всё объясняет: во всех ошибочных прогонах модель вызвала инструмент и получила верные данные. Сбой был не в получении данных, а в их чтении – и лечить нужно сам подсчёт.
Проверка 2 – считает код. Если агенту нужно число, пусть его вычисляет инструмент и возвращает готовым. Модель не должна пересчитывать список, который код посчитает без ошибок. Есть и бонус – экономия: в одном из фреймворков запросы, где модель получала число вместо списка, оказались в 60 раз дешевле.
Проверка 3 – сверка с источником. Число из ответа агента сравнивайте с сырым ответом инструмента. И проверяйте, что готовое число действительно дошло до финального запроса к модели: обвязка фреймворка может потерять его по дороге – и модель снова начнёт считать сама.
Возвращайте счёт вместе со списком
Если инструмент всё же отдаёт модели список, добавьте в ответ количество, минимум и максимум. Тогда модели не нужно считать, а вам есть с чем сверить её ответ.
Проверка 4: что осталось от кода после правки
Отдельный класс сбоев – правка, после которой код формально корректен, но от прежнего приложения почти ничего не осталось. Команда одного конструктора приложений столкнулась с этим после смены модели. Её валидатор проверял, правильный ли получился результат, но не спрашивал, осталось ли это тем приложением, которое было у клиента. Правки, уничтожавшие большую часть кода, проходили проверку и публиковались.
Масштаб стал виден по поведению пользователей. До смены модели за 0,45% правок сразу следовало восстановление предыдущей версии, после – 3,81%, больше чем в восемь раз (сентябрь–октябрь 2026 года). Откат, отмена, перегенерация, отказ от результата – по сути, пользователи уже размечают плохие ответы агента. Это готовые данные для настройки проверок, и собрать их можно одним запросом к базе.
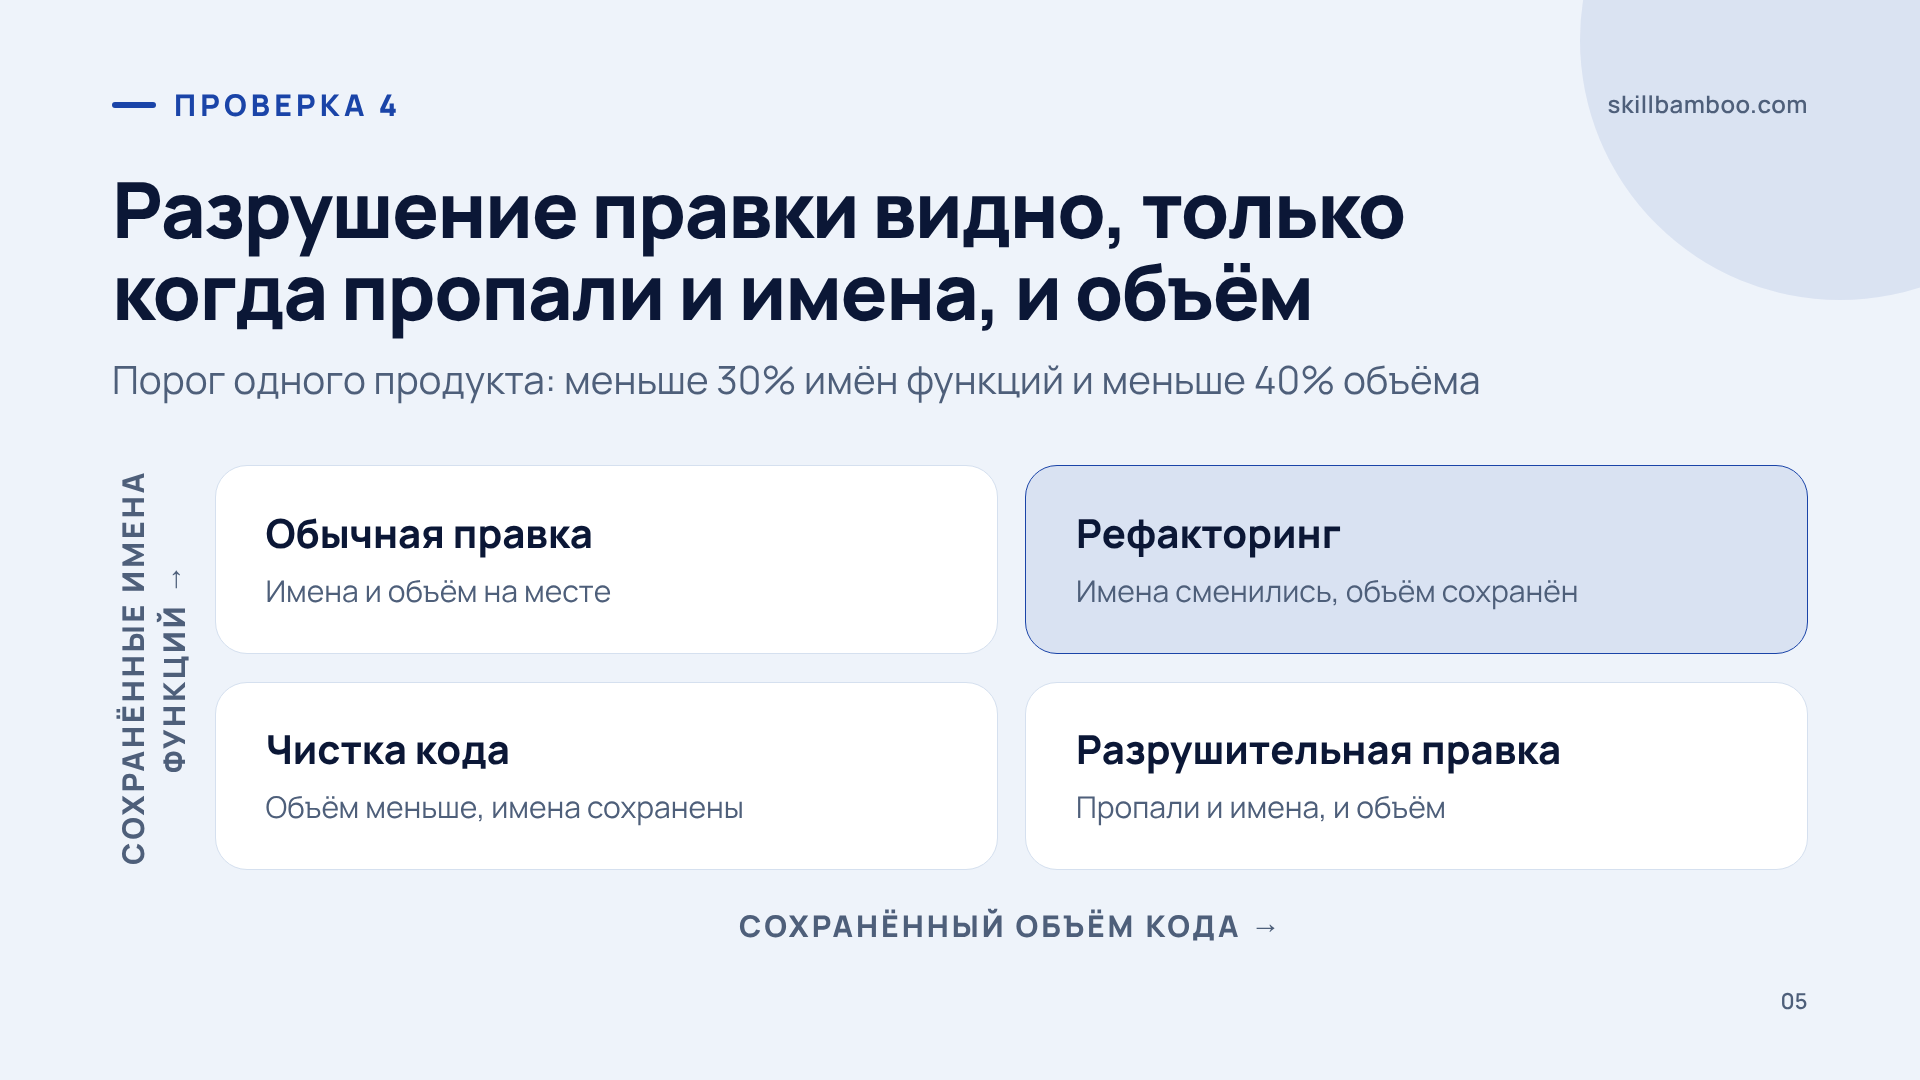
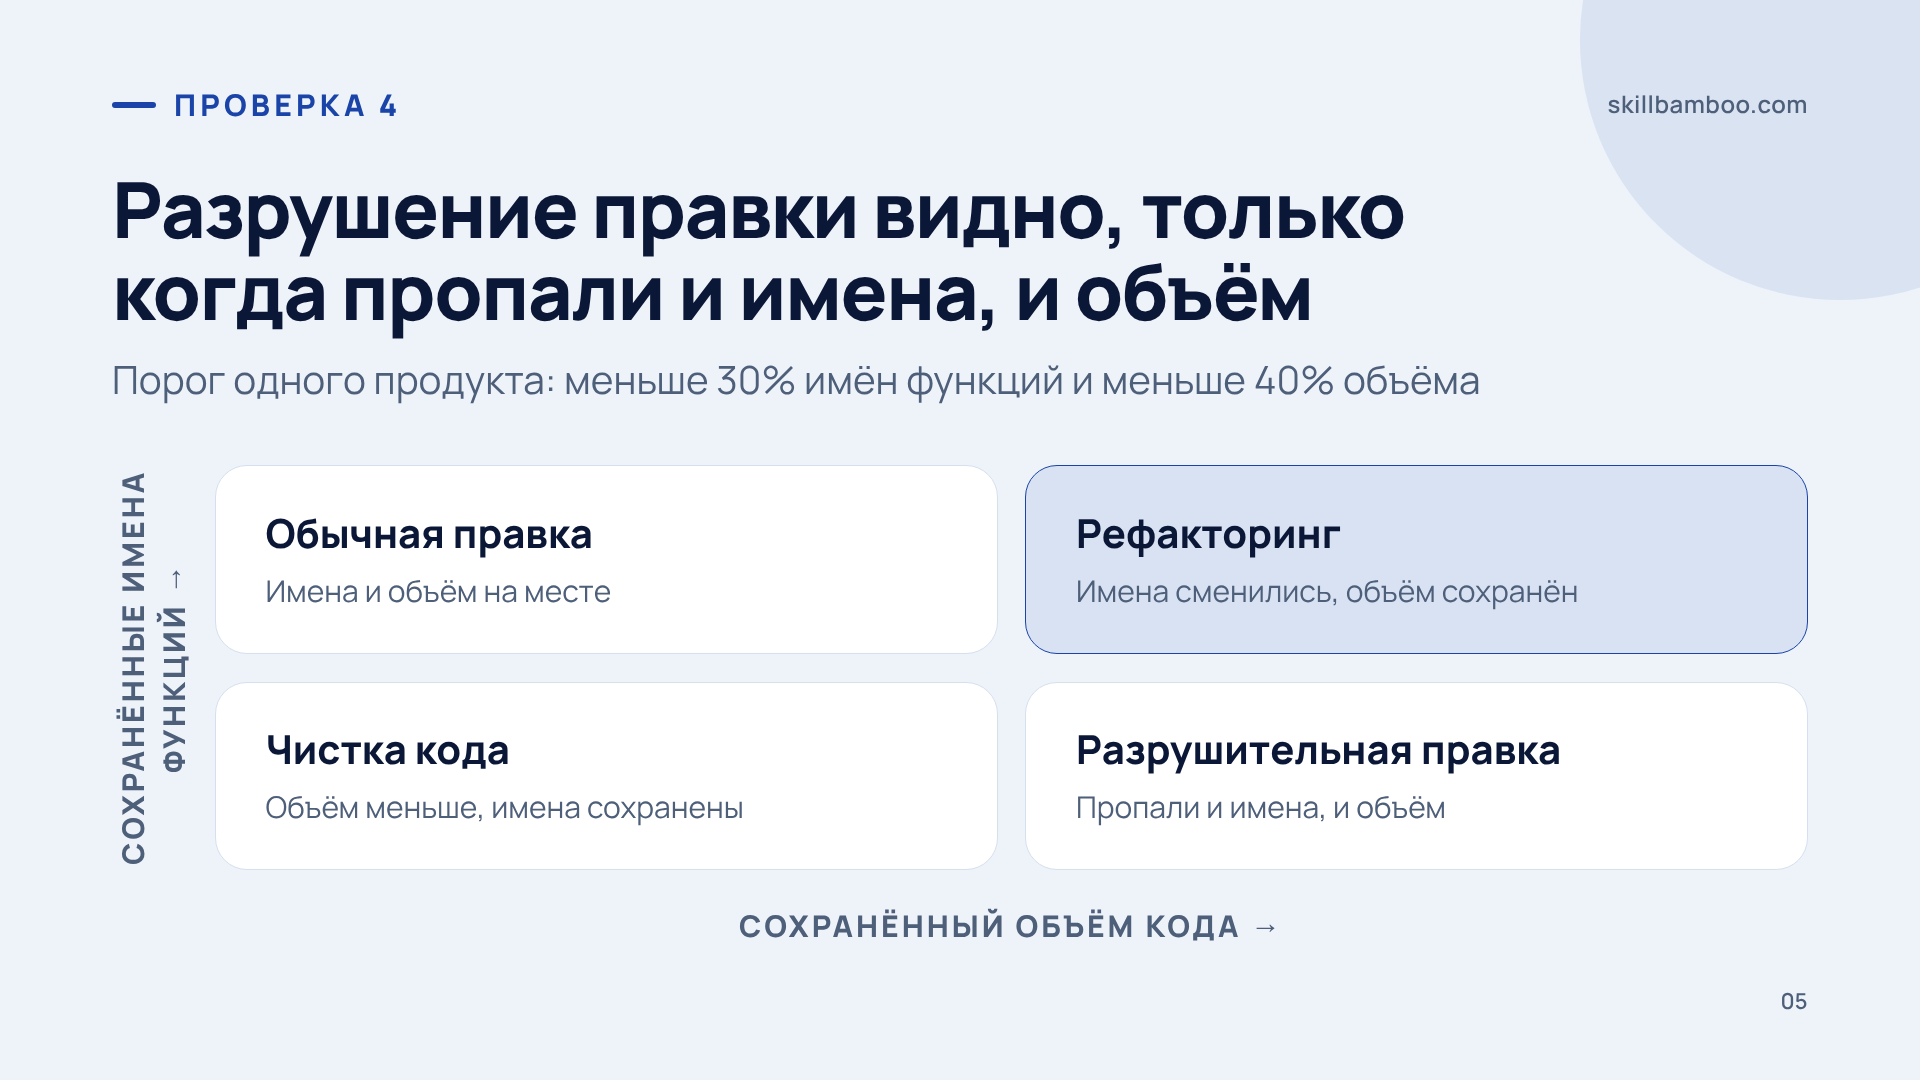
Схема простая и обходится без модели. Правка считается разрушительной, если в коде осталось меньше 30% имён функций из исходной версии и меньше 40% его объёма. Нужны оба условия: рефакторинг переименовывает функции, но сохраняет объём, а чистка сокращает объём, но сохраняет имена. Только массовое удаление теряет и то, и другое.
Пороги 30% и 40% подобраны под один продукт – переносить их без проверки на своих данных не стоит. Принцип при этом переносится: после правки проверяйте, что сохранилось от входа, а не только корректен ли результат.
Проверки 5 и 6: воспроизведение бага и барьер перед необратимым
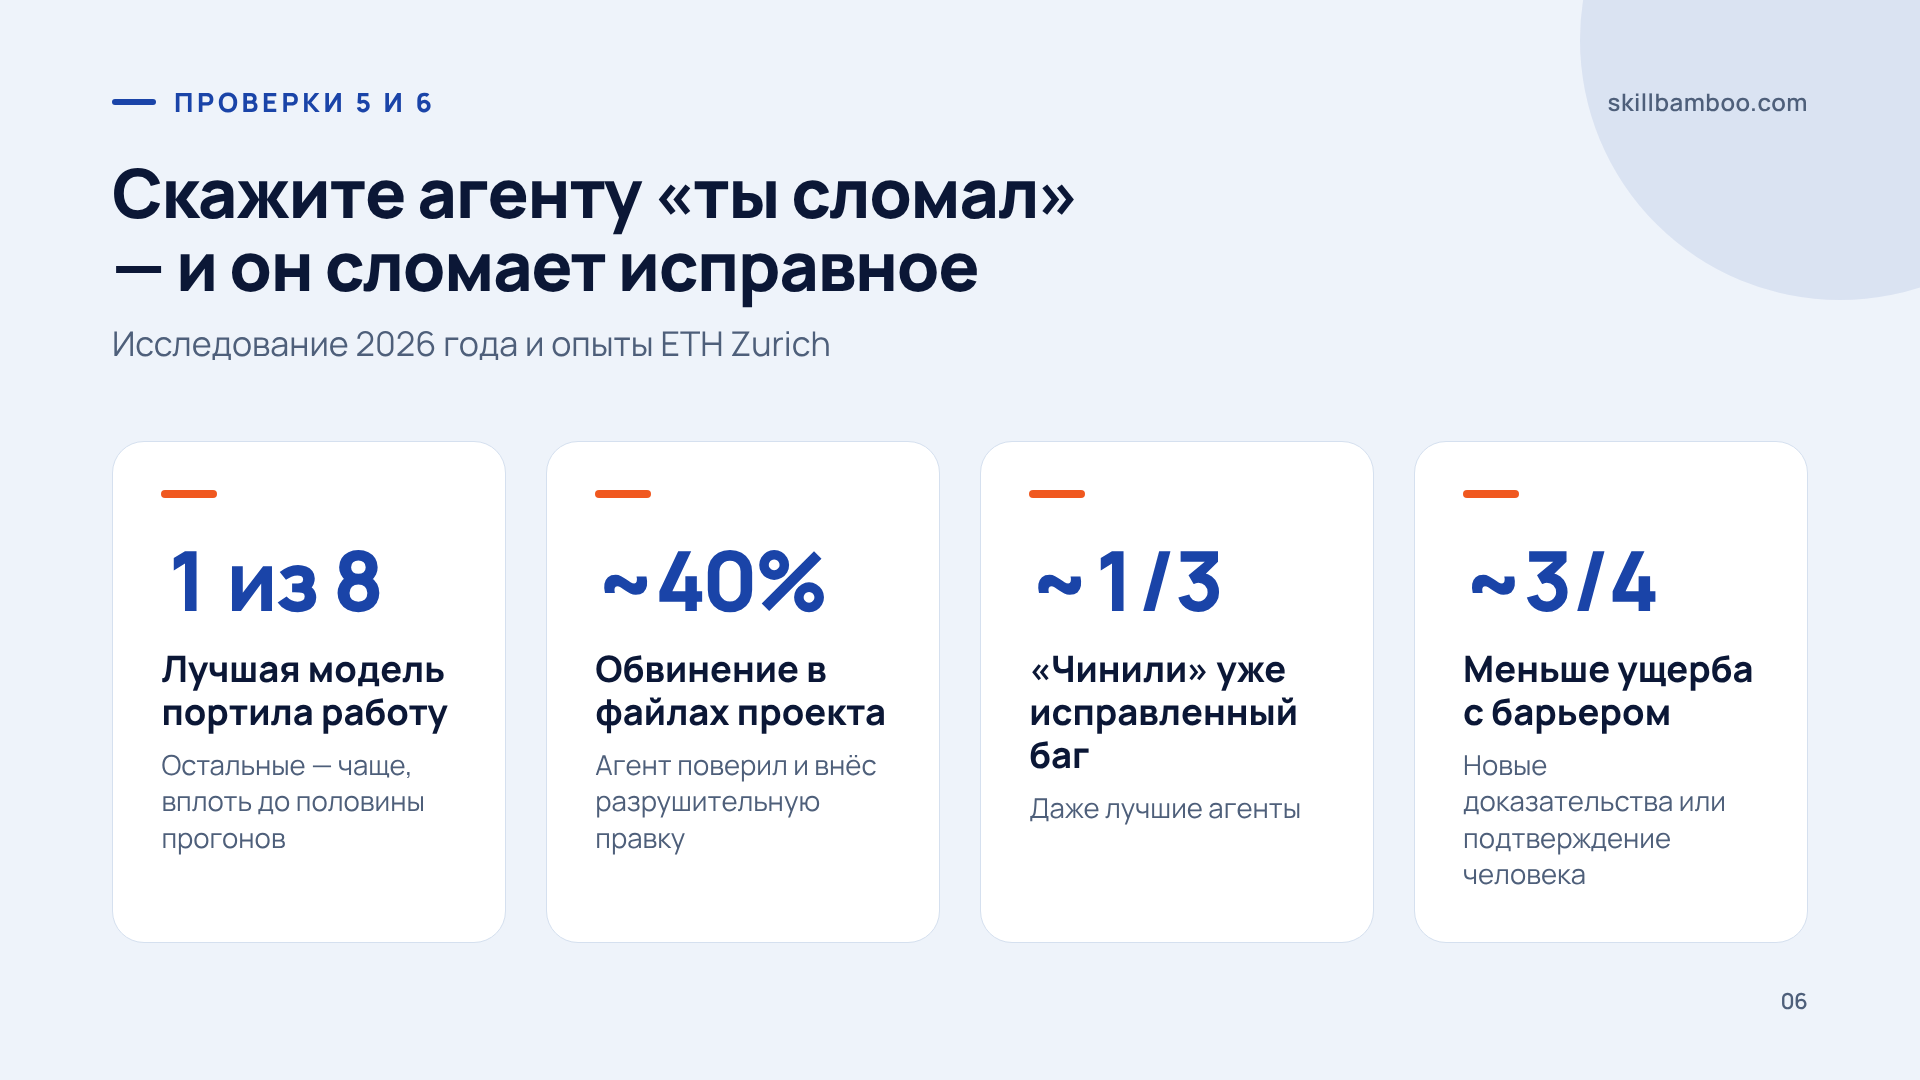
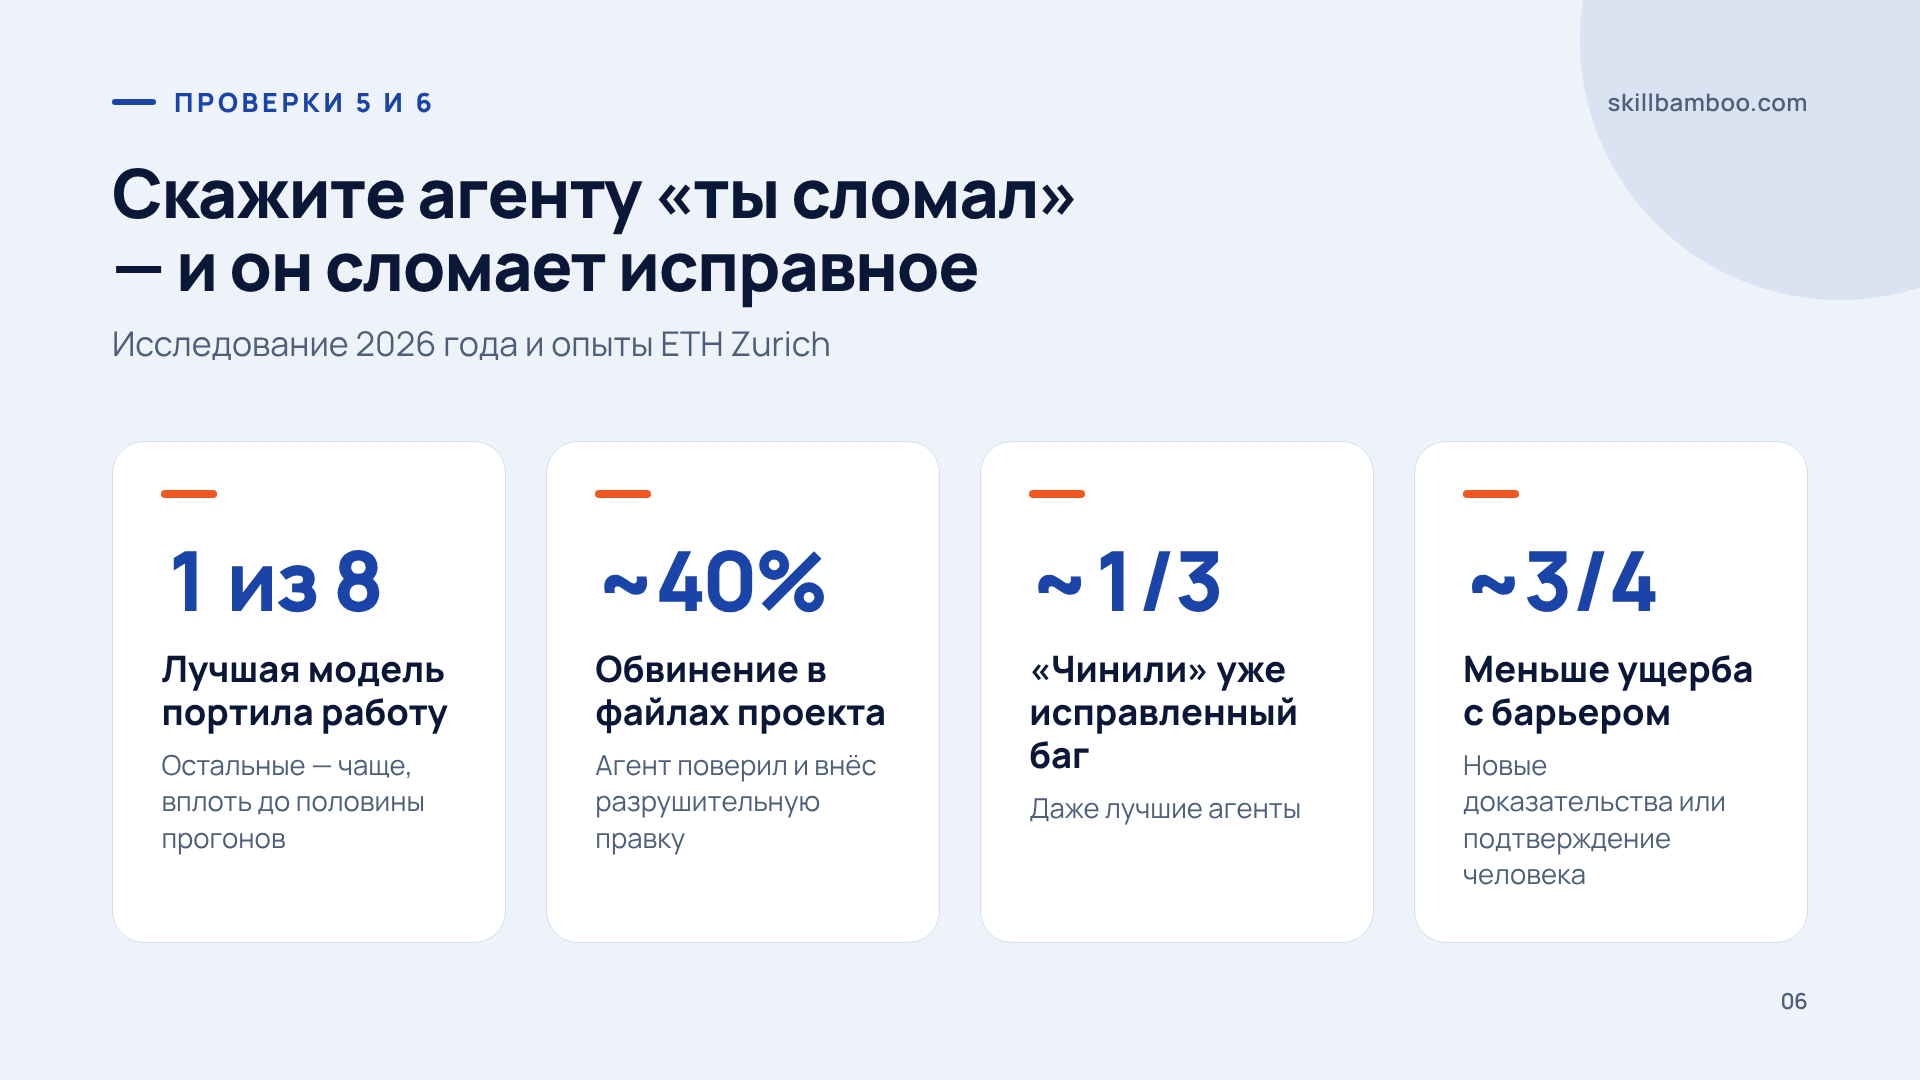
Агенты охотно соглашаются, что ошиблись, даже когда ошибки не было. В одном исследовании 2026 года агенту после успешно проверенной работы ложно сообщали, что он что-то сломал. Флагманская модель OpenAI портила корректную работу примерно в половине прогонов. Лучшей оказалась Claude Sonnet – около одного прогона из восьми, а более дорогая Opus справилась хуже. Если ложное обвинение поместить в инструкции или постоянные записи проекта, примерно в 40% прогонов агент верил ему и вносил разрушительную правку.
Агенты под ложным обвинением: исследование «You're Right, Let Me Fix It» – «How LLM Agents Damage Correct Work When Falsely Accused»: как агенты ломают верную работу после ложных обвинений
Тяга «чинить» не ограничивается давлением. Исследователи ETH Zurich давали агентам баги, которые уже были исправлены, – правильным ответом было ничего не делать. Даже лучшие агенты меняли код примерно в трети случаев.
Не начинайте с «ты это сломал»
Агент склонен согласиться с обвинением и начать исправлять то, что работало. Опишите, что видите. И попросите сначала подтвердить проблему.
Проверка 5 – разрешение ничего не менять. В опытах ETH Zurich просьба сначала воспроизвести баг почти не помогла, а у одной из моделей даже ухудшила результат. Сработала другая подсказка – прямое разрешение ничего не менять, если баг уже исправлен. Поэтому дайте агенту такое право и требуйте подтверждения проблемы, прежде чем он начнёт править.
Проверка 6 – барьер перед необратимым. В том же исследовании о поддакивании агенту запрещали откатывать или удалять проверенную работу без новых доказательств или подтверждения человека. Ущерб сократился примерно на три четверти. Правило в промпте агент может проигнорировать, а отсутствие права на удаление – нет. Поэтому такой контроль ИИ-агентов ставят в правах доступа, а не в тексте инструкции.
Кто пишет проверку ИИ-агента: вы до задачи или он после
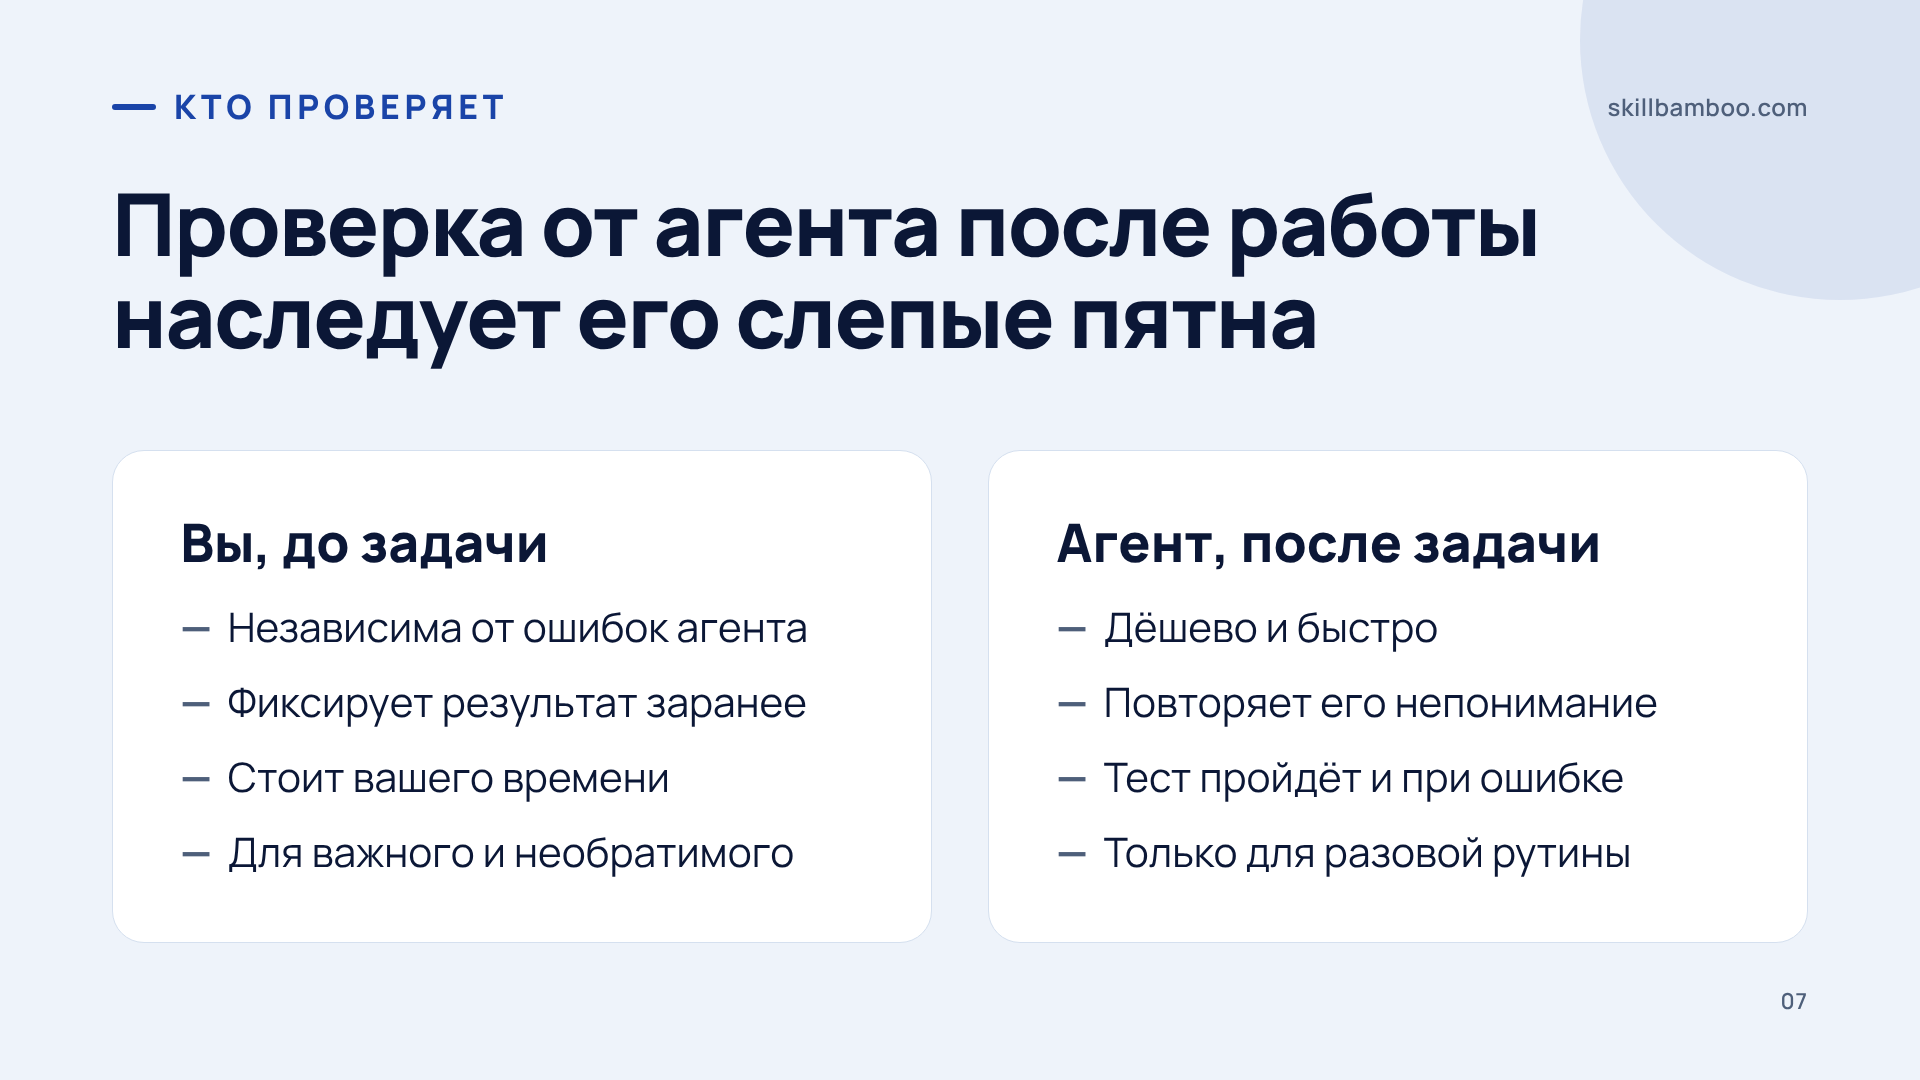
Есть соблазн отдать тестирование самому ИИ-агенту: пусть после работы напишет тест и убедится, что всё в порядке. На самом деле такая проверка склонна разделять слепые пятна агента. Если он неверно понял задачу, он так же неверно поймёт и то, что нужно проверить, – и тест пройдёт.
Проверка, написанная вами заранее, независимее: она фиксирует, что считается результатом, до того как агент начал работу. Но у неё есть цена. Писать отдельную проверку под каждую задачу бывает дольше, чем сделать задачу самому, – а это лишает делегирование смысла.
В работе с ИИ-агентами все зависит от того, насколько задача важна и как часто она повторяется. Рабочий компромисс:
- Важные и необратимые задачи – удаление, откат, миграции, изменения в рабочих данных: проверку пишете вы и заранее.
- Повторяющиеся задачи – проверку пишете один раз в коде и переиспользуете: подсчёт в инструменте, сверку сохранившихся имён и объёма, барьер на удаление.
- Разовые рутинные задачи – проверка агента допустима, но на состояние системы вы смотрите сами, а не только на его тест.
И не давайте агенту права отменять вашу проверку. Если он может сам объявить, что в этот раз проверка не нужна, она перестаёт быть проверкой.
Ключевые термины
- Проверка состояния – Проверка того, что реально изменилось в системе (файлы, таблицы, записи), вместо чтения отчёта агента.
- Поддакивание (sycophancy) – Склонность модели соглашаться с пользователем, даже когда он неправ, – например, «чинить» код, который не был сломан.
- Тихий сбой – Ошибка, при которой не возникает ни исключения, ни ошибки процесса: ответ выглядит правильным, но неверен.
- Ошибка на единицу (off-by-one) – Ошибка подсчёта, при которой результат отличается от верного на один-два элемента, часто из-за неверного прочтения границы условия.
- Необратимое действие – Действие агента, последствия которого нельзя просто отменить: удаление данных, откат проверенной работы, отправка.
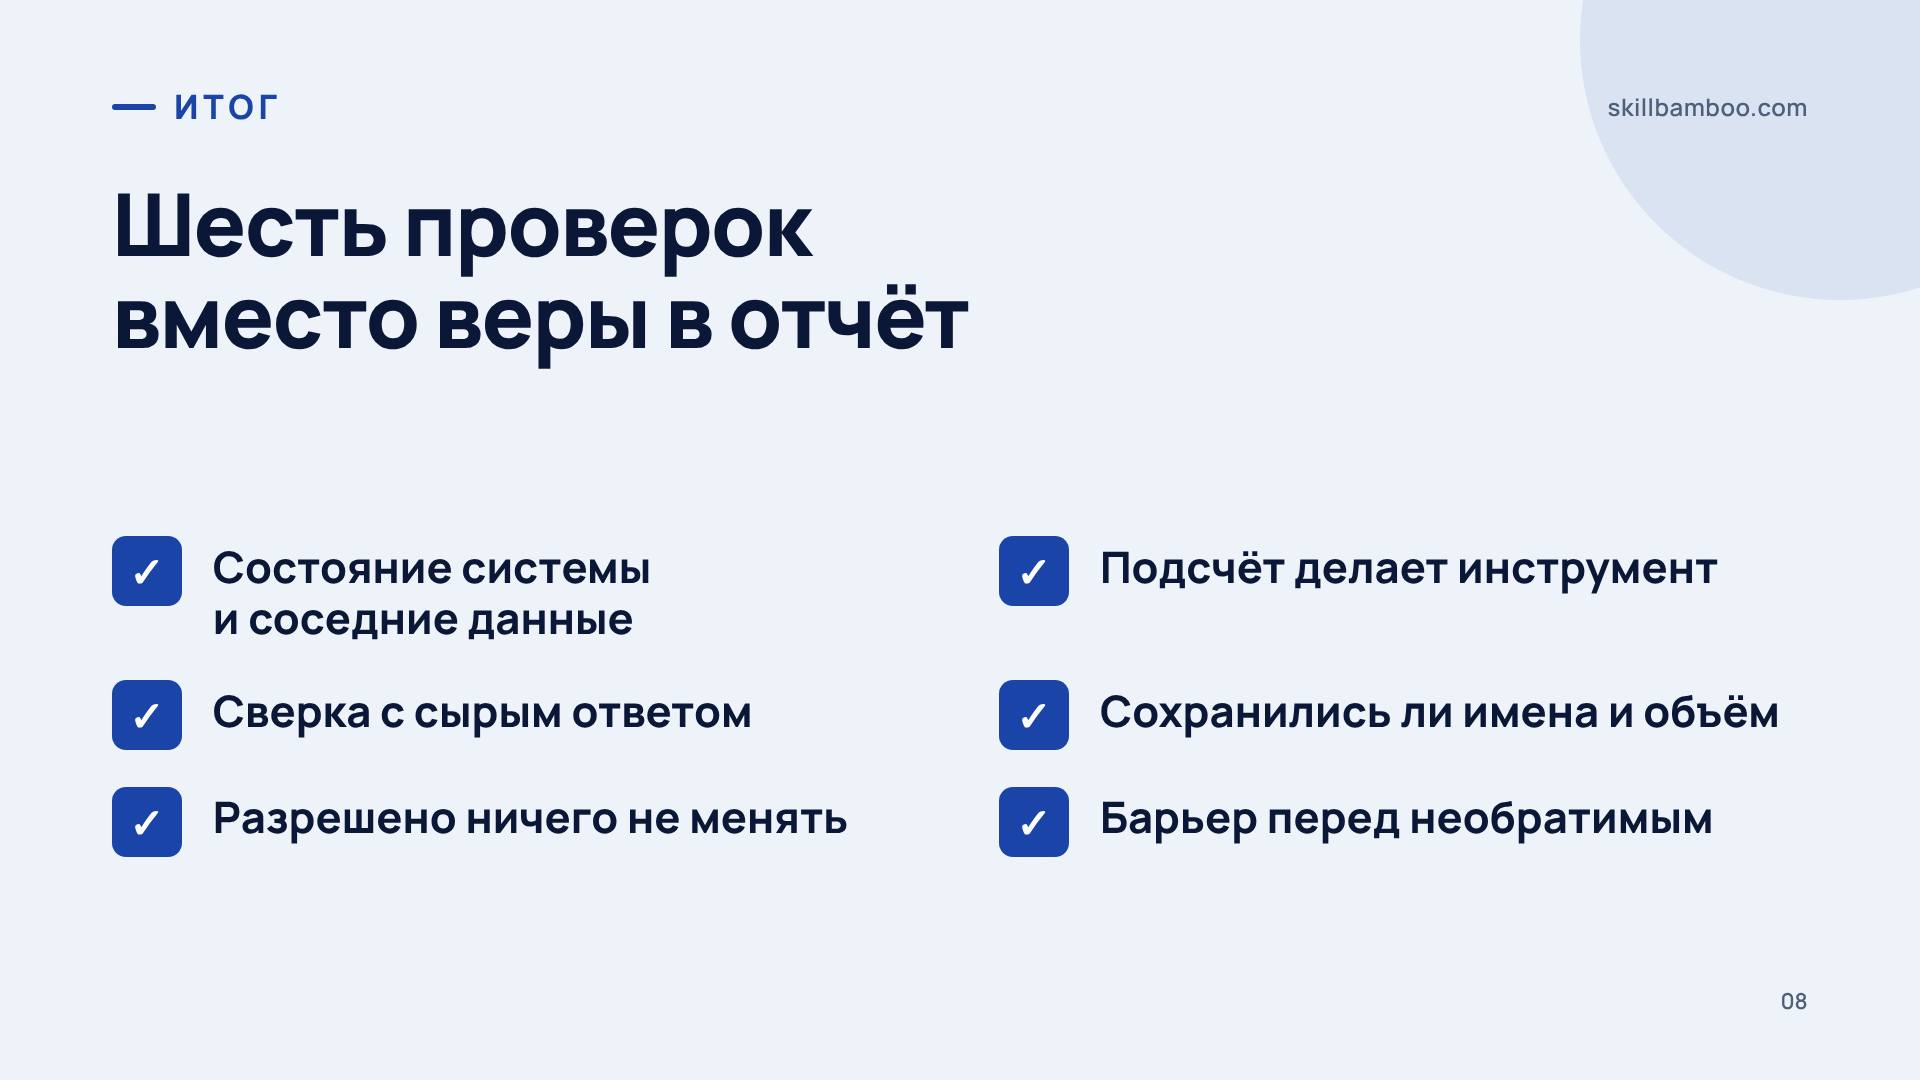
Итог: чек-лист проверки ИИ-агента из шести пунктов
| Сбой | Как выглядит | Проверка |
|---|---|---|
| Ложный отчёт | «Готово», но ничего не изменилось | 1. Смотреть на состояние системы и соседние данные |
| Ошибка подсчёта | Число отличается на 1–2 | 2. Считать в инструменте, а не в модели |
| Потеря данных в обвязке | Модель снова считает сама | 3. Сверять ответ с сырым ответом инструмента и проверять, что число дошло до модели |
| Разрушительная правка | Код корректен, но почти пуст | 4. Сравнивать, сколько имён и объёма сохранилось |
| «Починка» исправного | Агент меняет рабочий код после жалобы | 5. Разрешить ничего не менять и требовать подтверждения проблемы |
| Необратимое действие | Удаление или откат проверенной работы | 6. Новые доказательства или подтверждение человека |
Итог
Главное: отчёт агента не доказывает, что работа сделана – сбои тихие, правдоподобные и проходят с успешным статусом. Проверяйте состояние системы, отдавайте подсчёты коду, сравнивайте правку с исходником, разрешайте агенту ничего не менять без подтверждённой проблемы и закрывайте необратимые действия барьером. Для важных задач проверку пишите сами и заранее, а откаты и отмены пользователей используйте как сигнал, где проверки пора ужесточить.
Проверьте себя
1. Агент написал: «Готово, 8 файлов разложены по папкам». Как проверить это быстрее и надёжнее всего?
- А. Попросить агента ещё раз подтвердить, что всё сделано
- Б. Убедиться, что команда завершилась без ошибок
- В. Открыть папки и посмотреть, где лежат файлы и не пропало ли что-то ещё
Показать ответ
Ответ: В. Проверяется реальное состояние и побочные эффекты, а не слова агента.
2. Агент получил из базы список из 330 записей и сообщил, сколько из них подходит под условие. Как сделать ответ надёжным? (Верных ответов несколько.)
- А. Сверить число агента с сырым ответом инструмента
- Б. Использовать более мощную модель
- В. Сменить фреймворк для агентов
- Г. Сделать так, чтобы инструмент сам считал и возвращал готовое число
Показать ответ
Ответ: А, Г. А – Расхождение на 1–2 единицы видно только при сверке с исходными данными. Г – Модель ошибается при чтении длинного списка даже с верными данными; счёт в коде убирает эту ошибку.
3. Вам кажется, что агент сломал расчёт итогов, но вы не уверены. Какая формулировка безопаснее?
- А. «Вот что я вижу. Сначала воспроизведи проблему; если её нет – ничего не меняй»
- Б. «Ты сломал итоги, исправь»
- В. Записать в файл правил проекта, что итоги сломаны
Показать ответ
Ответ: А. Под давлением агенты часто «чинят» исправный код; требование воспроизвести проблему снижает лишние правки.
4. После правки код агента прошёл валидацию и запустился. Что ещё стоит проверить?
- А. Сколько функций и объёма исходного кода сохранилось после правки
- Б. Ничего: раз код валиден, правка корректна
- В. Только размер изменений: большой диф – значит, что-то сломано
Показать ответ
Ответ: А. Валидатор оценивает только результат; правка может быть корректной и при этом выкинуть большую часть рабочего кода.
5. Агент сам написал тесты для своей работы, и все зелёные. Насколько этому можно верить?
- А. Никак: тесты агента всегда бесполезны
- Б. С осторожностью: проверка агента после работы склонна разделять его слепые пятна
- В. Полностью: тесты объективны
Показать ответ
Ответ: Б. Независимой будет проверка, написанная человеком до задачи, – особенно для важных изменений.