SkillBamboo
Вопрос «Opus или Sonnet» я сначала попытался решить в лоб, перевёл все задачи в Claude Code на более дешёвый Sonnet 5.5 и выкрутил effort на max, то есть велел модели рассуждать перед каждым ответом как можно дольше. Я рассчитывал, что так она подумает за двоих, но лимит подписки начал таять на глазах, а заметно лучше ответы так и не стали.
Пришлось выяснять, что на самом деле влияет на расход, и оказалось, что модель и effort нужно выбирать по отдельности и по разным признакам. Теперь у меня есть простое правило на два шага, и я покажу его целиком, чтобы вы выбирали модель и effort под свою задачу сразу, а не перебором.
Сколько стоит разница между Sonnet 5.5 и Opus 5.5
На октябрь 2026 года прайс такой:
Pricing – Claude Docs – официальные цены моделей Claude за токены
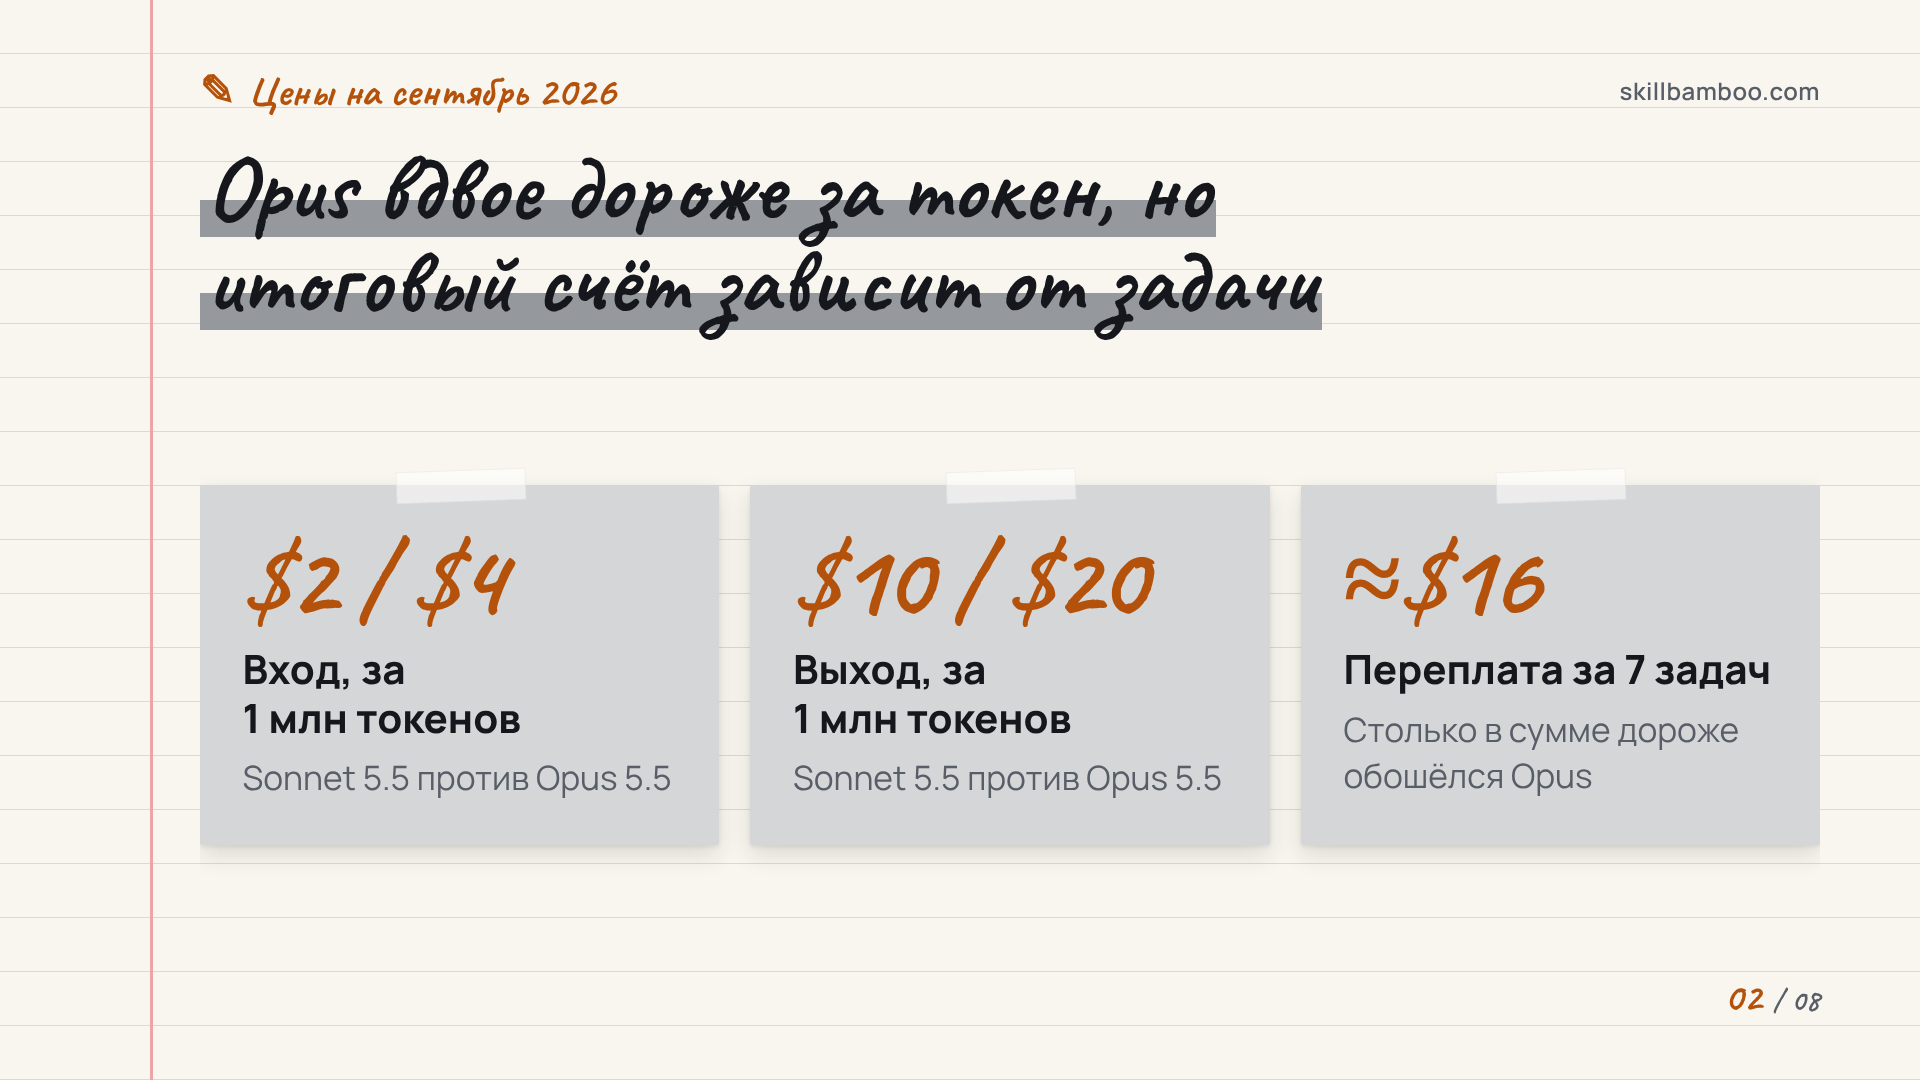
| Статья расходов | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| Входные токены, за 1 млн | $2 | $4 |
| Выходные токены, за 1 млн | $10 | $20 |
| Чтение из кэша, за 1 млн | $0,10 | $0,20 |
| Запись в кэш на 5 минут, за 1 млн | $2,50 | $5 |
По заявлению Anthropic, новый Sonnet, вышедший 28 сентября, более чем на 30% быстрее и до 30% дешевле на задачу, чем предыдущая версия. Экономия – за счёт меньшего расхода токенов при той же цене за токен. Двукратная разница в цене за токен читается легко, но с итоговым счётом всё сложнее.
Первое – кэш. Чтение из кэша у Sonnet с 7 октября тоже вдвое дешевле: $0,10 против $0,20 за миллион токенов, а на старте обе модели брали за него по $0,20. Поэтому и в длинных сессиях, где большая часть контекста повторяется, разрыв в цене сохраняется.
Второе – расход. Модели тратят разное количество токенов и времени на одну и ту же задачу. В сравнении на семи одинаковых задачах Opus в сумме обошёлся примерно на $16 дороже Sonnet 5.5. Но на отдельных задачах картина переворачивалась: при создании презентации и Excel-таблицы с формулами Opus оказался и дешевле, и быстрее, а качество у обеих моделей было почти одинаковым. Цена за токен – только ставка. Итог зависит от того, сколько модель «наработает».
Если вы работаете не по API, а по подписке, логика та же: дешёвая модель расходует лимит медленнее. Как оформить подписку и поставить сам инструмент – в курсе «Установка Claude Code на локальный сервер и VPS».
Где Sonnet 5.5 не уступает Opus: задачи с чётким ТЗ
Сильную сторону Sonnet 5.5 Anthropic описывает прямо: он лучше всего работает там, где у задачи есть понятная спецификация и способ проверить результат. Опубликованные в сентябре 2026 года бенчмарки это поддерживают. В тесте агентного программирования Terminal-Bench 4.0 Sonnet 5.5 обошёл Opus 5.5. В GDPval-AA – он проверяет реальные рабочие задачи – набрал примерно столько же, сколько Opus, и примерно на 400 пунктов рейтинга Elo больше Sonnet 5.
Claude Sonnet 5.5 – Anthropic – официальный анонс Sonnet 5.5 с бенчмарками
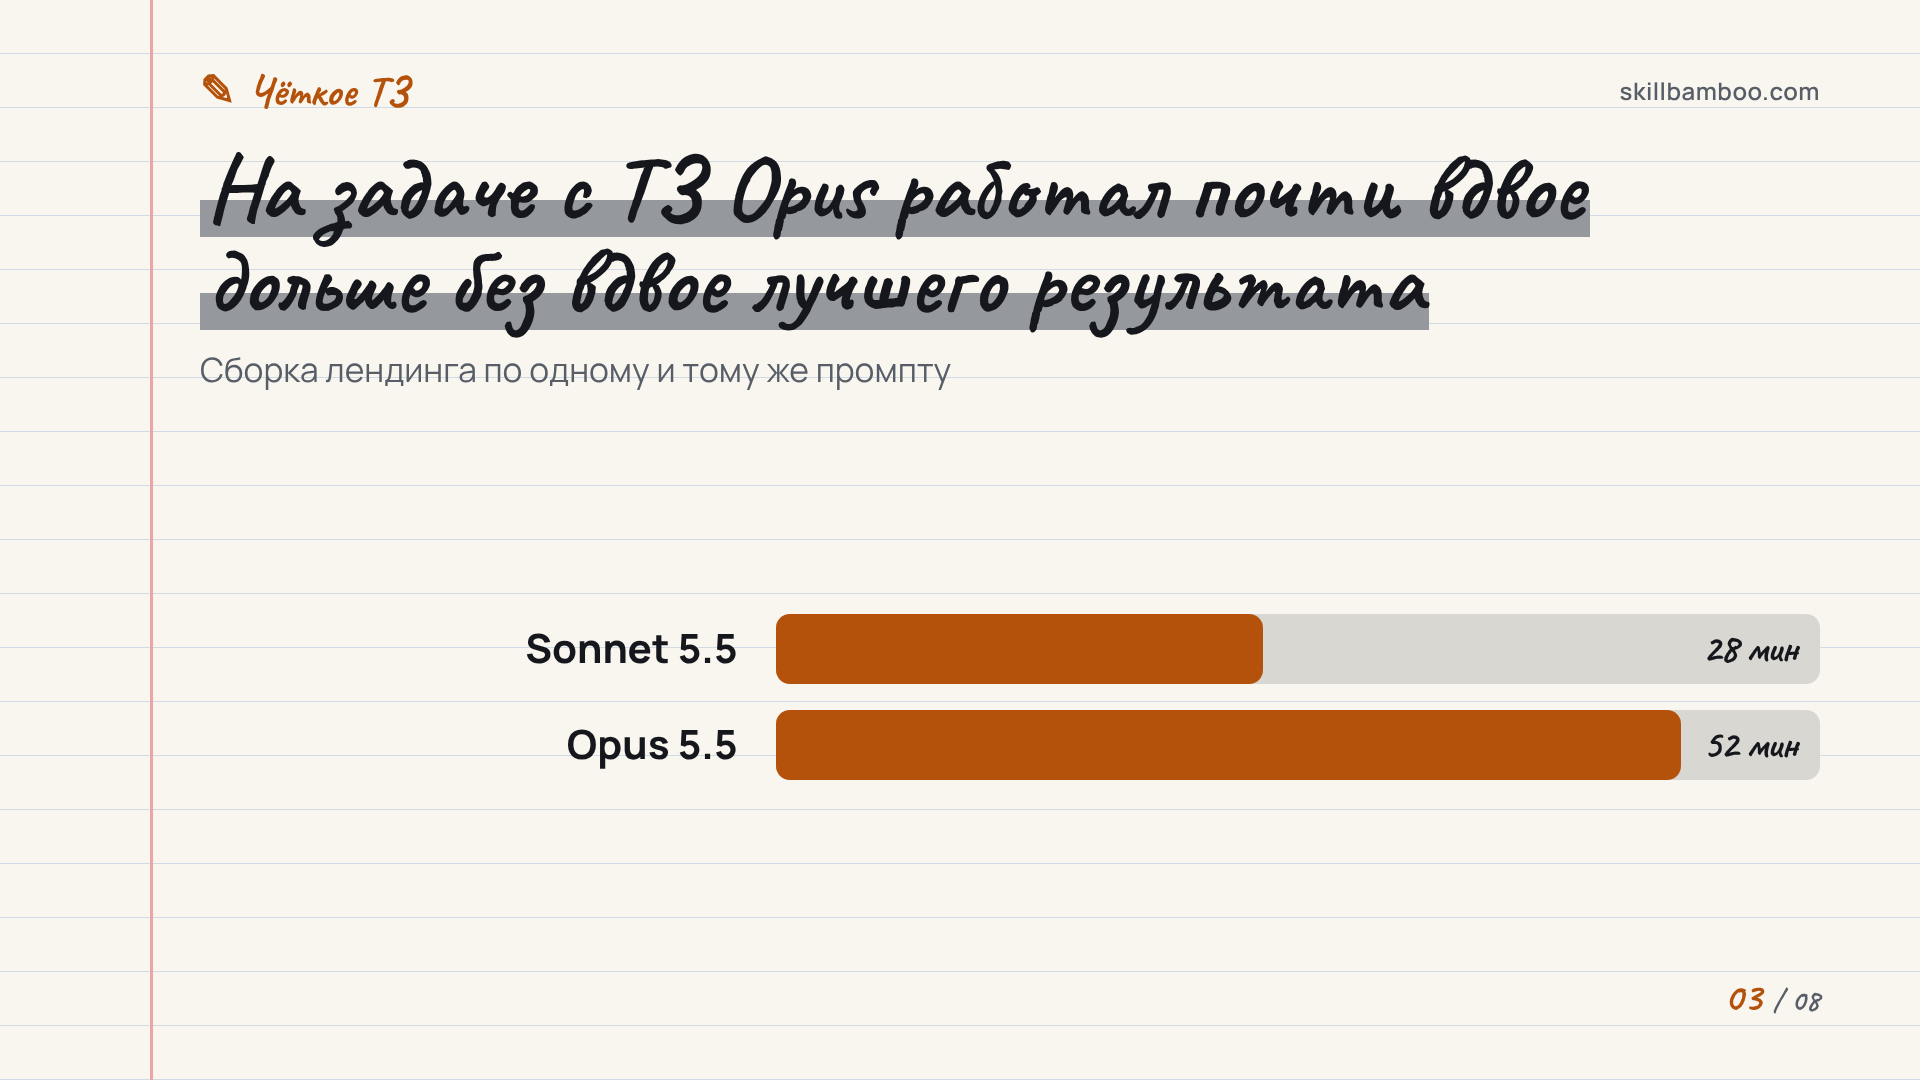
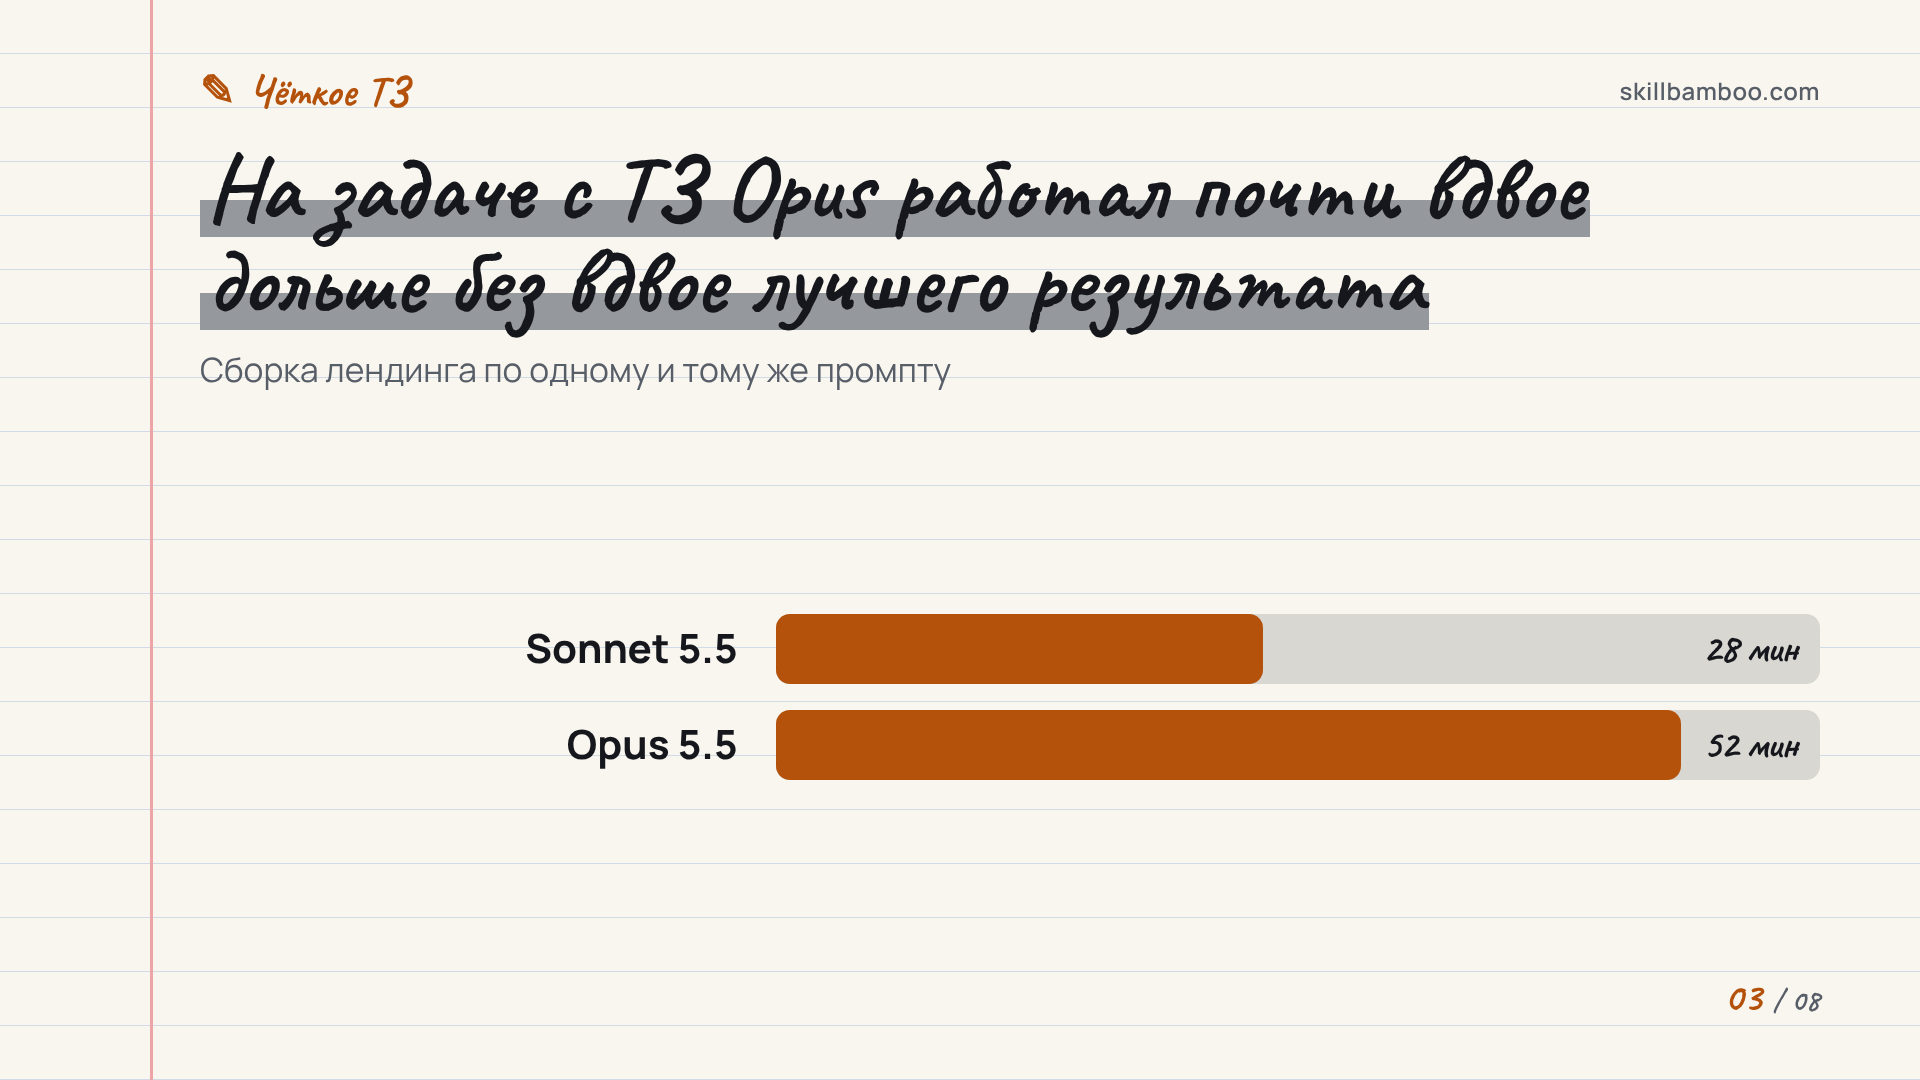
Практические прогоны показывают то же. На сборке лендинга по одному и тому же промпту Sonnet работал 28 минут, Opus – 52. Opus потратил примерно вдвое больше времени и денег, но вдвое лучшего лендинга не вышло.
Ещё нагляднее случай со скиллом – готовой инструкцией, которая описывает, как выглядит хороший результат. Когда задача шла через такой скилл, ответы двух моделей почти совпали, а Sonnet справился вдвое быстрее и на $1,40 дешевле. Скилл, по сути, делает за модель ту работу, ради которой обычно берут Opus: объясняет, что именно нужно получить.
Чем подробнее промпт, тем меньше разница в качестве между моделями. Разница в цене при этом никуда не девается.
Правило первого выбора
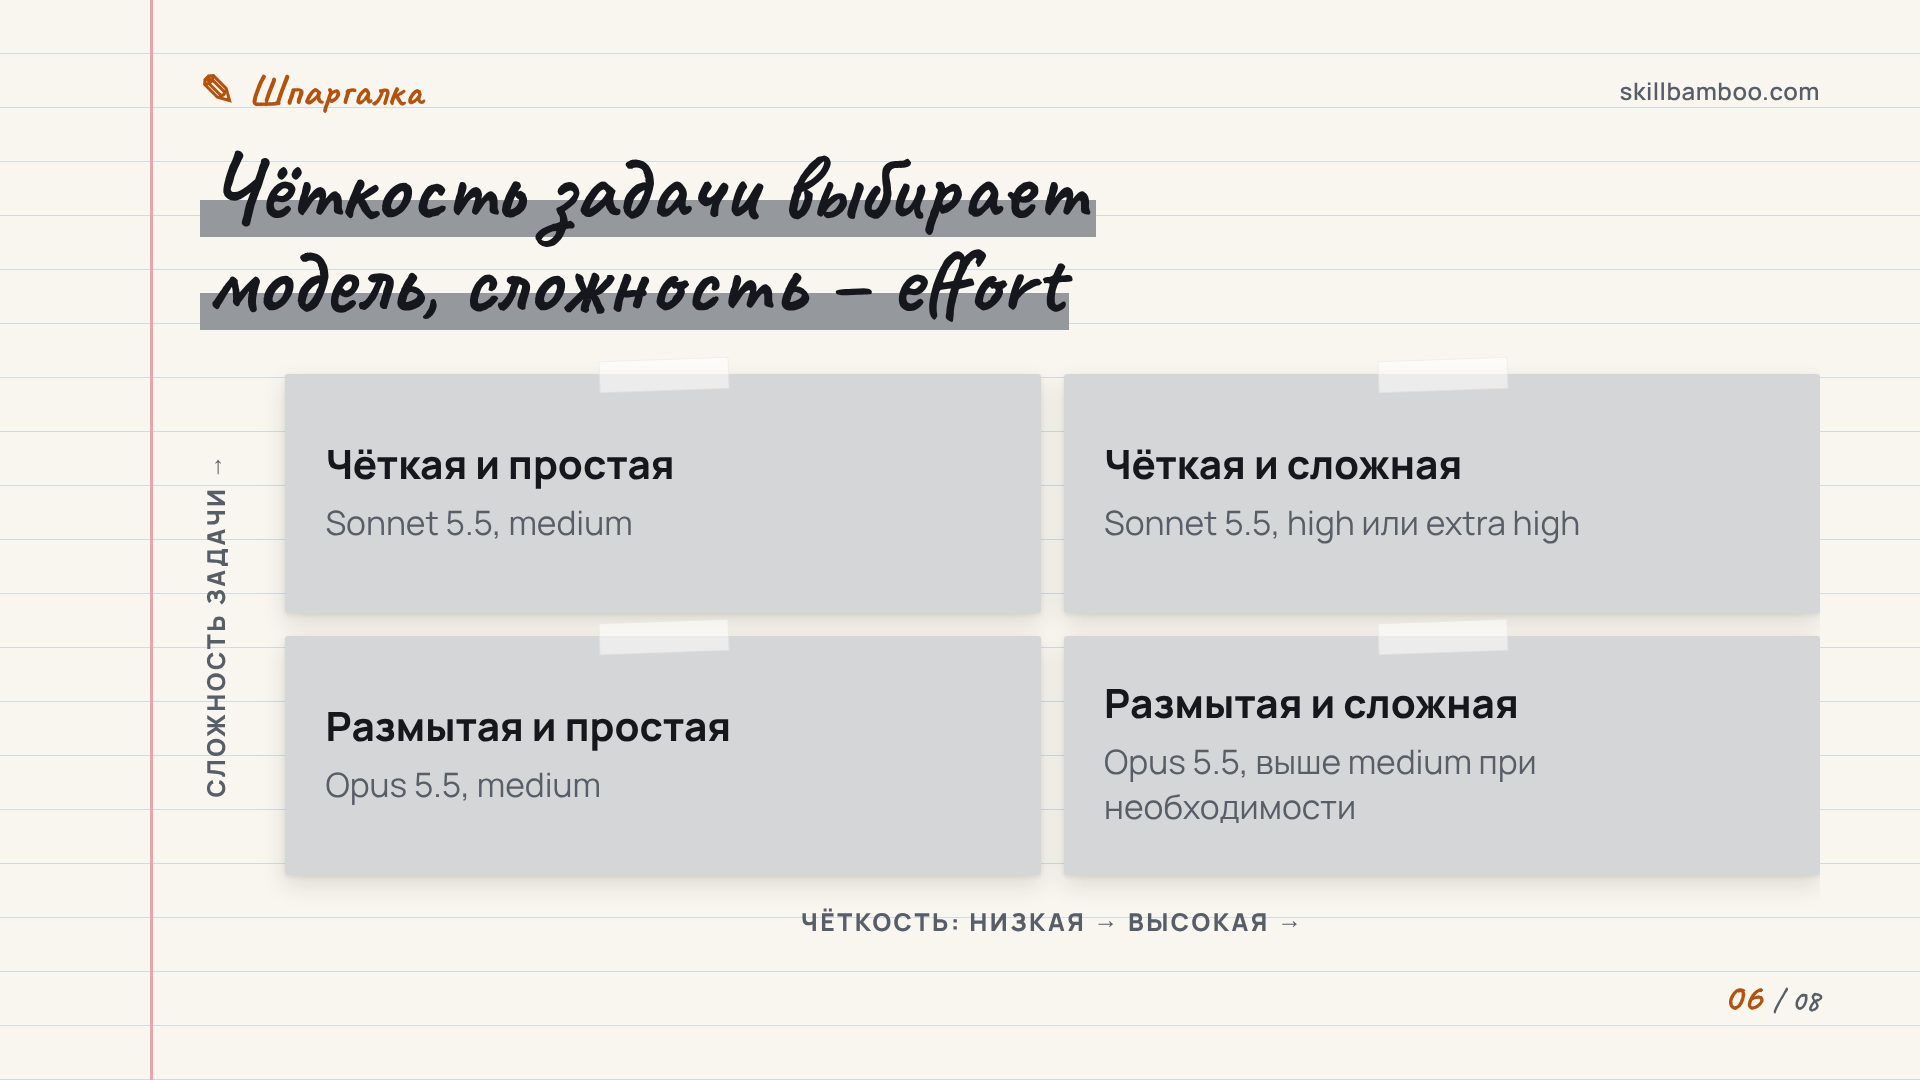
Если у задачи есть объективный критерий готовности – тесты проходят, таблица считается, страница соответствует макету, – сначала запускайте Sonnet 5.5. На Opus переходите, только если результат не устроил.
Где Opus 5.5 оправдывает цену: размытые и творческие задачи
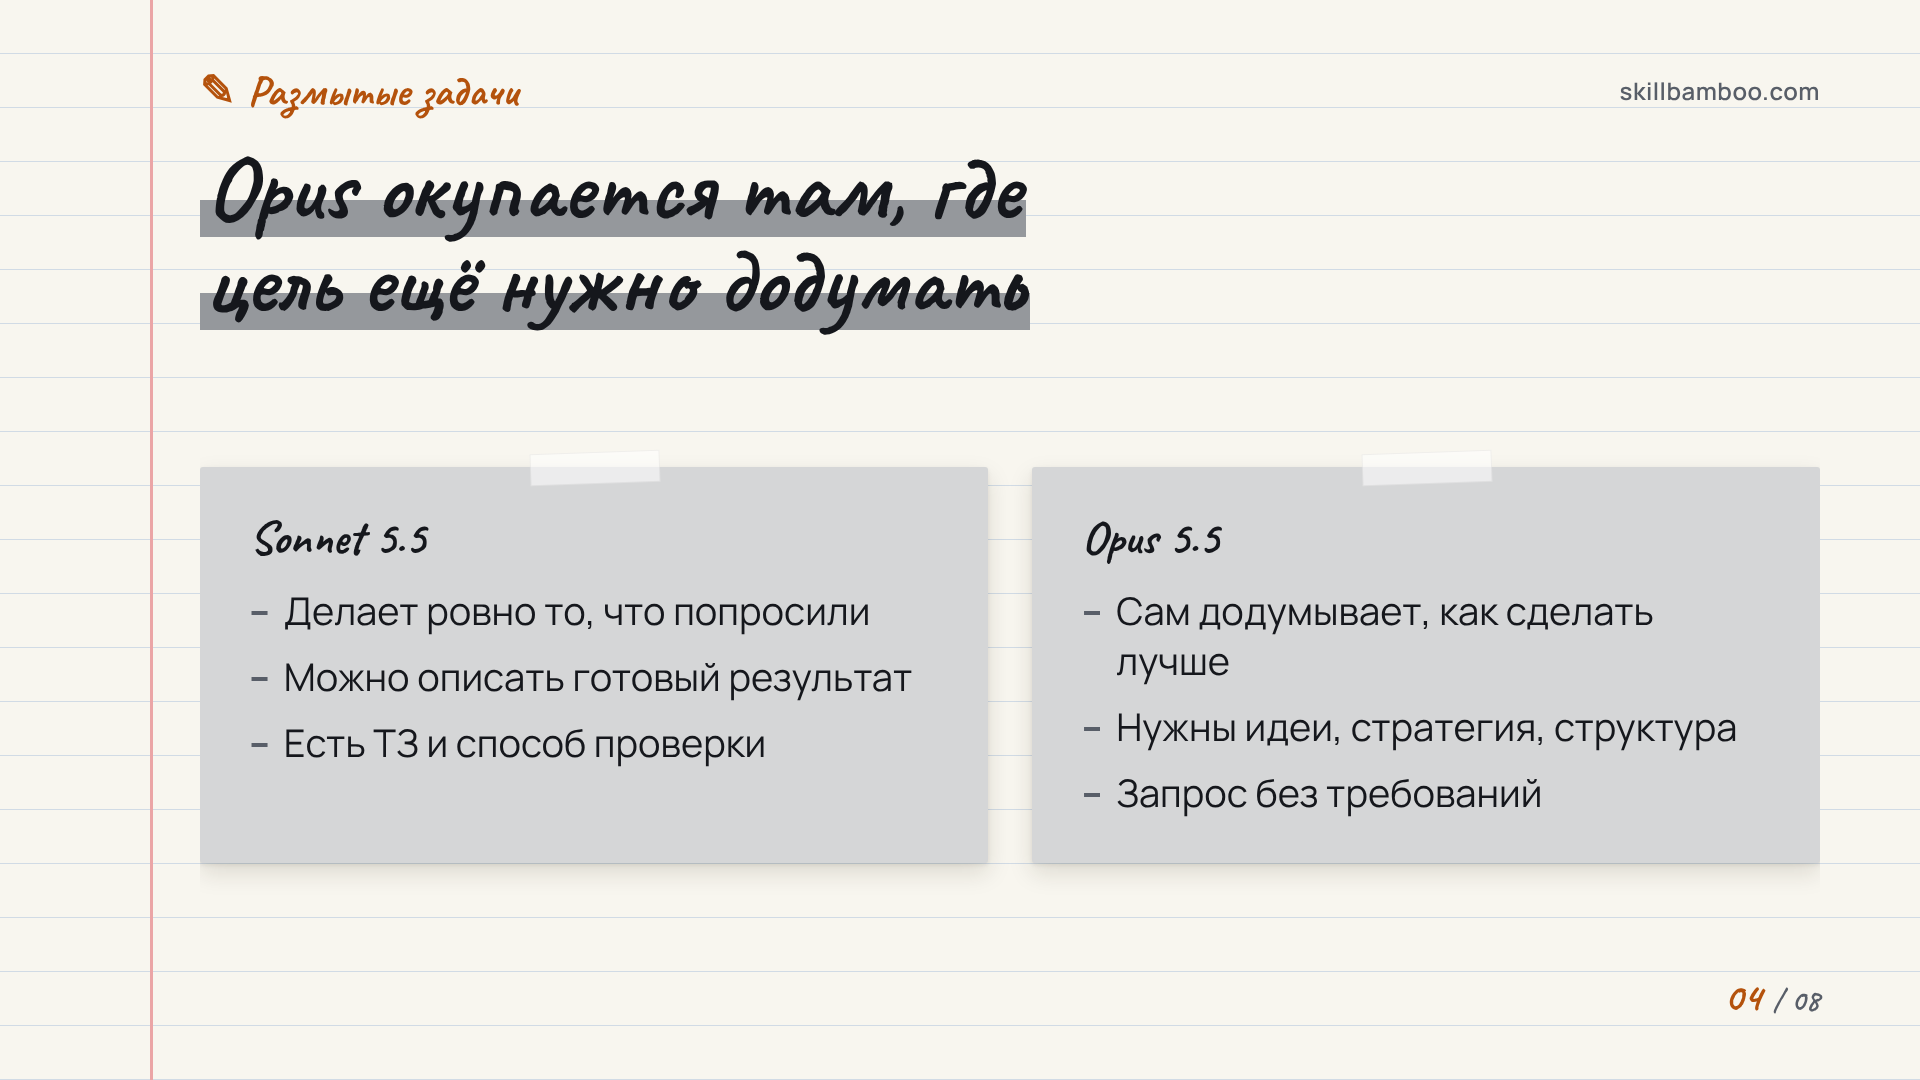
Переплата за Opus окупается на задачах, где цель сформулирована нечётко и её нужно додумать. В одном из сравнений моделям дали расплывчатый запрос без требований – составить план продвижения на квартал. Opus выдал заметно более сильный результат, и даже с учётом цены он выглядел выгоднее.
Причина – в поведении моделей. Sonnet реже выходит за рамки запроса: делает то, что попросили. Opus сам прикидывает, как сделать результат лучше, и предлагает то, о чём вы не написали. На задаче с жёстким ТЗ это лишние минуты и токены. На задаче, где ТЗ ещё нет, это и есть нужная работа.
Перед запуском спросите себя: можно ли сейчас описать, как выглядит готовый результат. Если да – это территория Sonnet. Если вы сами пока ищете ответ и ждёте от модели идей – берите Opus.
Есть и обратная сторона. Если вы потратили время на подробный промпт и превратили размытую задачу в чёткую, Opus, скорее всего, уже не нужен: при конкретной постановке результаты моделей сближаются, а Sonnet остаётся дешевле.
Effort в Claude Code: почему он влияет на стоимость сильнее, чем модель
В Claude Code у effort пять уровней: low, medium, high, xhigh (extra high) и max. Ultracode – отдельная настройка, а не уровень effort. Чем выше уровень, тем дольше модель рассуждает и тем больше токенов тратит.
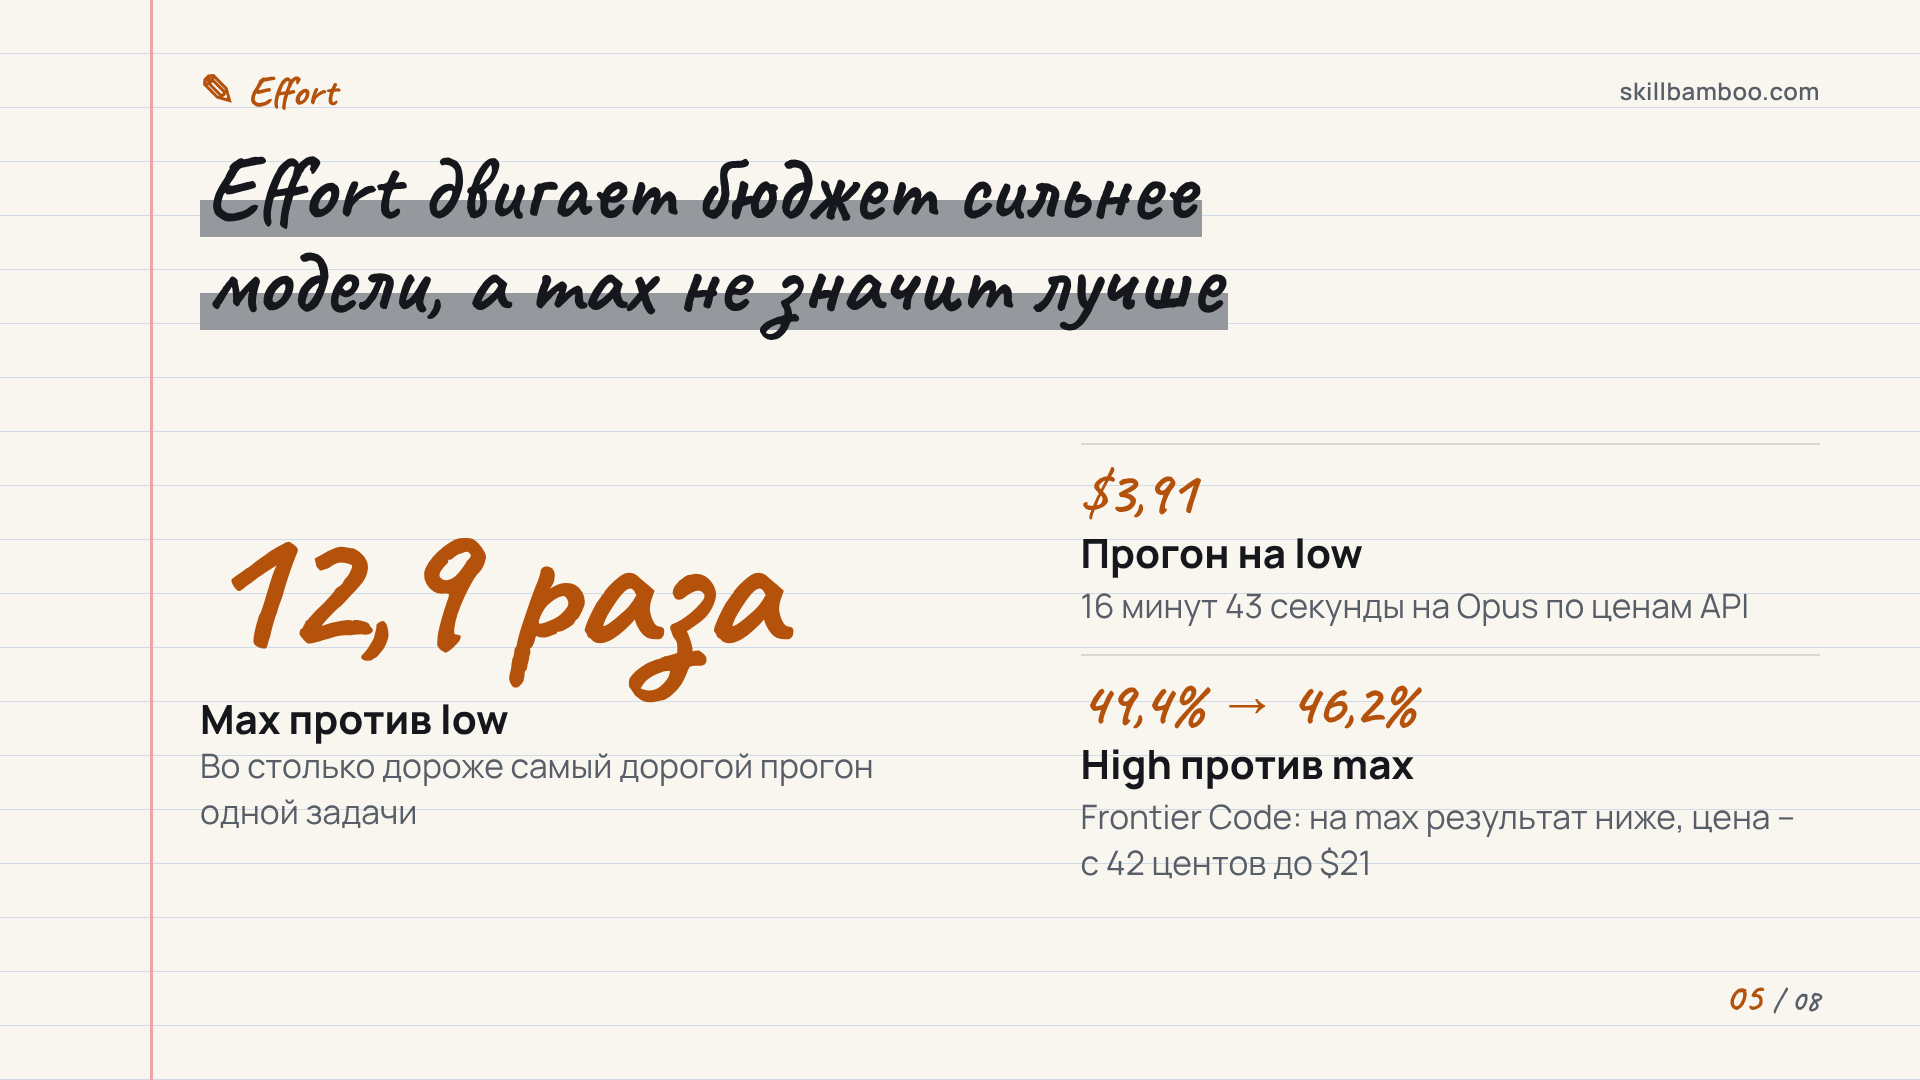
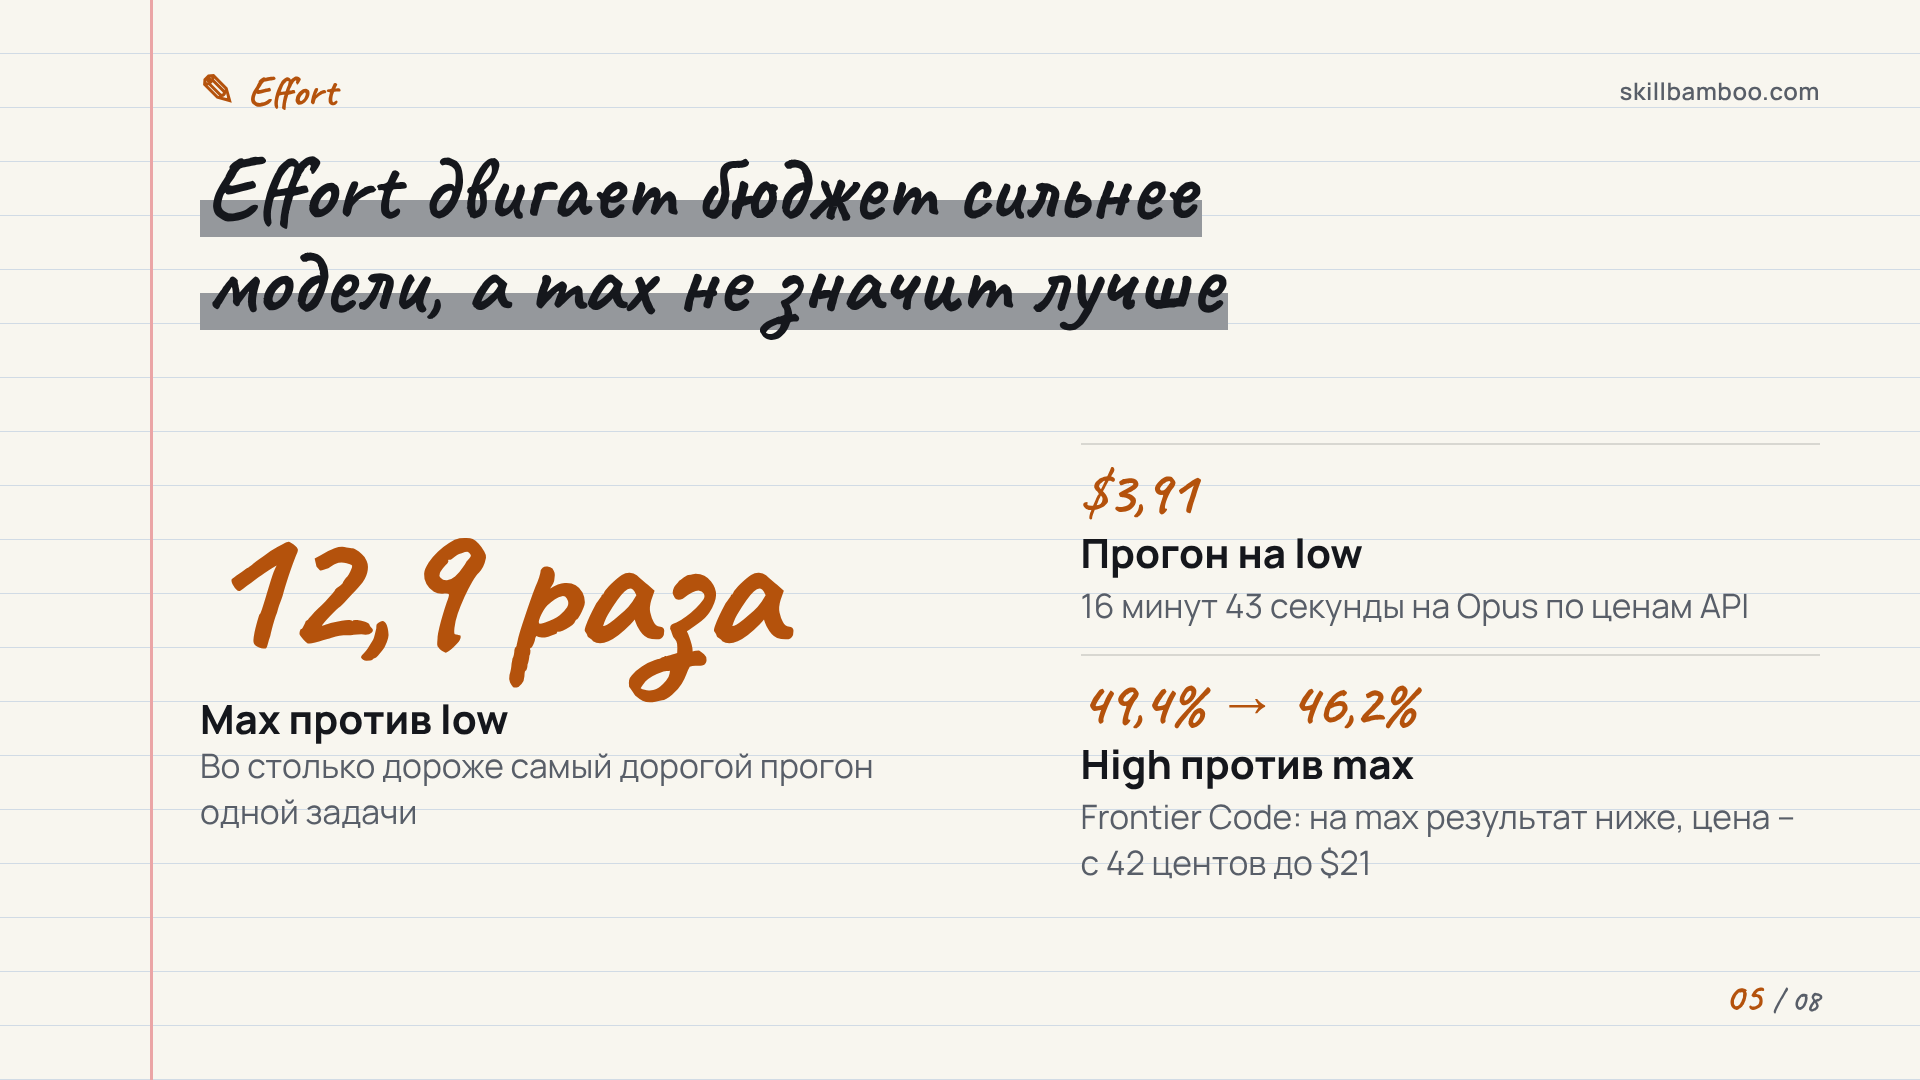
Масштаб разницы хорошо виден на одной задаче – сборке 3D-мира для конференции на Opus. На уровне low она заняла 16 минут 43 секунды и по ценам API стоила бы $3,91. Самый дорогой прогон, на max, обошёлся в 12,9 раза дороже самого дешёвого. Для сравнения: цена за токен у Sonnet всего вдвое ниже, чем у Opus, а на реальных задачах разница бывает и меньше. Effort двигает бюджет заметно сильнее.
При этом max – не синоним «лучший». В том же тесте лучший результат дал уровень xhigh – примерно вдвое быстрее и вдвое дешевле max. Бенчмарки Sonnet 5.5 показывают похожее: в FrontierCode на уровне high модель набрала 49,4%, на max – 46,2%, а стоимость задачи выросла с 42 центов почти до $21.
Важное ограничение: в бенчмарке агентного программирования качество Sonnet 5.5 растёт почти линейно от medium до max. Для сложной работы с кодом повышение effort действительно добавляет результат, в других задачах – не обязательно.
Отправная точка – рекомендация Anthropic: начинать с medium и повышать или понижать уровень по ситуации. Для значительной части офисной и аналитической работы medium вполне хватает. Для повседневного программирования на Sonnet 5.5 Anthropic советует medium на чётко поставленных задачах и high – на более сложных и долгих; xhigh и max – только если они заметно улучшают результат.
Max – не настройка по умолчанию
Максимальный effort может стоить на порядок дороже и при этом давать результат хуже, чем high или extra. Включайте его только после того, как extra не справился.
Если Claude Code у вас ещё не установлен или работает нестабильно, начните с курса «Установка Claude Code на локальный сервер и VPS»: там он ставится и на компьютер, и на сервер.
Шпаргалка: что лучше, Opus или Sonnet, для вашей задачи
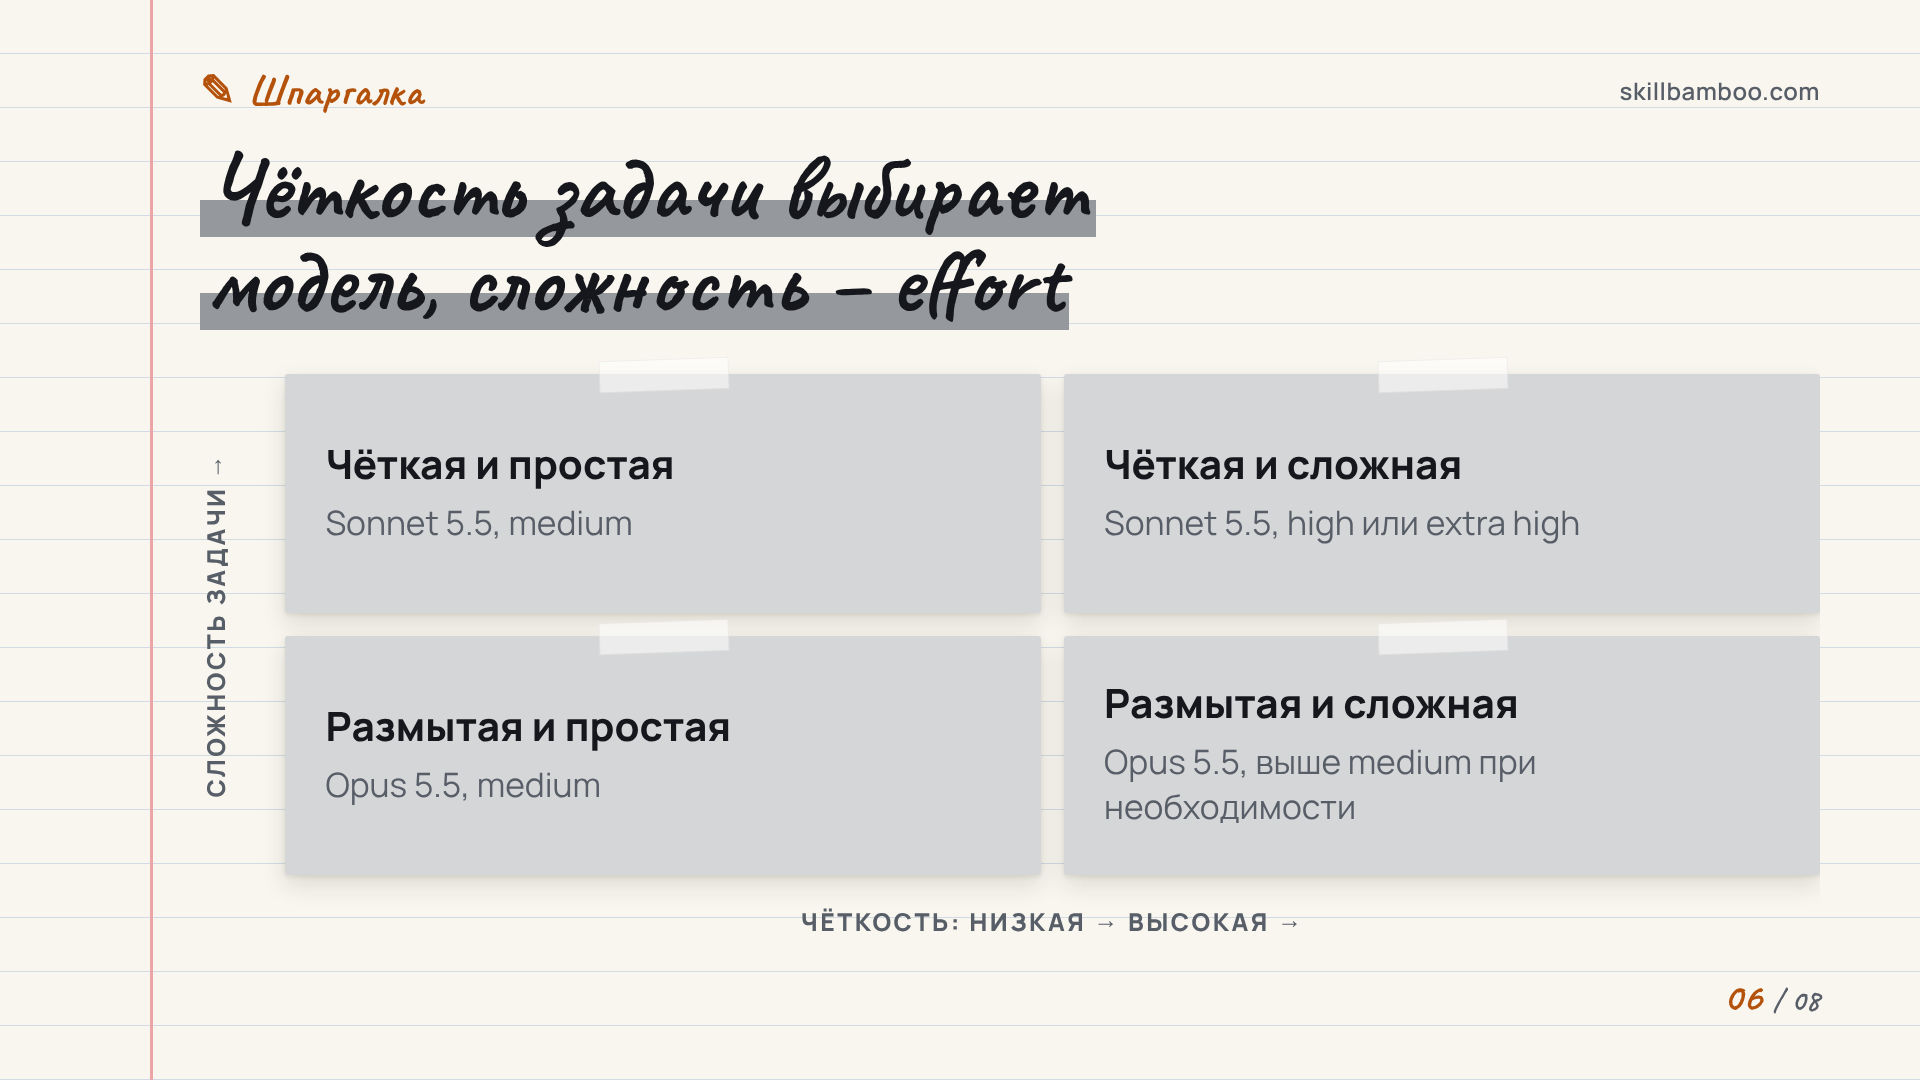
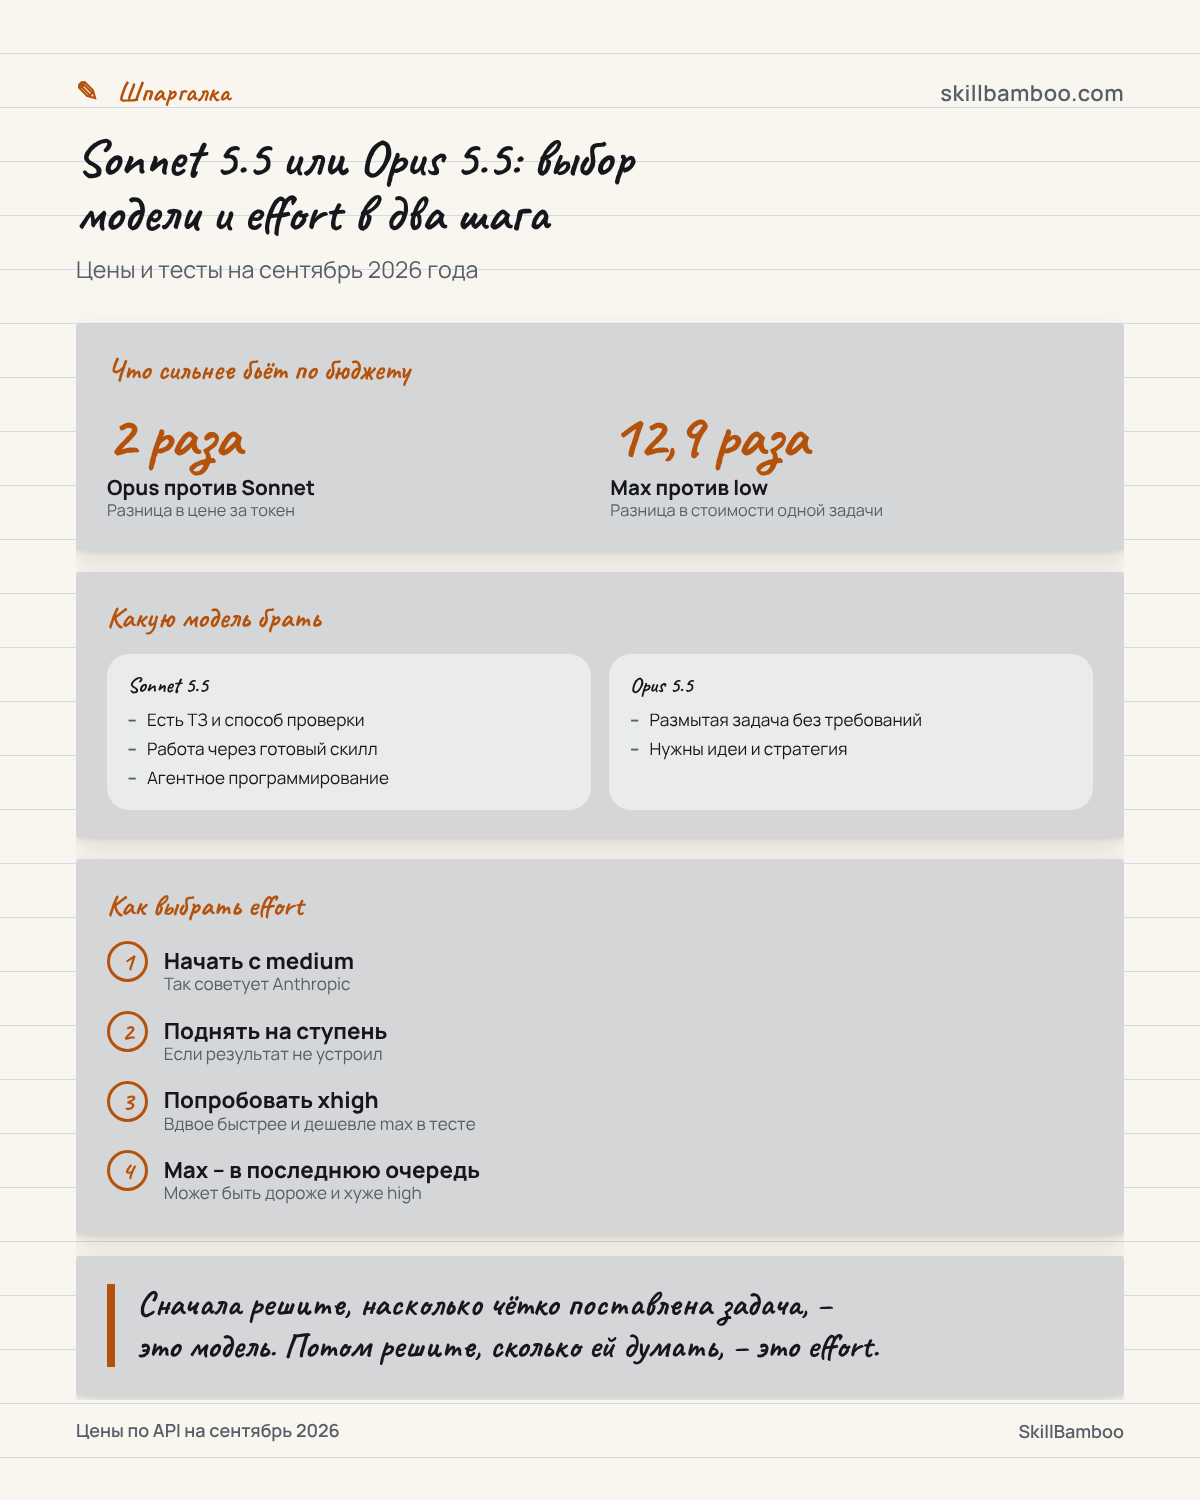
В таблице – стартовые настройки: если результат не устраивает, сначала поднимите effort на одну ступень и только потом меняйте модель.
| Задача | Модель | Effort |
|---|---|---|
| Чёткое ТЗ и способ проверки: тесты, макет, критерий готовности | Sonnet 5.5 | medium, при неудаче – high |
| Работа через готовый скилл | Sonnet 5.5 | medium |
| Агентное программирование, сложный код | Sonnet 5.5 | high или extra high |
| Офисная и аналитическая работа: документы, таблицы, презентации | Sonnet 5.5 или Opus 5.5 – сравните итоговую стоимость | medium |
| Размытая задача без требований: стратегия, план, идеи | Opus 5.5 | medium, при необходимости – выше |
| Непонятно, сколько думать | по чёткости задачи | medium |
Две оговорки. В строке про офисную работу однозначного победителя нет: на презентации и таблице с формулами Opus однажды оказался дешевле и быстрее. А уровня max в таблице нет вообще – для него не нашлось задачи, где он стабильно лучше extra.
Ограничение Sonnet 5.5 в задачах по кибербезопасности
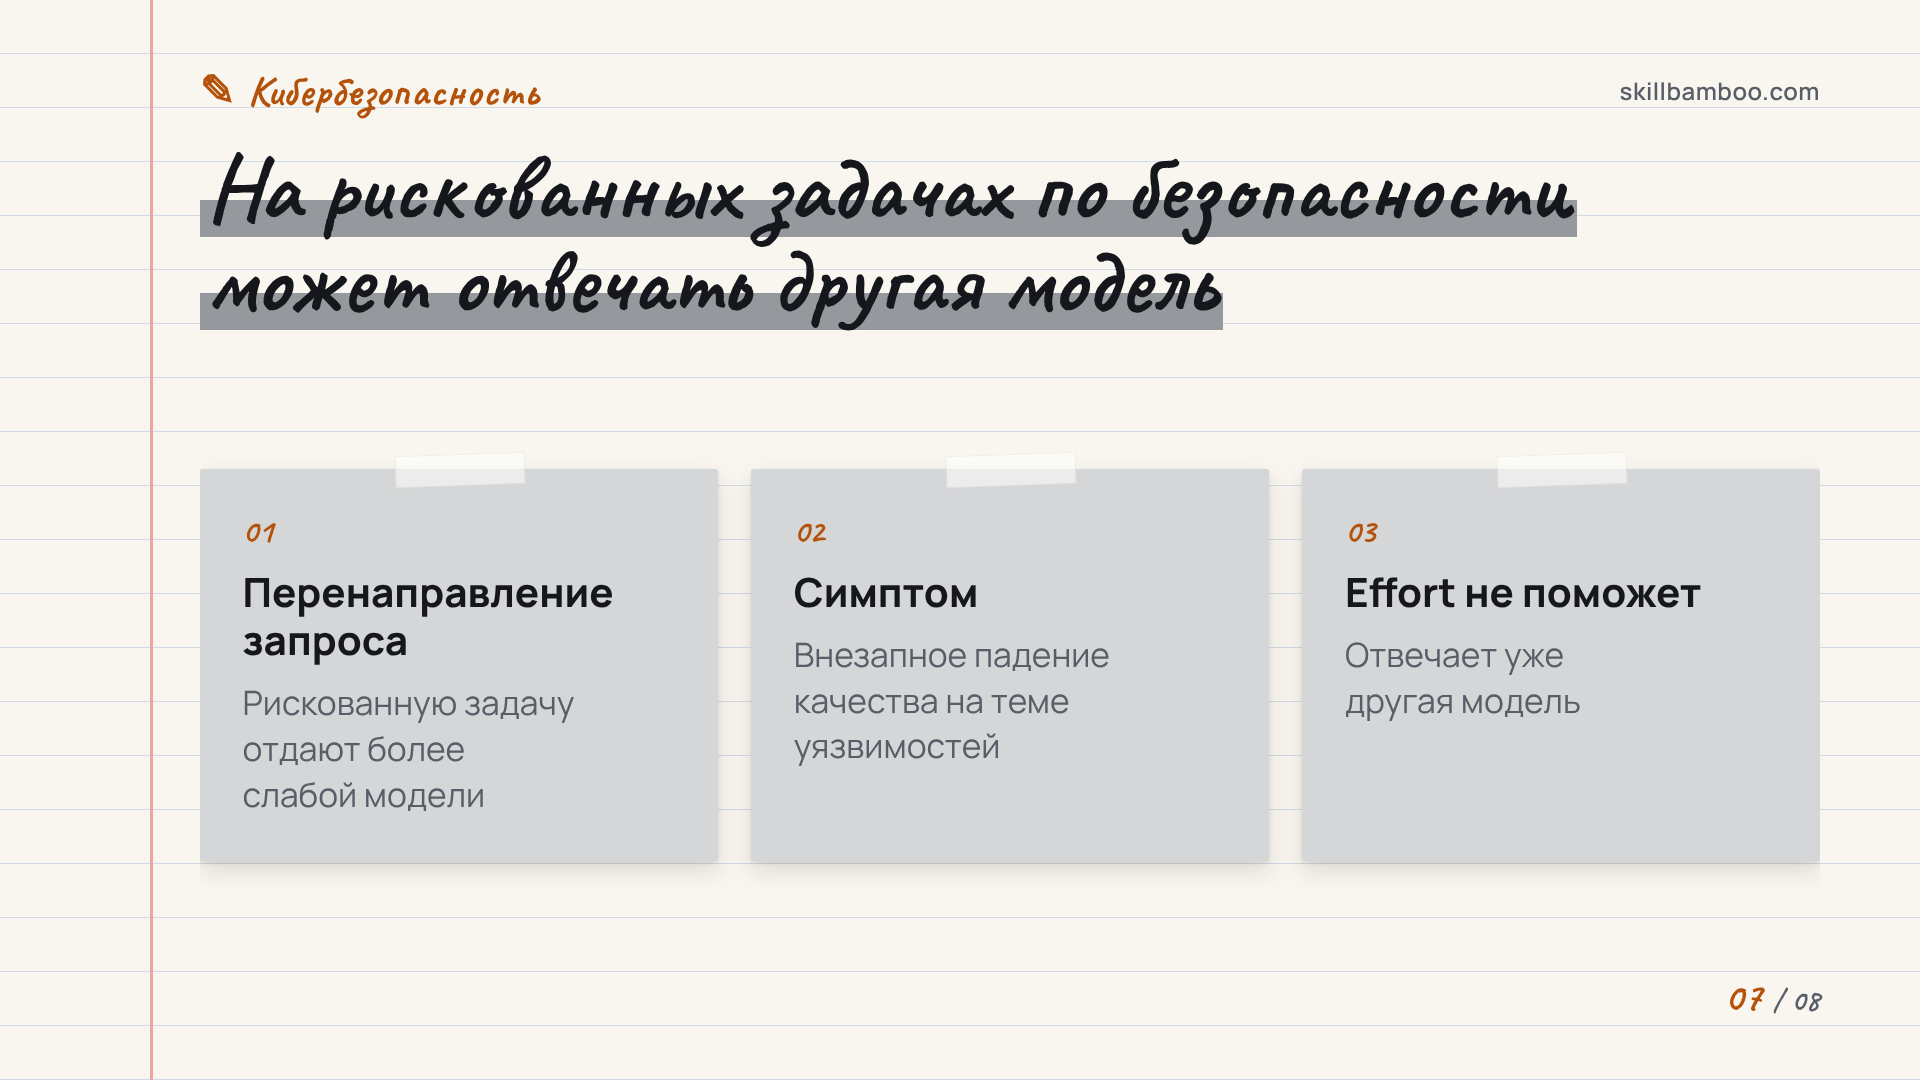
У нового Sonnet есть особенность, о которой лучше знать заранее. Если защитные классификаторы сочтут запрос рискованной задачей из области кибербезопасности, его перезапустят на более слабой модели – Sonnet 5.
На практике это выглядит как внезапное падение качества: минуту назад ответы были сильными, а на задаче про уязвимость или анализ атаки – заметно проще. Поднимать effort в такой ситуации бесполезно: отвечает уже другая модель, и Claude Code сообщает об этом в ленте сессии.
Безопасность – отдельный случай
Если вы занимаетесь аудитом, тестированием на проникновение или разбором уязвимостей и видите, что качество ответов резко просело, причина может быть в перенаправлении запроса. Учтите, что похожие защиты есть и у Opus, так что смена модели не всегда поможет; специалистам по защите имеет смысл обратить внимание на Cyber Verification Program.
Ключевые термины
- Effort – Настройка, задающая, сколько модель рассуждает и проверяет перед ответом; чем выше уровень, тем больше токенов, времени и денег.
- Xhigh (extra high) – Уровень effort между high и max; в тексте его также называют extra.
- Ultracode – Отдельная настройка Claude Code, а не уровень effort: запускает динамические рабочие процессы.
- Кэш-чтение – Повторная отправка уже закэшированного контекста, которая оплачивается по сниженной цене.
- Определение готовности (definition of done) – Объективный критерий, по которому можно проверить, что задача выполнена.
- Бенчмарк – Стандартный набор задач для сравнения моделей по качеству и стоимости.
Итог
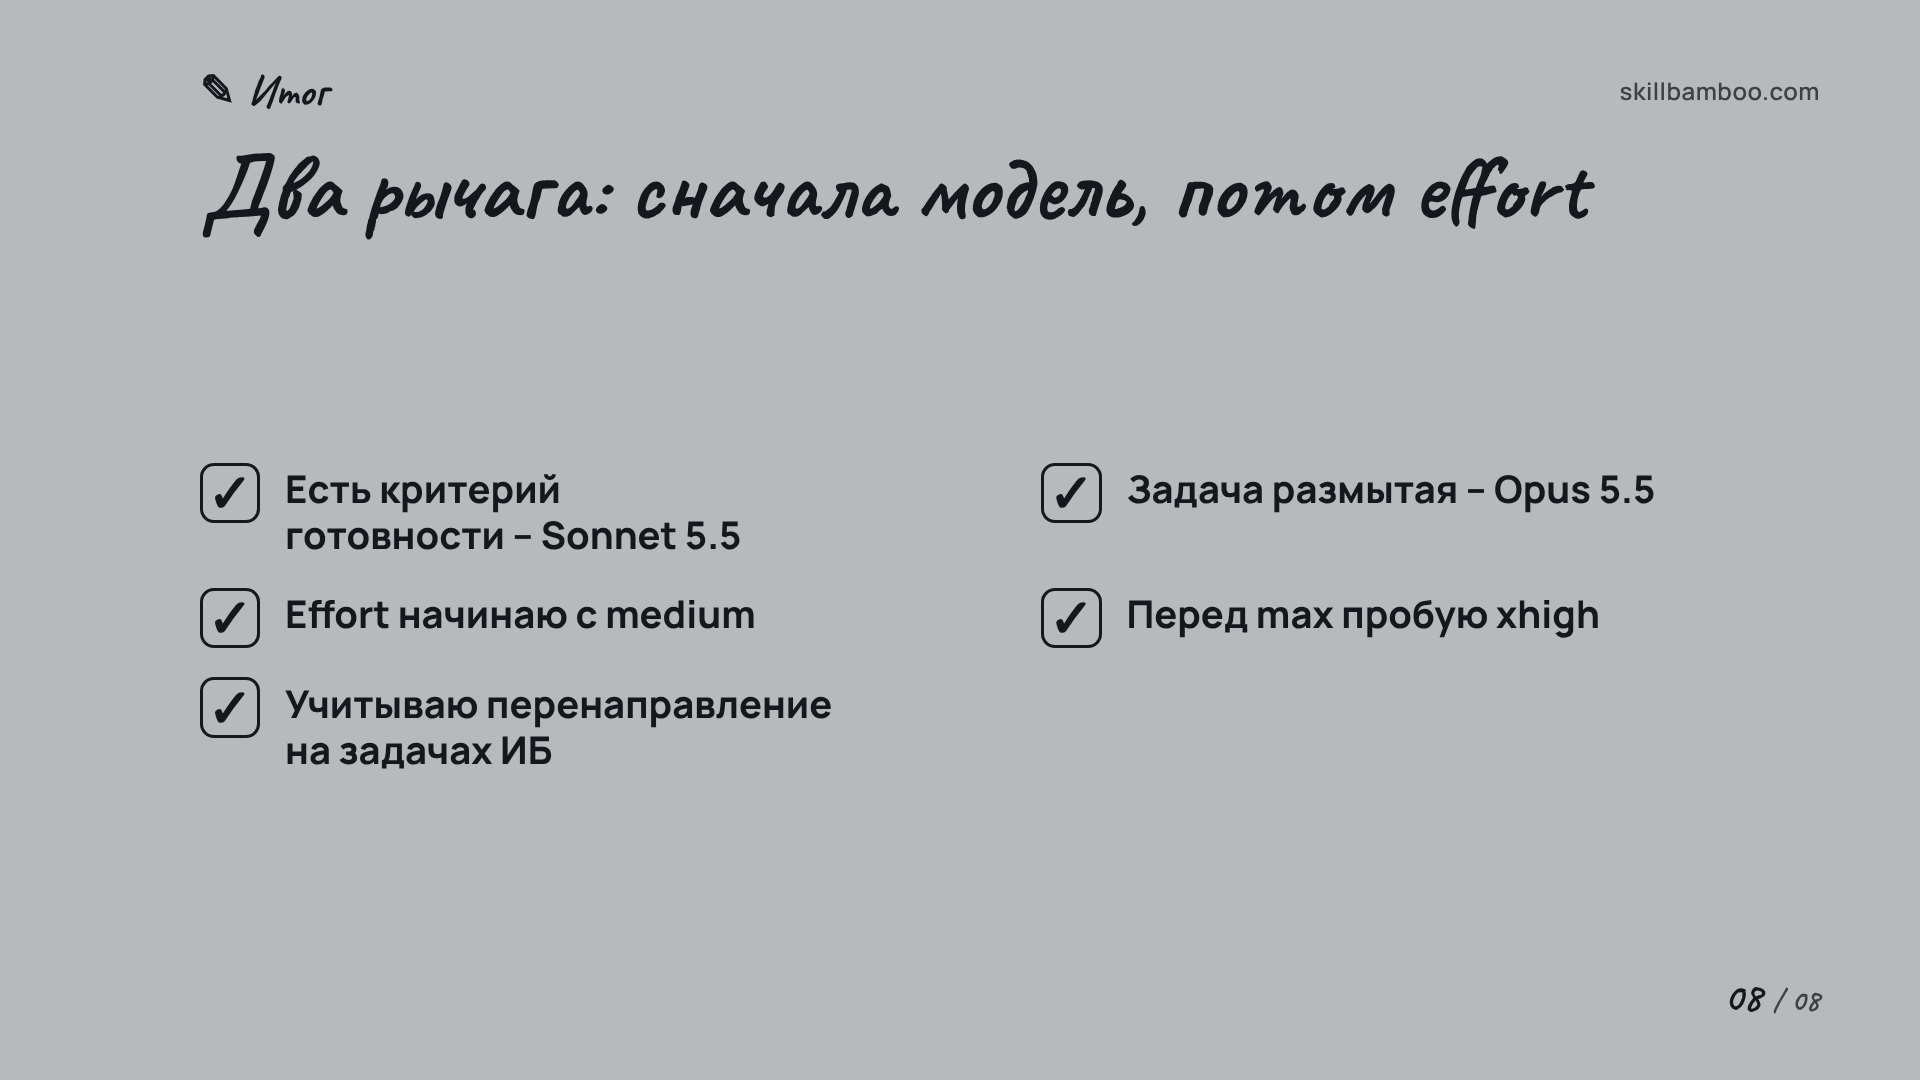
Главное: модель и effort – два разных рычага. Модель выбирайте по тому, насколько чётко поставлена задача: есть ТЗ и способ проверки – Sonnet 5.5, нужно додумать цель – Opus 5.5. Effort – по сложности задачи, начиная с medium. По стоимости он двигает счёт сильнее модели: разница между low и max на одной задаче доходила до 12,9 раза.
- Есть объективный критерий готовности – запускаю Sonnet 5.5.
- Задача размытая и нужны идеи – беру Opus 5.5.
- Начинаю с effort medium и поднимаю по одной ступени.
- Перед max пробую xhigh.
- При резком падении качества на задачах по безопасности учитываю возможное перенаправление запроса.
Проверьте себя
1. Нужно поправить баг по понятному описанию, есть тесты для проверки. Что выбрать?
- А. Opus 5.5 на low – дешевле Sonnet
- Б. Sonnet 5.5, effort medium или high
- В. Opus 5.5 на max – надёжнее
Показать ответ
Ответ: Б. Есть чёткое ТЗ и способ проверить результат – это зона Sonnet, а max только увеличит счёт.
2. Вы просите «придумай стратегию роста на квартал» без деталей. Какая модель вероятнее даст лучший результат с первой попытки?
- А. Sonnet 5.5 – он же новее
- Б. Opus 5.5
- В. Разницы не будет при любом промпте
Показать ответ
Ответ: Б. На размытых задачах Opus лучше додумывает цель и выходит за рамки запроса.
3. Почему уровень max не стоит ставить по умолчанию?
- А. Стоимость растёт резко, а качество может даже упасть
- Б. Max всегда даёт лучший результат, но медленнее
- В. Max недоступен в подписке
Показать ответ
Ответ: А. В тестах max стоил кратно больше и не был лучше extra или high.
4. Что из этого верно о стоимости? (Верных ответов несколько.)
- А. Чтение из кэша у Sonnet вдвое дешевле, чем у Opus
- Б. Opus всегда в итоге вдвое дороже Sonnet
- В. Разброс по уровням effort может быть больше, чем разница в цене моделей
Показать ответ
Ответ: А, В. А – У Sonnet вдвое дешевле и вход, и выход, и чтение из кэша. В – Между low и max стоимость одной задачи отличалась в 12,9 раза, а модели отличаются в цене вдвое.
5. У вас есть отлаженный скилл, который описывает, как выглядит хороший результат. Что это меняет?
- А. Со скиллами нужно ставить только Opus
- Б. Скилл требует effort max
- В. Можно смело брать Sonnet: скилл задаёт критерии, и результаты моделей сближаются
Показать ответ
Ответ: В. Скилл работает как чёткое ТЗ, а это сильная сторона Sonnet.