SkillBamboo
В споре llama.cpp vs Ollama одни уверяют, что Ollama ставится за пять минут и больше ничего не нужно, другие – что «нормальные люди» ставят llama.cpp, а Ollama только всё замедляет. Вы уже подняли сервер с видеокартой и не понимаете, переделывать или нет: цифр в спорах обычно никто не приводит. Разберемся, как два движка ведут себя на одной модели под одиночной и параллельной нагрузкой, сколько стоит удобство и какую обвязку нужно собрать вокруг модели, чтобы ею пользовались клиенты.
Ollama и llama.cpp: это не конкуренты, а надстройка и движок
Спор «Ollama или llama.cpp» звучит как выбор между двумя технологиями, но на самом деле одна построена поверх другой. Ollama появилась в 2023 году как инструмент, который снимает с пользователя всю возню с локальным запуском LLM и инференса (получения ответа от модели), а внутри у неё работал тот же llama.cpp. В 2025 году у Ollama появился собственный движок на GGML, но в 2026-м для моделей формата GGUF она вернулась к llama.cpp. По сути, это обёртка: команды в духе Docker, скачивание и хранение моделей, сервис, который сам стартует с системой.
Значит, сравнивать нужно не то, какой движок умнее, а то, сколько стоит удобная обёртка. Замеры обоих вариантов оценивают эту цену в несколько процентов производительности. За них вы получаете привычный CLI (интерфейс командной строки), управление моделями и запуск без сборки из исходников. Заметный минус у Ollama один: модель, которую выгрузили из памяти, долго стартует заново, но и это настраивается.
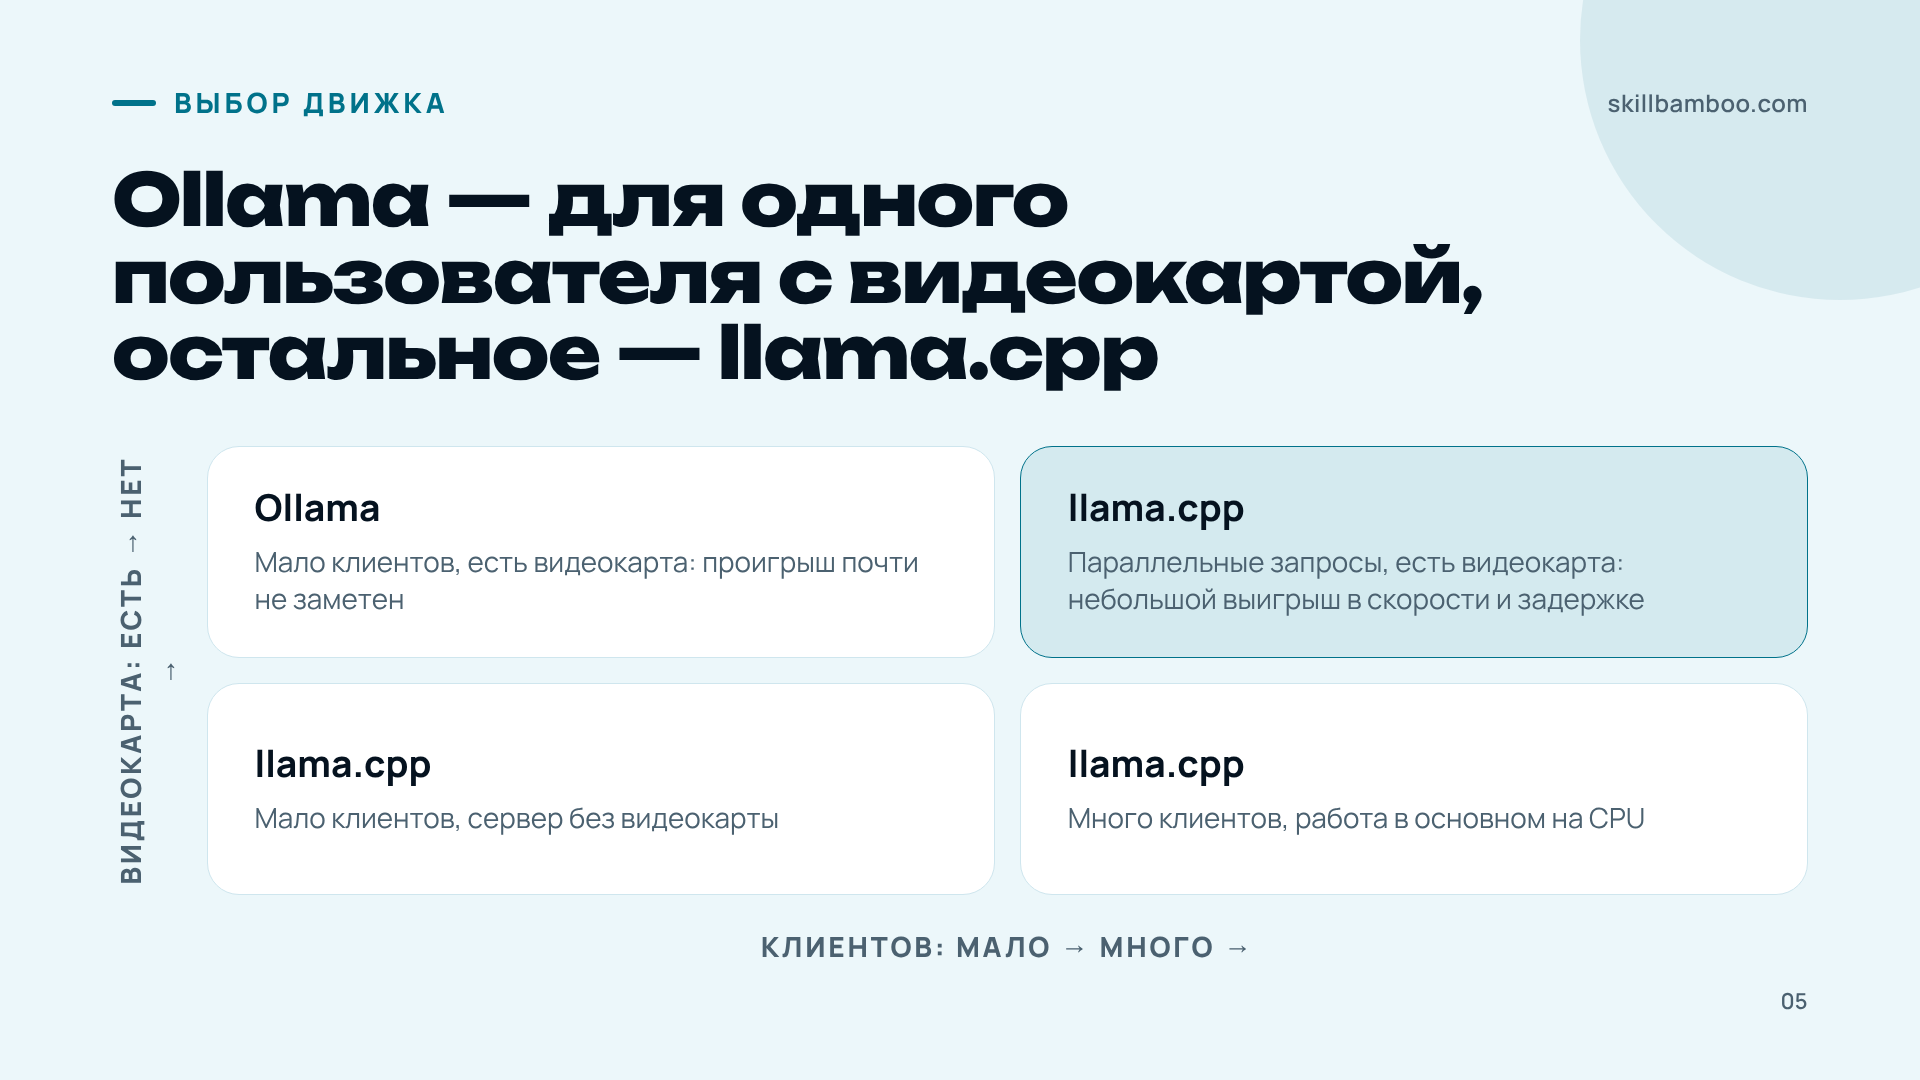
Для экспериментов и небольшой нагрузки разница почти не ощущается. Когда к модели одновременно приходят несколько клиентов, llama.cpp постепенно отрывается, но и тогда разрыв невелик.
Ollama и llama.cpp на сервере: сколько шагов у каждого
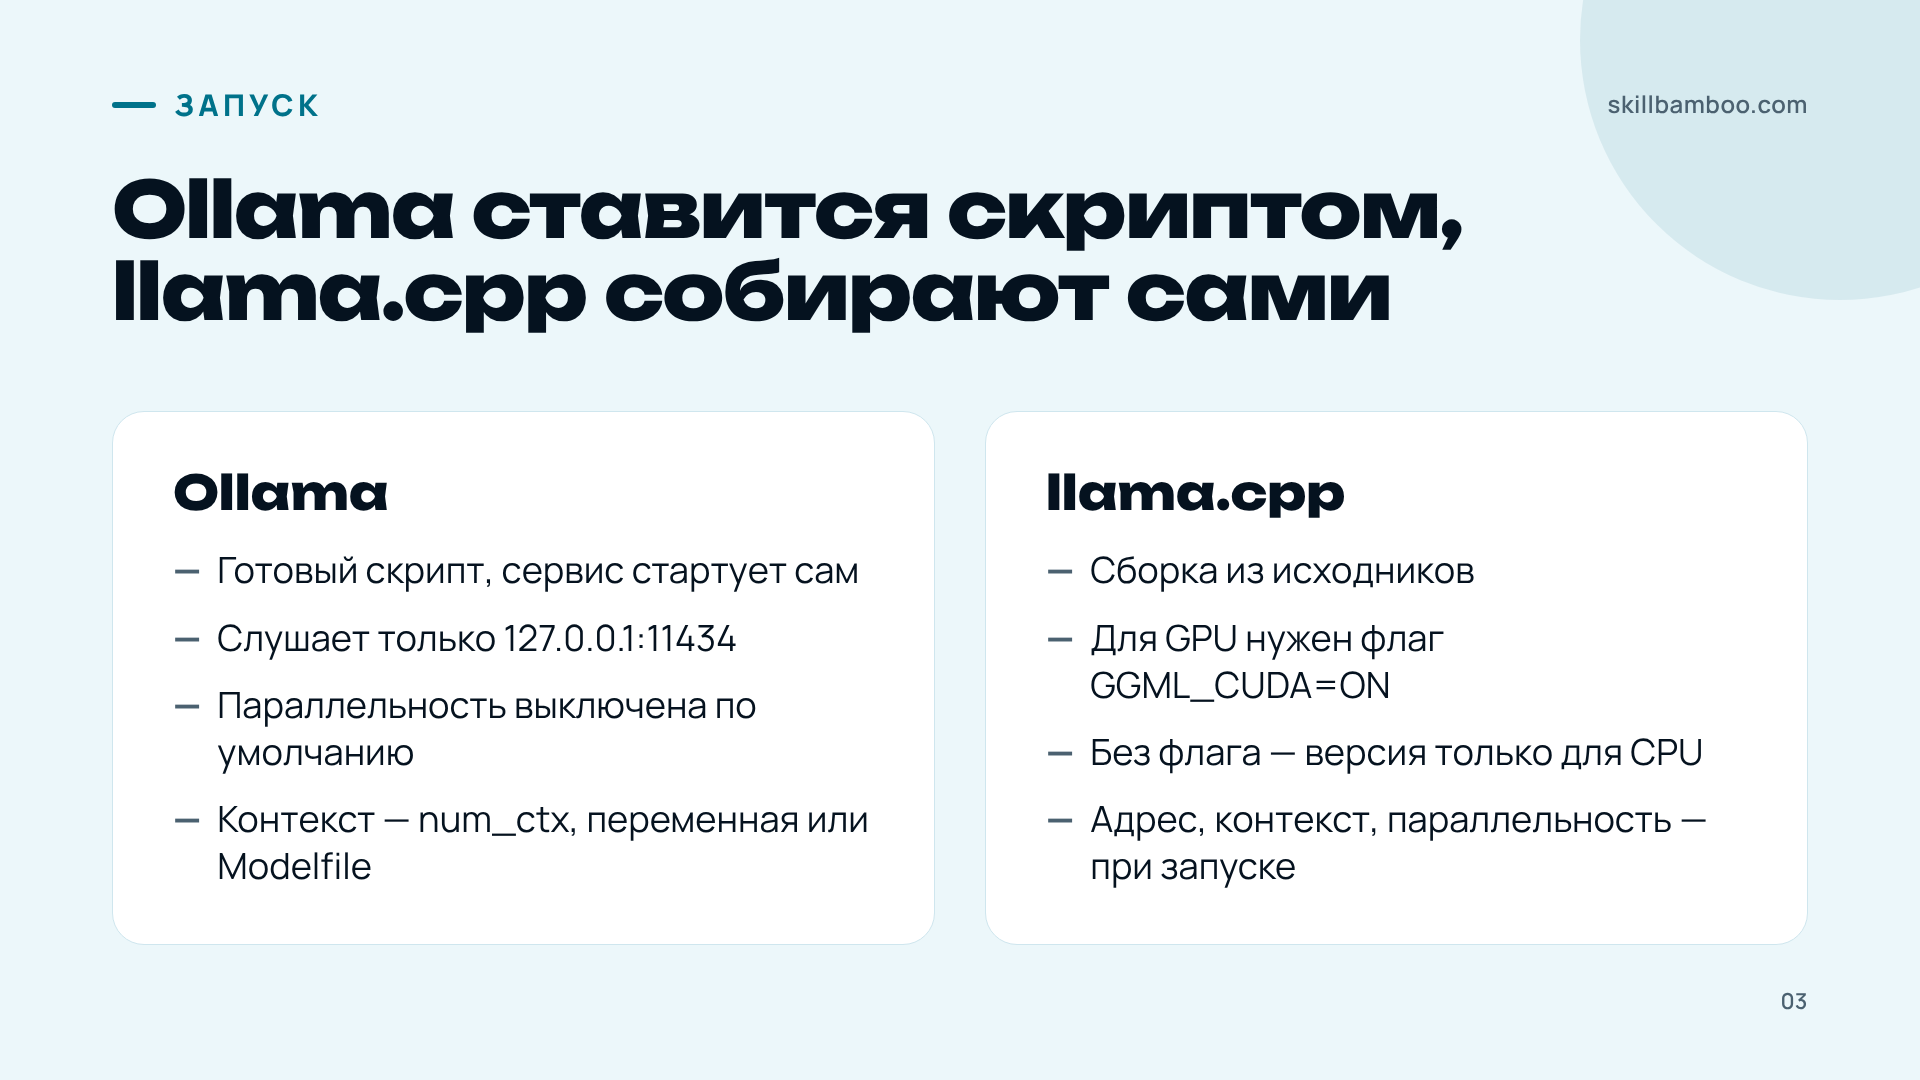
Отличия начинаются с первой команды. Ollama ставится одним скриптом и сразу работает как системный сервис. llama.cpp нужно собрать: склонировать репозиторий, поставить инструменты сборки и компилятор CUDA, а затем собрать проект с флагом GGML_CUDA=ON. Если флаг забыть, получится версия только для процессора – и видеокарта будет простаивать.
llama.cpp – How to build – сборка llama.cpp с поддержкой CUDA
| Что настраиваем | Ollama | llama.cpp |
|---|---|---|
| Установка | Готовый скрипт, сервис стартует сам | Сборка из исходников, для GPU – флаг GGML_CUDA=ON |
| Сетевой доступ | По умолчанию только 127.0.0.1:11434 |
Адрес и порт задаются при запуске сервера |
| Размер контекста | num_ctx в запросе к нативному API, OLLAMA_CONTEXT_LENGTH или алиас модели в Modelfile |
Параметр при запуске сервера |
| Параллельные запросы | По умолчанию по одному, включается OLLAMA_NUM_PARALLEL |
Параметр при запуске сервера |
Две строки таблицы особенно часто приводят к сюрпризам. Первая – сеть: Ollama после установки слушает только локальный адрес, и снаружи к ней не подключиться. Для безопасности это хорошо, но если вы ждёте, что приложение на соседней машине сразу увидит модель, придётся разбираться с настройками.
Вторая – контекст, то есть сколько текста модель держит в одном запросе. В Ollama размер окна задают параметром num_ctx в запросе к нативному API или переменной OLLAMA_CONTEXT_LENGTH для всего сервера. Через OpenAI-совместимый API это неудобно: тогда создают отдельный вариант модели через Modelfile с нужным значением.
Параллельность в Ollama выключена
По умолчанию Ollama обрабатывает запросы строго по очереди. Если вы тестируете сервис под нагрузкой и удивляетесь задержкам, сначала проверьте OLLAMA_NUM_PARALLEL.
Замеры на одной модели: один запрос и параллельная нагрузка
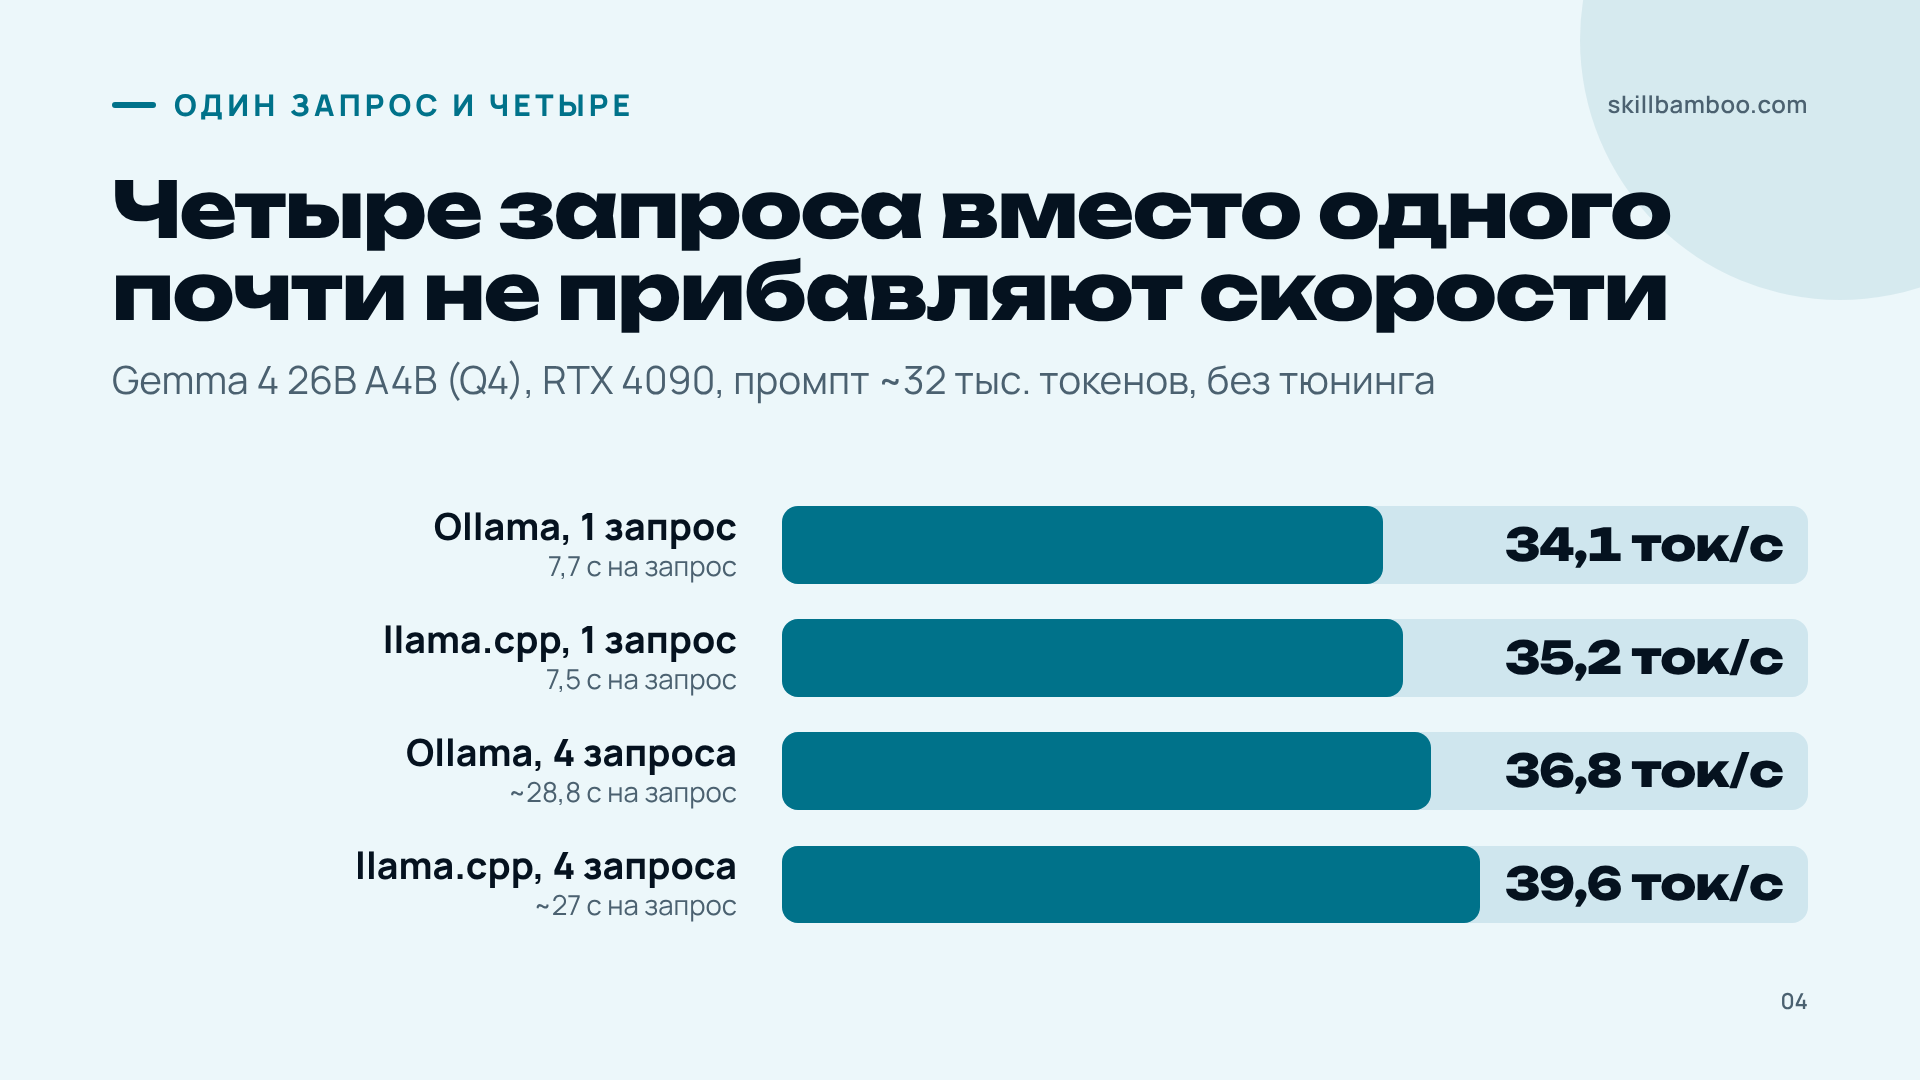
Честное сравнение возможно, только когда всё остальное одинаково. Оба движка запускали одну и ту же Gemma 4 26B A4B в кванте Q4_0 на RTX 4090 с 24 ГБ. Это MoE-модель: из 26 млрд параметров на каждый токен работает около 4 млрд. В каждом из 30 запросов – промпт примерно на 32 тысячи токенов и ответ до 256 токенов. Ручного тюнинга не было ни у одного движка – сравнивали «как из коробки».
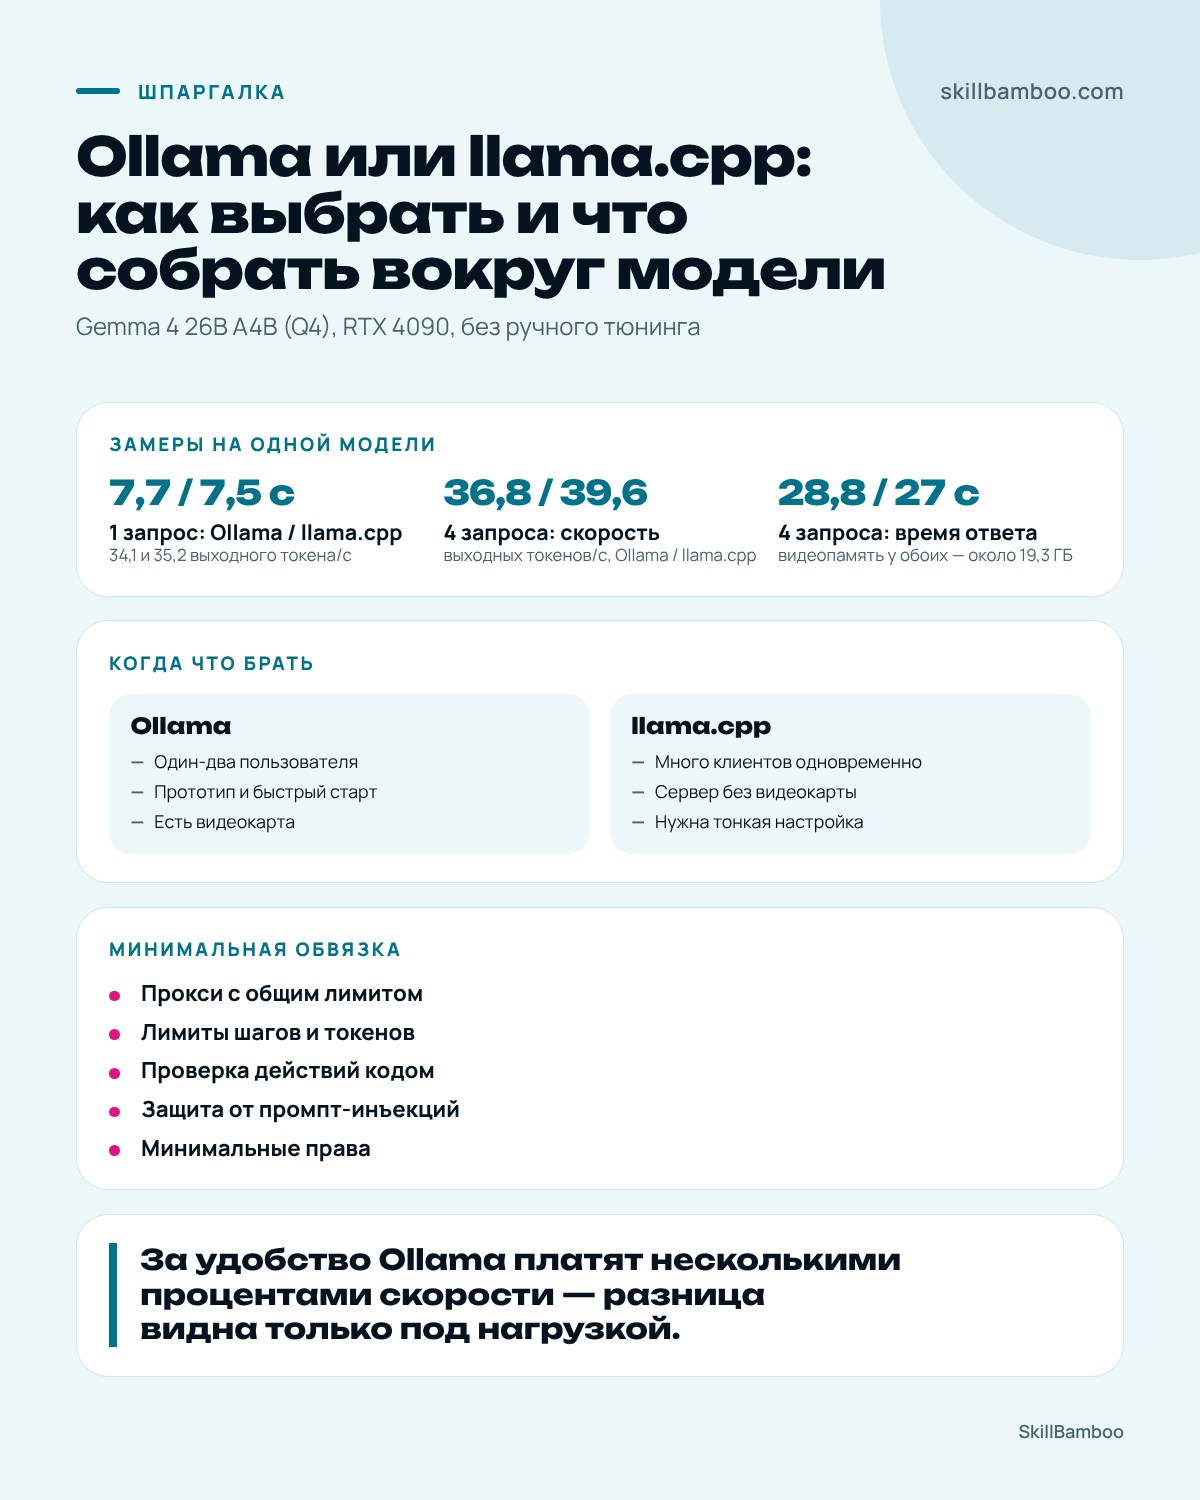
На одиночных запросах llama.cpp тратил около 7,5 с на запрос. Из них примерно 5,7 с уходило на ожидание первого токена, а дальше токены шли с интервалом около 6,9 мс. Ollama на том же тесте потратила около 7,7 с на запрос, из них примерно 5,9 с – до первого токена, при том же интервале 6,9 мс. Скорость генерации – 34,1 выходного токена/с против 35,2 у llama.cpp: разница в пределах тех самых нескольких процентов.
При параллельной нагрузке картина меняется:
| Нагрузка | Ollama | llama.cpp |
|---|---|---|
| 1 запрос за раз | ~7,7 с на запрос, ~34,1 выходного токена/с | ~7,5 с на запрос, ~35,2 выходного токена/с |
| 2 запроса одновременно | ~14,1 с на запрос, ~37,5 выходного токена/с | ~13,9 с на запрос, ~38,3 выходного токена/с |
| 4 запроса одновременно | ~28,8 с на запрос, ~36,8 выходного токена/с | ~27 с на запрос, ~39,6 выходного токена/с |
Здесь видно два эффекта. Первый: на двух одновременных запросах движки идут почти вровень, а на четырёх llama.cpp уже впереди и по скорости, и по задержке, причём видеопамяти оба занимают одинаково – около 19,3 ГБ. Второй важнее: параллельность сама по себе почти не ускоряет работу. У llama.cpp общая скорость выросла с 35,2 до 39,6 токена/с, а время ответа на каждый запрос – с 7,5 до 27 с.
Параллельность – не бесплатное ускорение
Четыре одновременных запроса не дают вчетверо больше токенов. Видеокарта делит ресурсы между ними, и каждый клиент ждёт дольше. Если для вас важна задержка, а не суммарный поток, лучше держать небольшую очередь.
Что выбрать под свой сценарий
Все зависит не от того, что быстрее вообще, а от того, как будут обращаться к модели. Сверьтесь со своим случаем:
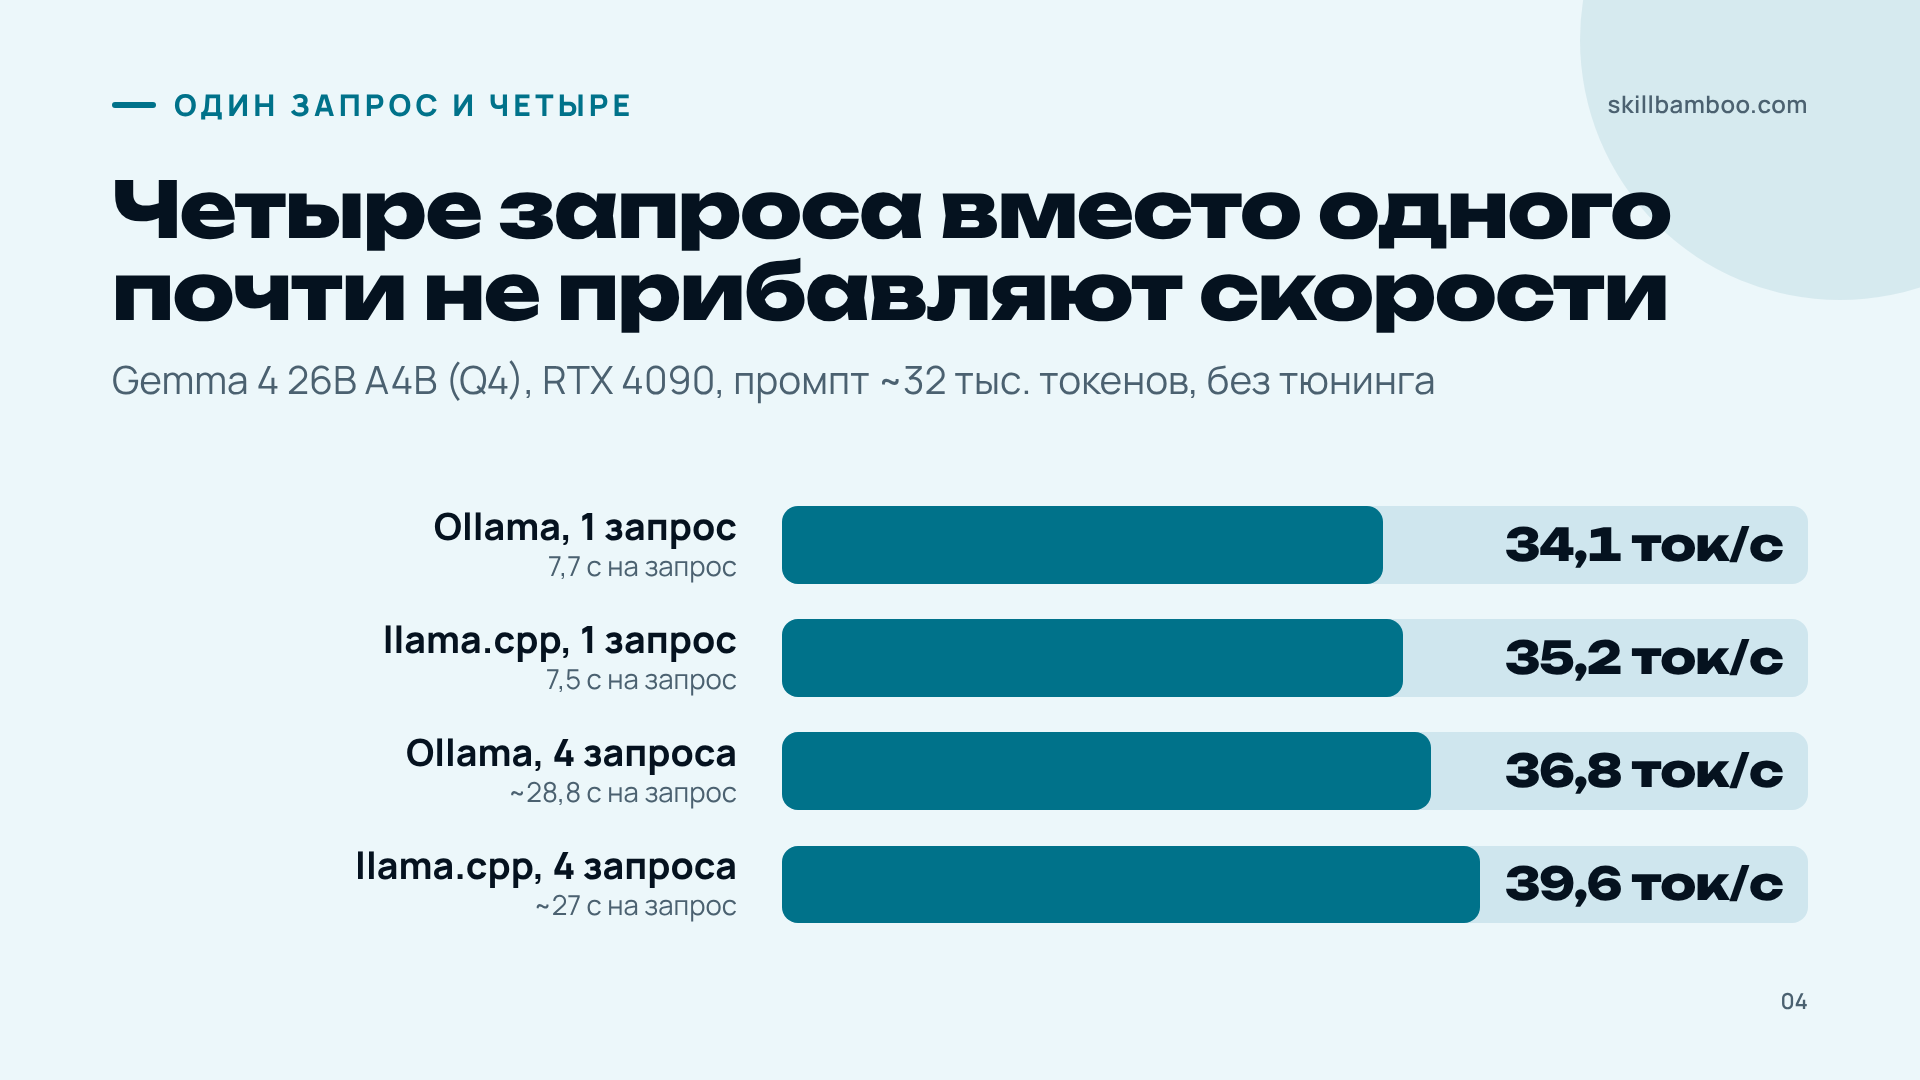
- Модель нужна вам или паре коллег, запросы приходят по одному – берите Ollama: проигрыш в скорости почти не заметен, а запуск и обновление моделей проще.
- Нужно быстро проверить идею или показать прототип – Ollama: сборка llama.cpp съест время, которое лучше потратить на сам продукт.
- К модели одновременно ходят несколько клиентов или сервисов – llama.cpp: под параллельной нагрузкой он постепенно выходит вперёд по задержке и пропускной способности.
- Сервер без видеокарты, модель будет работать в основном на CPU – разумнее llama.cpp.
- Нужна тонкая настройка параметров сервера, а не готовые значения – тоже llama.cpp.
Смена движка не требует переписывать приложение целиком: и Ollama, и llama.cpp server отдают HTTP API. Поэтому можно начать с Ollama, а когда нагрузка вырастет, перейти на llama.cpp с той же моделью.
Сервер для локальной LLM: почему запущенная модель – ещё не сервис
Движок – меньшая часть работы. Исследования корпоративных ИИ-пилотов показывают: из 33 проектов до продакшена (рабочей эксплуатации) в среднем доходят четыре, около 88% так и остаются экспериментами. Узким местом почти никогда не бывает сама модель – проблема в том, что вокруг неё.
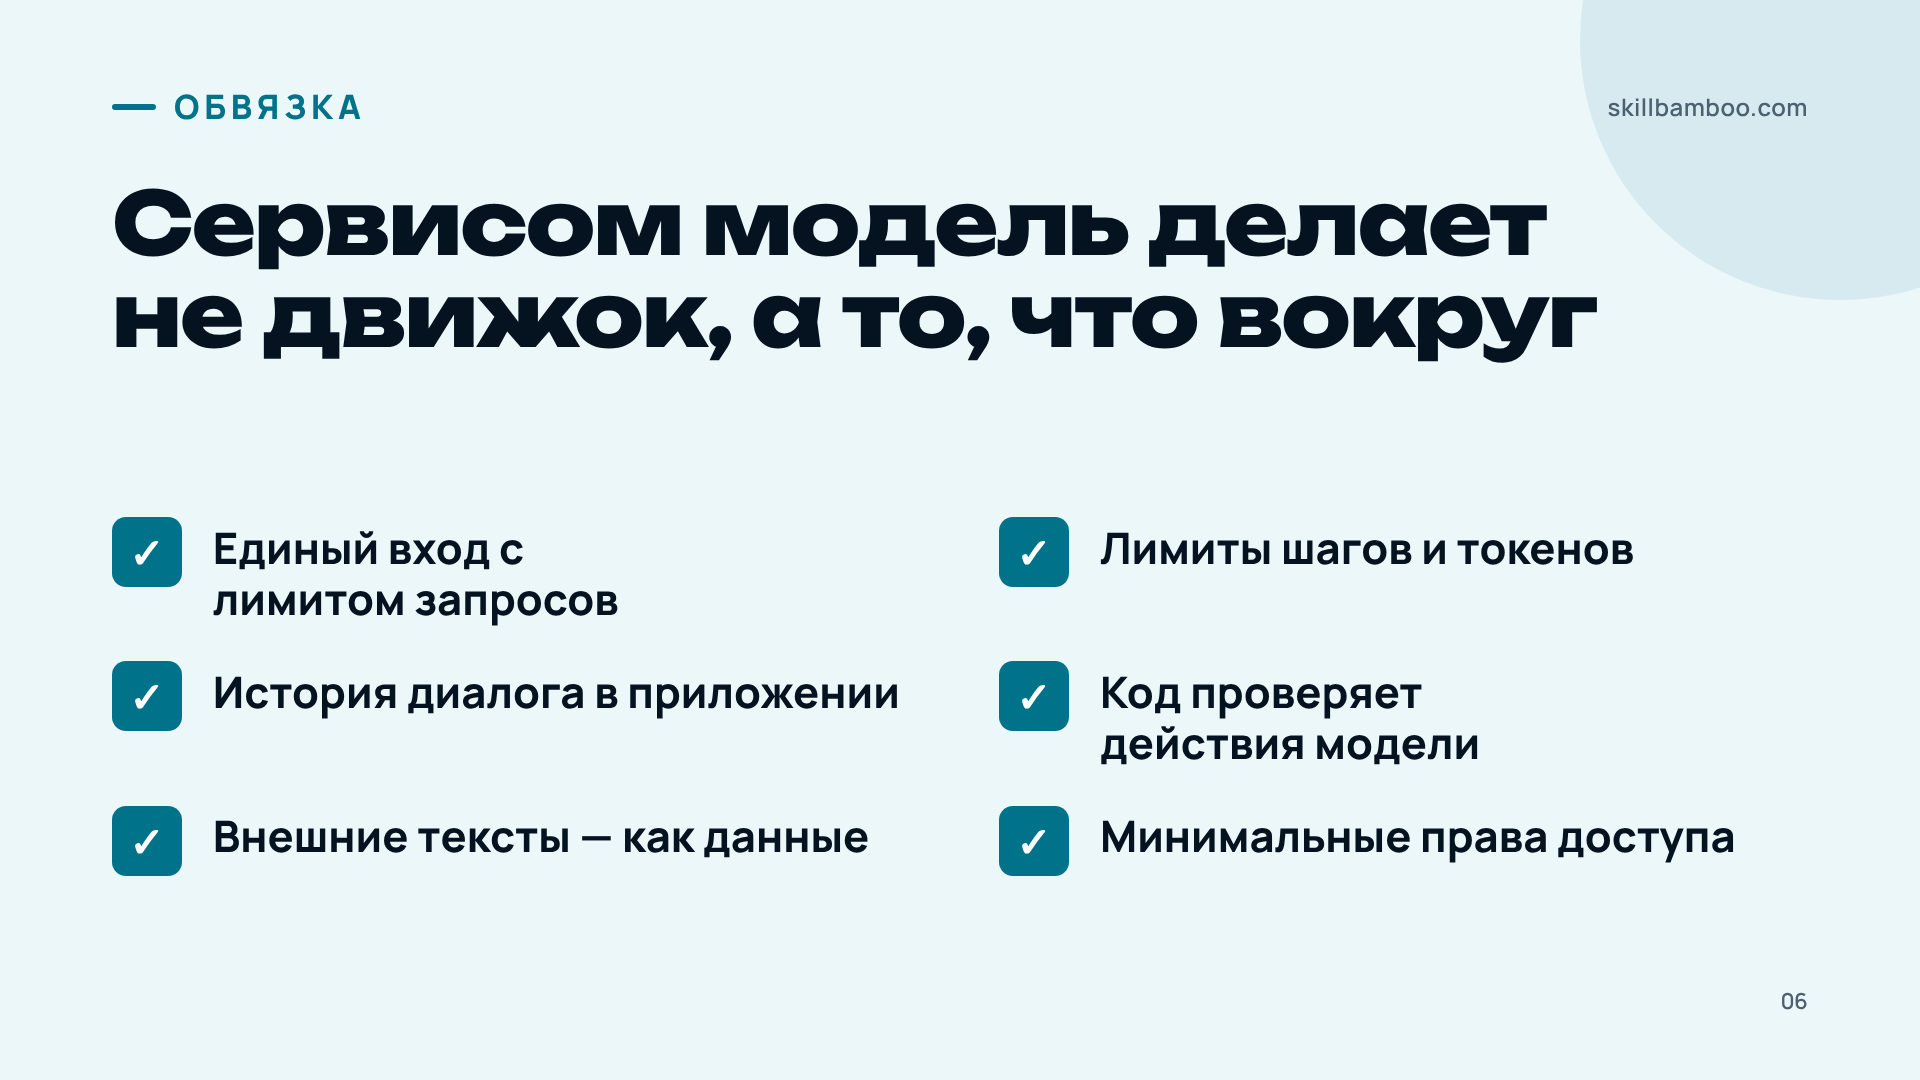
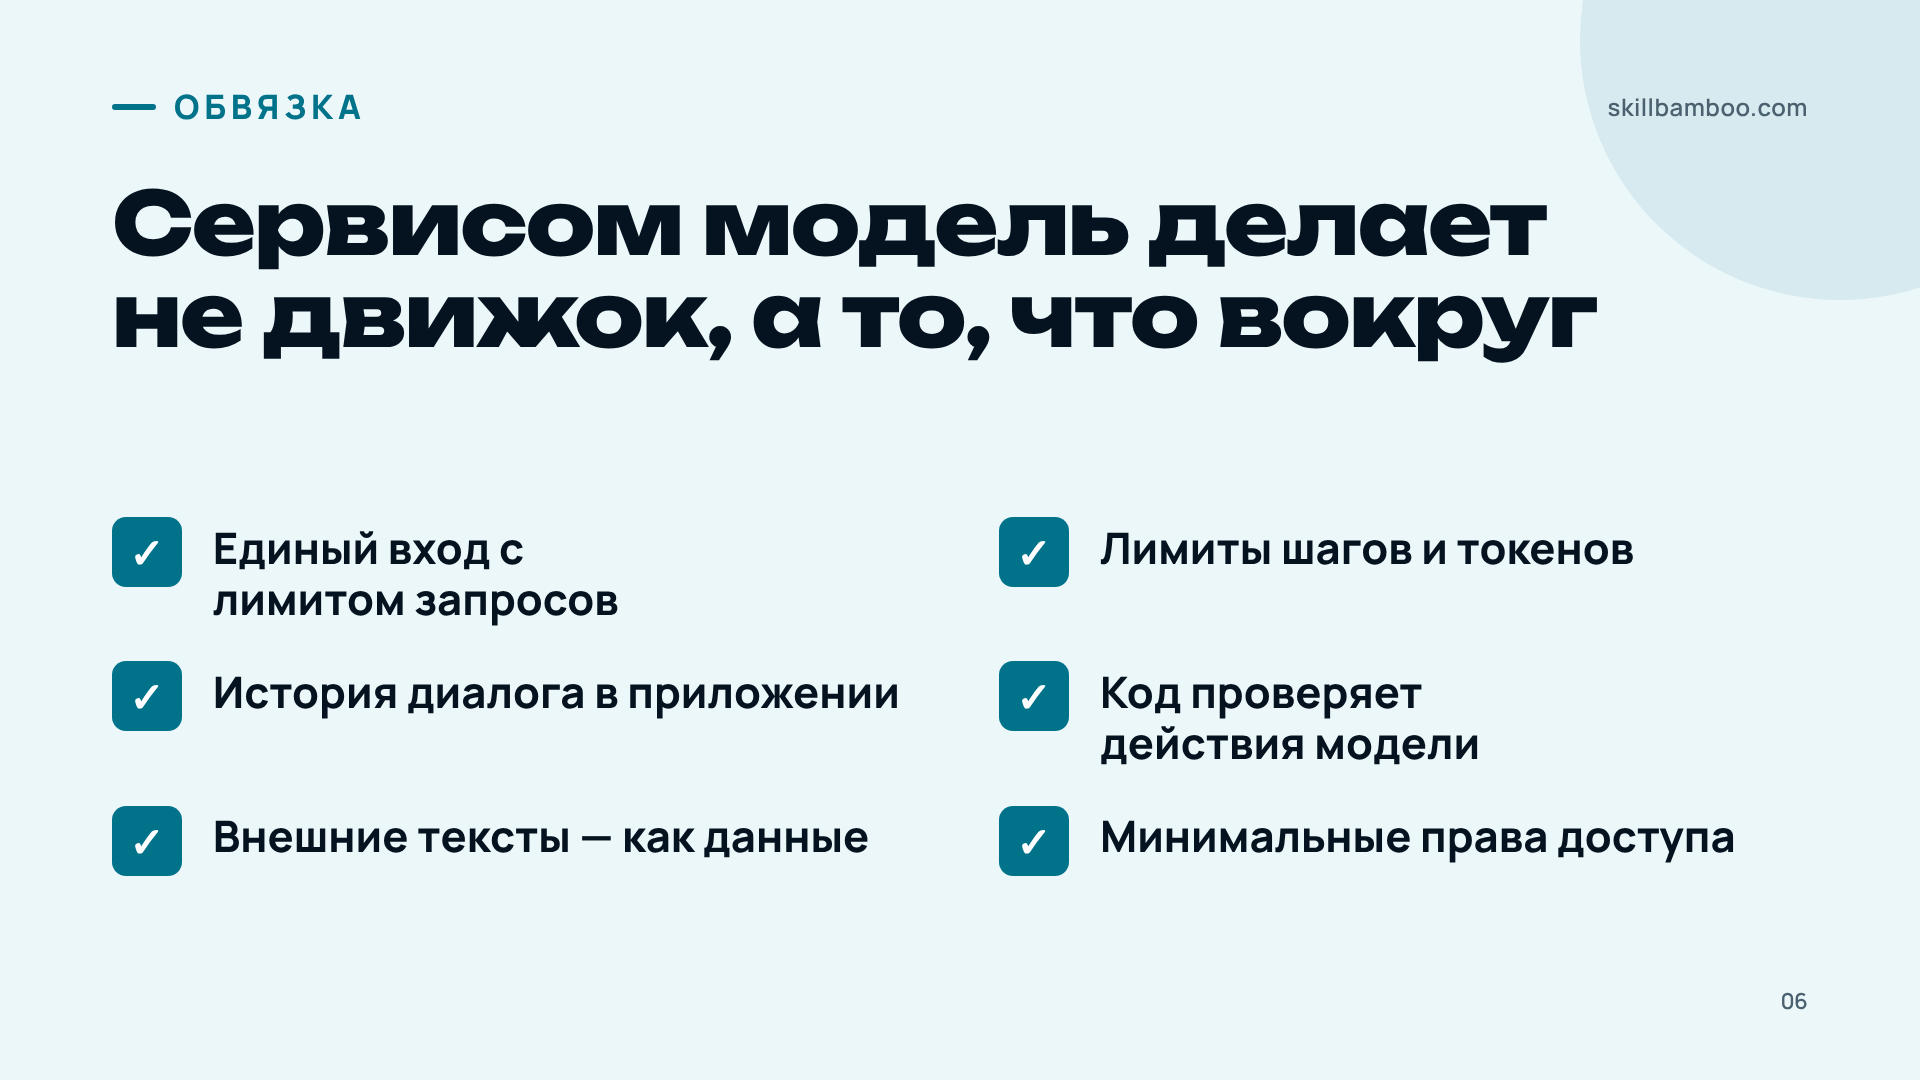
Модель получает текст и выдаёт текст. Она не знает, кто прислал запрос, имеет ли он право на эти данные и можно ли выполнять предложенное действие. Даже истории разговора у неё нет: переписку хранит приложение и каждый раз заново подкладывает в контекст. Всё это берёт на себя обвязка. Перечислим основные элементы для локальной LLM, которой будут пользоваться люди или другие сервисы:
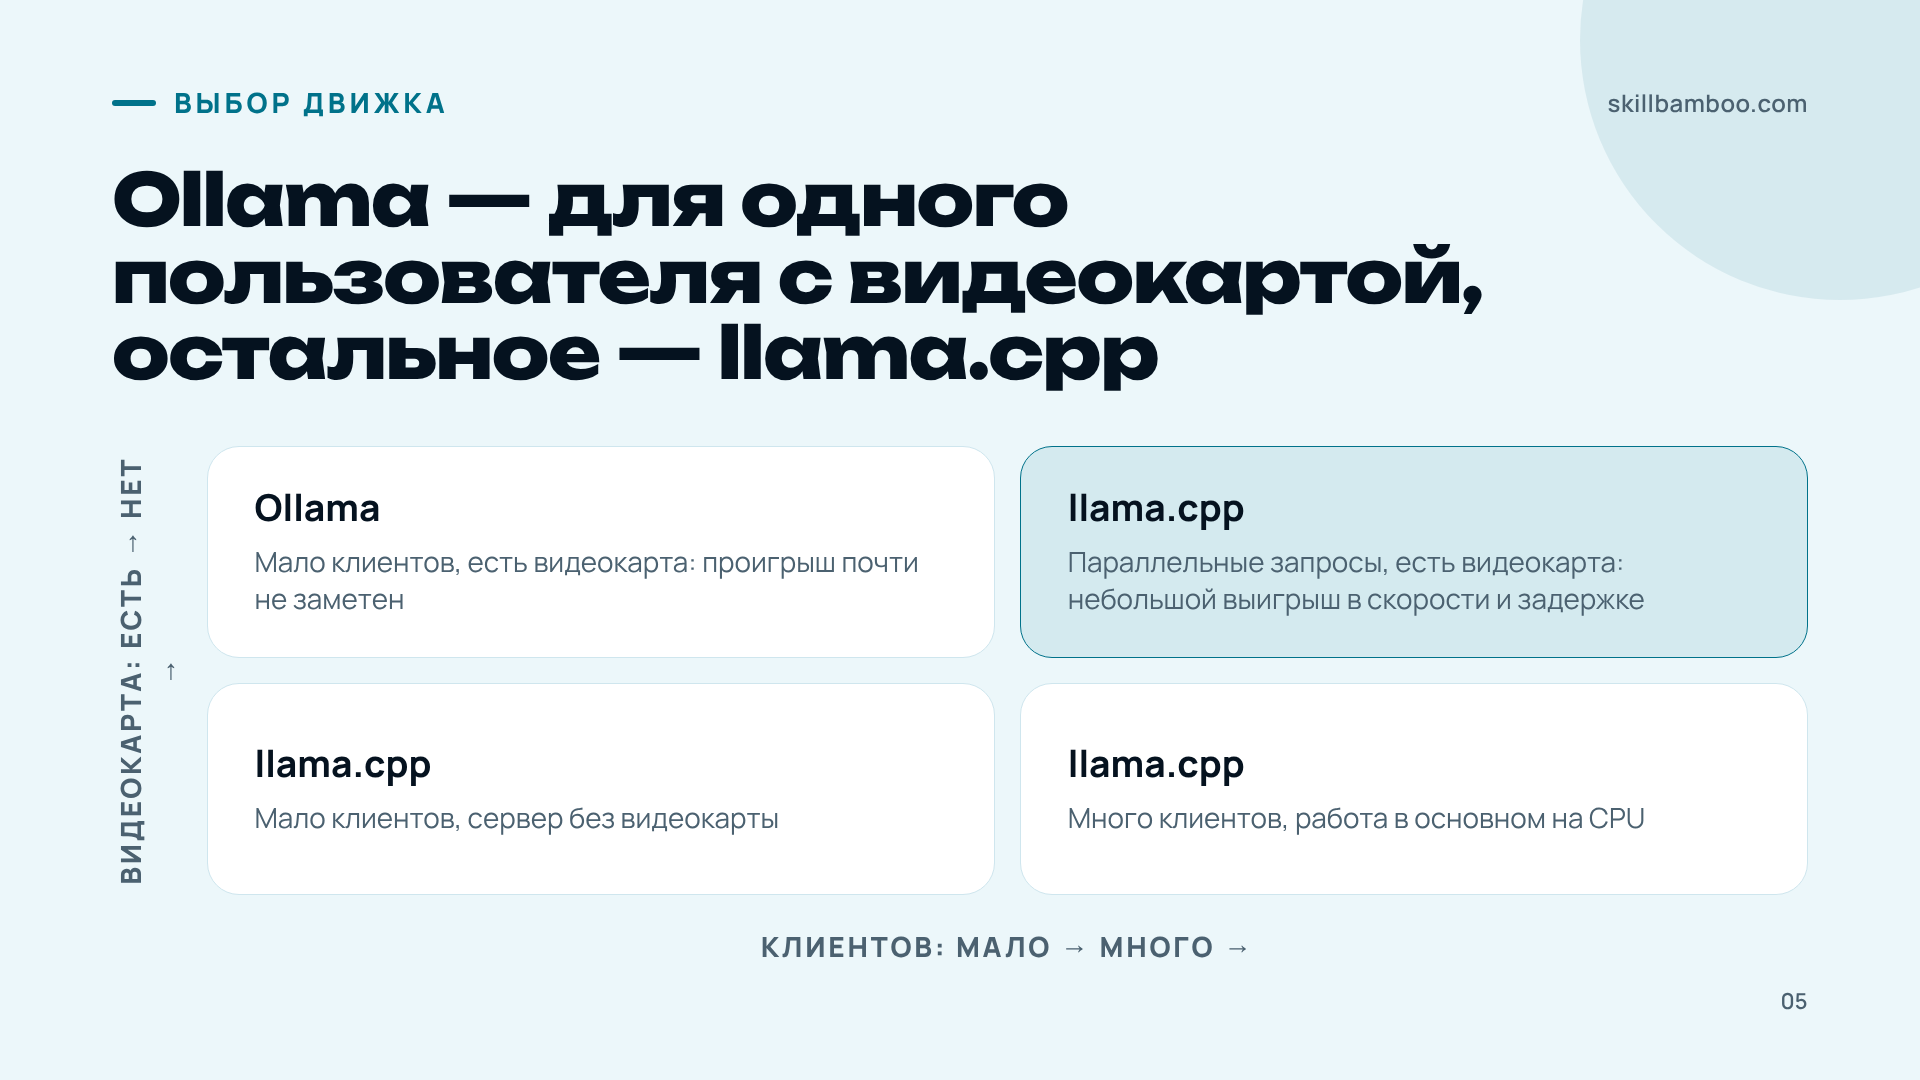
Единая точка входа с лимитом. Когда к модели обращаются несколько сервисов, каждый со своей конкурентностью, они быстро забивают очередь движка. Помогает прокси перед моделью – например, LiteLLM – с общим потолком одновременных запросов на весь трафик.
Лимиты на запрос. Ограничьте число шагов и токенов на одно обращение пользователя, кэшируйте повторяющиеся вопросы. Иначе агент может зациклиться и занять модель надолго.
Хранение истории диалога на стороне приложения.
Проверка действий. Схема простая: модель только предлагает действие, программный код проверяет поля и права, и лишь потом система его выполняет. Для критичных операций добавьте подтверждение человеком.
Защита от промпт-инъекций – чужих указаний, спрятанных во входных текстах. Тексты из документов, тикетов и ответов внешних сервисов передавайте модели как данные, а не как инструкции. И явно указывайте, чьи указания главнее.
Минимальные права. Сервису с LLM – только тот доступ, который нужен конкретному сценарию, как любому другому приложению.
Грабли NPU на мини-ПК
Мини-ПК с нейропроцессором (NPU) выглядят соблазнительно: они тихие и экономные, а маркетинг обещает ускорение ИИ. Но первое, что выясняется: ни Ollama, ни llama.cpp NPU не используют. Они работают на процессоре или видеокарте, а нейропроцессор простаивает. Для NPU нужен отдельный рантайм (среда выполнения) – например, FastFlowLM – со своими моделями и своими ограничениями.
Второе ограничение – память. На мини-ПК с Ryzen AI нейропроцессору доступна примерно половина оперативной памяти, которую видит система, а BIOS ещё и резервирует часть под встроенную графику. Модель, которая по весу вроде бы помещается, падает при втором запросе. Лечится это в BIOS: резерв памяти под встроенную графику (параметр UMA Frame Buffer Size) выставляют на минимум.
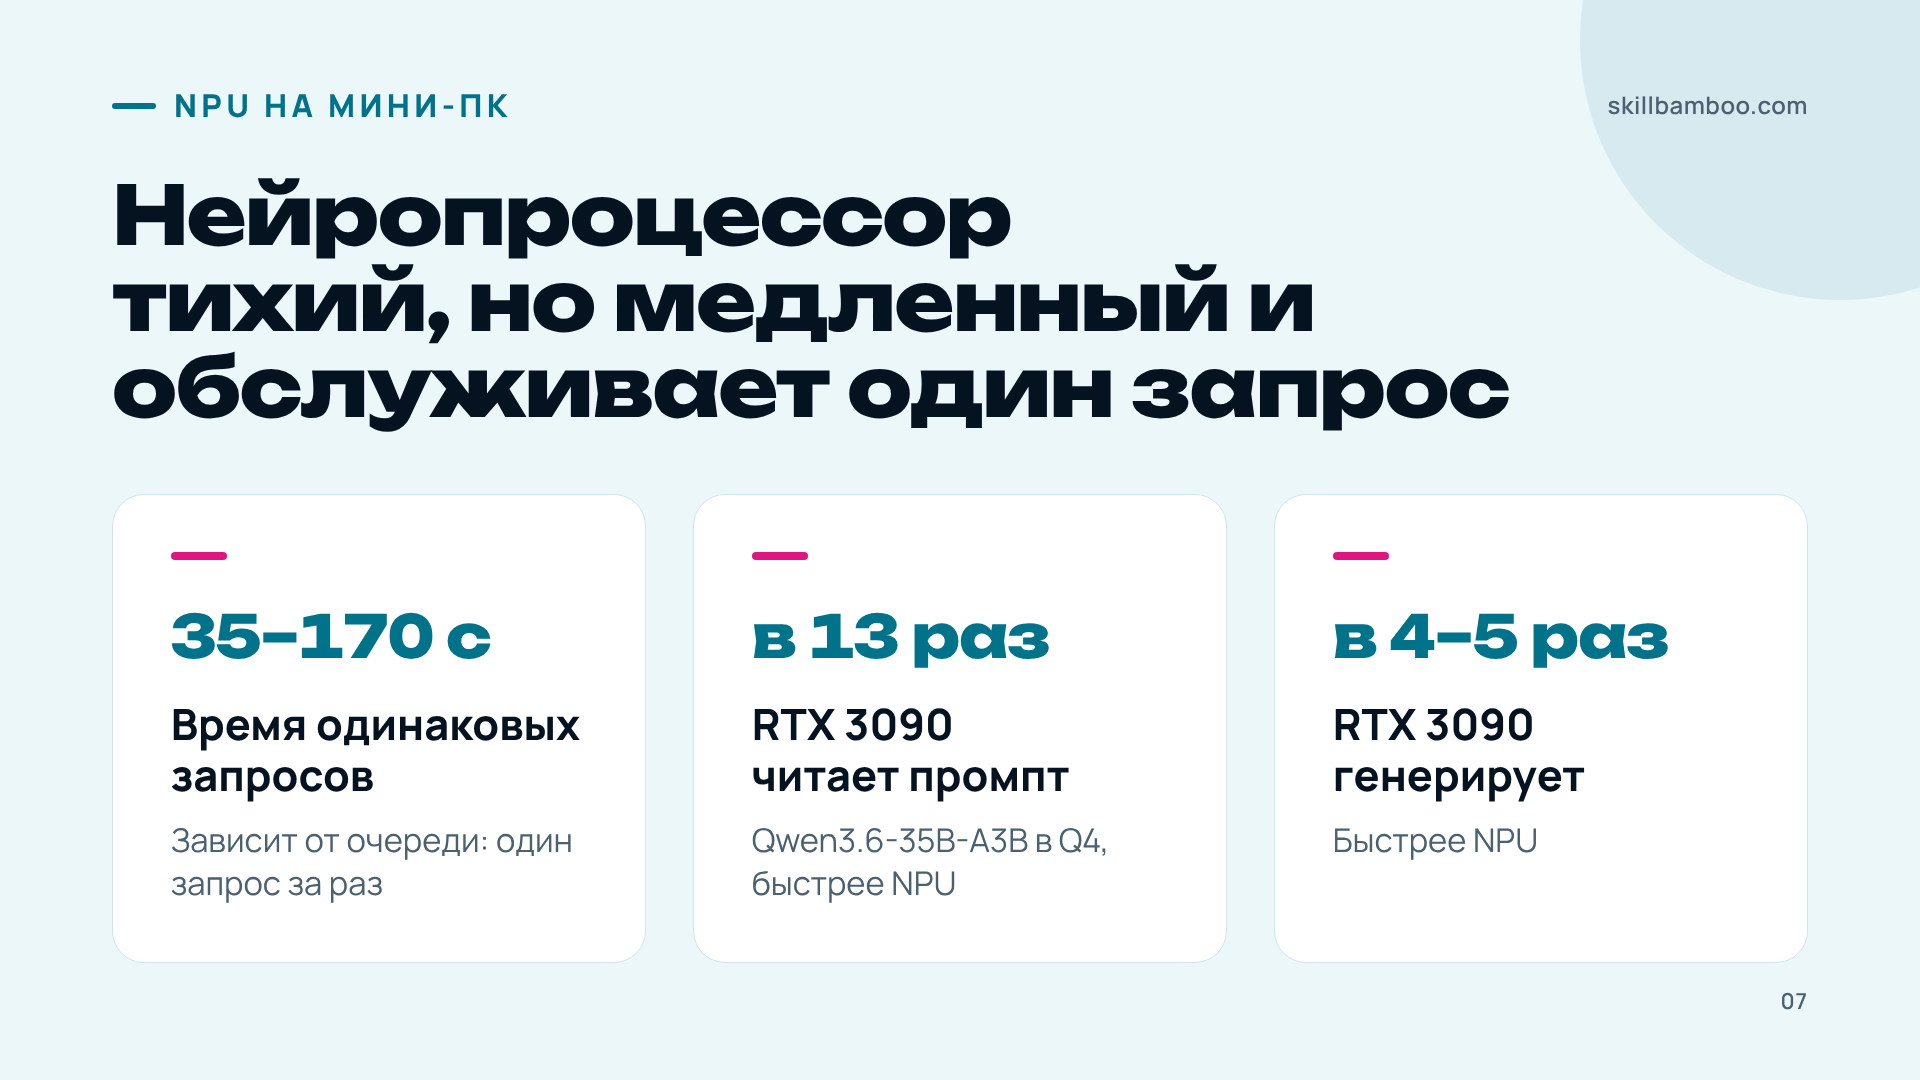
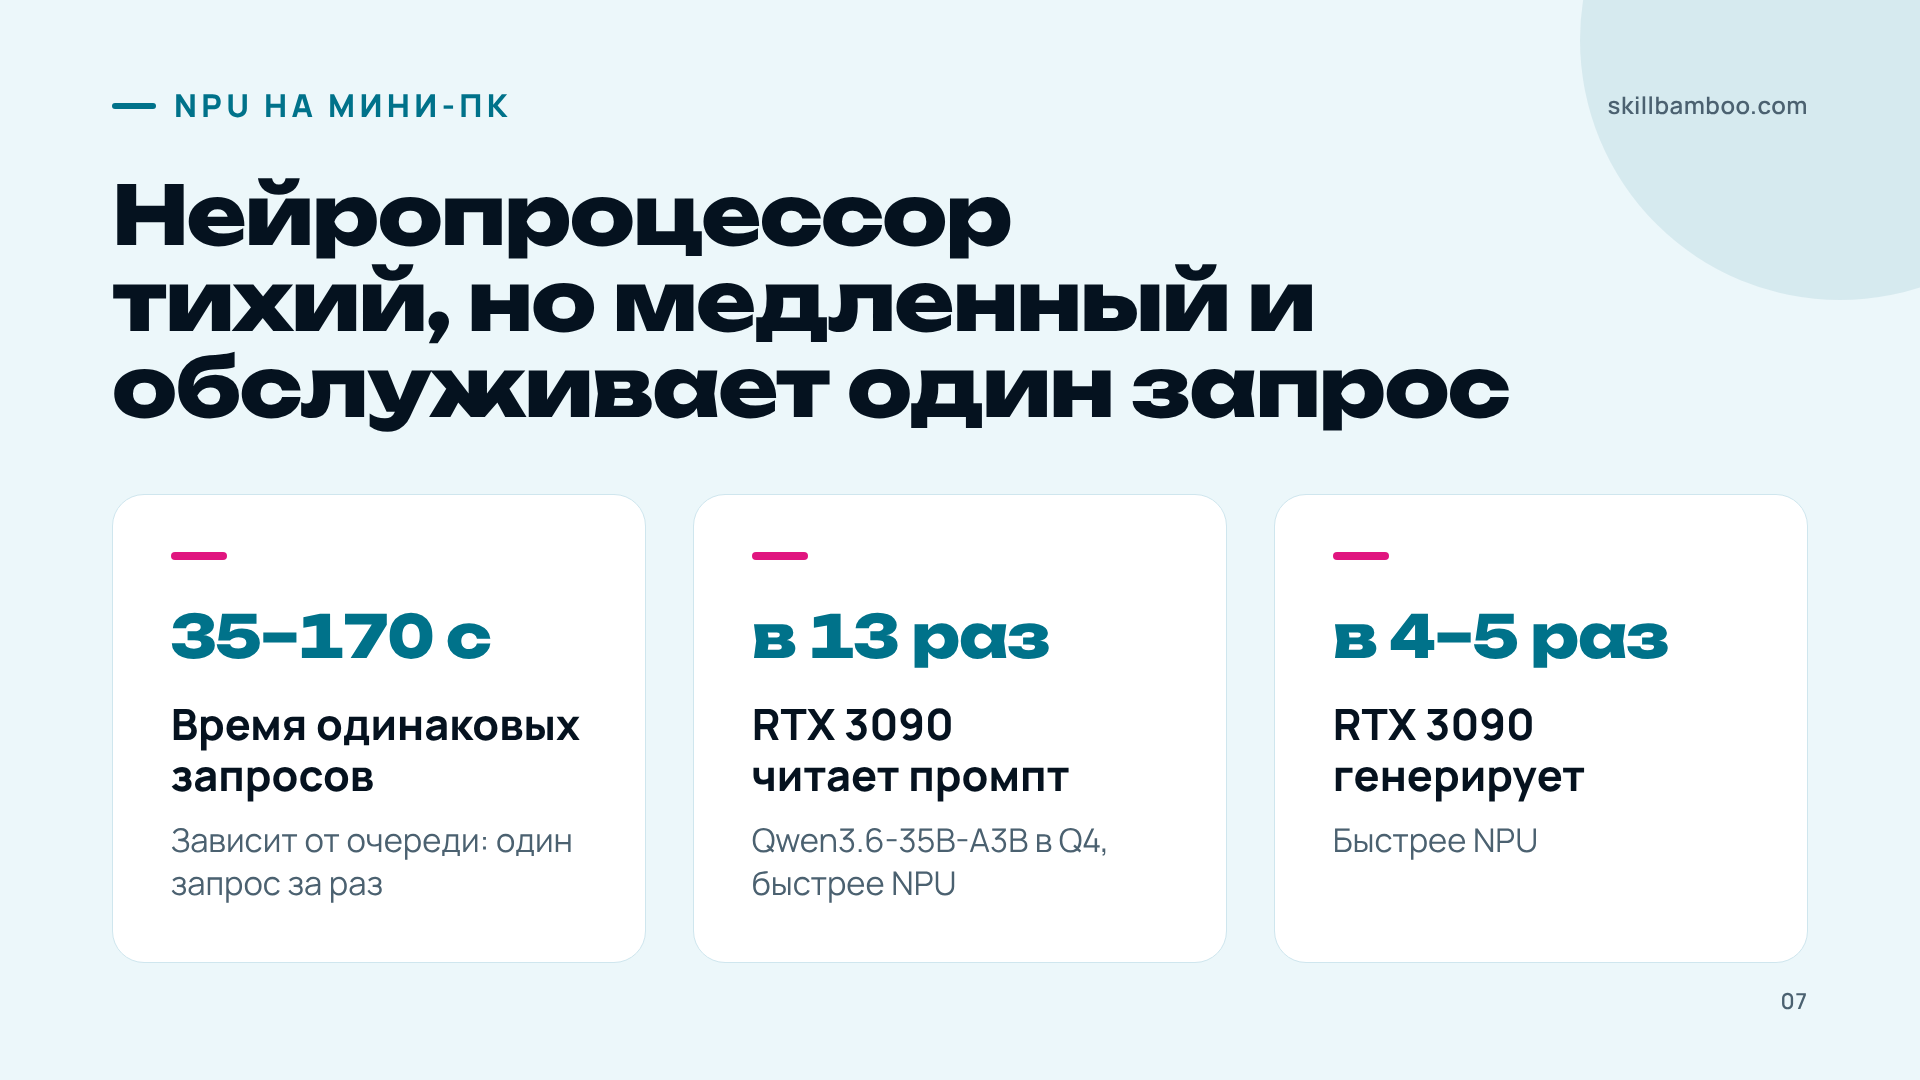
Третье – очередь. NPU обрабатывает строго один запрос за раз. Под нагрузкой одинаковые по размеру запросы выполнялись то за 35, то за 170 секунд – всё зависело от того, сколько задач стояло впереди.
Короткий таймаут клиента может уронить сервер
Если клиент не дождался ответа и отменил запрос, пока тот ждал в очереди, FastFlowLM при отмене во время чтения промпта падает целиком – вместе со всей очередью. Ставьте клиентам таймауты в минутах и настройте автоматический перезапуск сервиса.
И наконец, скорость. На MoE-модели Qwen3.6-35B-A3B нейропроцессор Ryzen AI 9 365 читает промпт со скоростью около 200 токенов/с и генерирует 13–17 токенов/с. Видеокарта RTX 3090 с той же моделью в Q4 читает промпт примерно в 13 раз быстрее, а генерирует в 4–5 раз быстрее. NPU выигрывает тишиной и энергопотреблением, поэтому подходит не для живого чата с несколькими пользователями, а для фоновой очереди задач.
Ключевые термины
- TTFT (Time To First Token) – Время от отправки запроса до появления первого токена ответа.
- GGUF – Формат файлов моделей, с которым работает llama.cpp и который использует Ollama.
- MoE (Mixture of Experts) – Архитектура модели, в которой для каждого токена работает только часть параметров-«экспертов», что экономит вычисления.
- Обвязка (harness) – Все компоненты вокруг модели – интерфейс, API, данные, лимиты, проверки, права и логи, – которые превращают её в сервис.
- NPU – Нейропроцессор, встроенный в процессор, для ускорения нейросетевых вычислений; популярные движки LLM его пока не используют.
- Prefill и decode – Две фазы ответа модели: чтение промпта (prefill) и генерация новых токенов (decode).
Итог
На одиночных запросах Ollama и llama.cpp почти не различаются: за удобство Ollama вы платите лишь несколькими процентами скорости. Под параллельной нагрузкой llama.cpp постепенно выходит вперёд при той же видеопамяти. Кратного ускорения не даёт ни один движок. Так что тезис «Ollama всё замедляет» для одного пользователя – скорее миф, а для сервиса с параллельными запросами – замечание по делу, но без драмы: на четырёх одновременных запросах llama.cpp выдаёт 39,6 токена/с против 36,8 у Ollama.
Итог
Главное: движок выбирают по нагрузке, железо – по параллелизму и памяти, а будет ли модель работать как сервис, решает обвязка: единый вход с лимитом, проверка действий, права и разумные таймауты. Соберите её до того, как к модели придут первые клиенты.
Проверьте себя
1. Сервис – внутренний чат-помощник для одного-двух сотрудников, запросы редкие, развернуть нужно быстро. Что разумнее?
- А. Только llama.cpp: Ollama всегда заметно медленнее
- Б. Ollama: на одиночных запросах разница с llama.cpp минимальна, а запуск проще
- В. NPU мини-ПК: он быстрее видеокарты на длинных промптах
Показать ответ
Ответ: Б. При последовательной нагрузке проигрыш Ollama – единицы процентов, а экономия времени на настройке заметная.
2. Вы включили 4 параллельных запроса вместо одного. Что, скорее всего, произойдёт?
- А. Каждый запрос будет отвечать в 4 раза быстрее
- Б. Ничего не изменится
- В. Общая пропускная способность вырастет немного, а время ответа на отдельный запрос сильно увеличится
Показать ответ
Ответ: В. Замеры показали: throughput растёт на единицы токенов в секунду, а задержка одного запроса – в несколько раз.
3. Агент формирует заявку в CRM в виде JSON. Какая схема правильная?
- А. Достаточно попросить модель в промпте отвечать только корректно
- Б. Модель предлагает заявку, код проверяет поля и права пользователя, затем система создаёт заявку
- В. Модель сама вызывает API CRM – она уже обучена формировать корректный JSON
Показать ответ
Ответ: Б. Модель не детерминирована, поэтому действие проверяет программный слой до выполнения.
4. Запросы к локальной модели иногда обрываются, и сервер падает вместе со всей очередью. Что стоит сделать в первую очередь? (Верных ответов несколько.)
- А. Поставить перед моделью прокси с общим лимитом параллельных запросов
- Б. Увеличить таймауты клиентов до минут
- В. Уменьшить очередь до одного слота
Показать ответ
Ответ: А, Б. А – Прокси не даёт нескольким сервисам переполнить очередь движка. Б – Падение вызывает отмена запроса клиентом, который не дождался ответа в очереди.
5. Почему в документы, которые RAG добавляет в контекст, нельзя слепо доверять?
- А. В них может быть спрятана инструкция для модели – промпт-инъекция
- Б. Модель не умеет читать документы длиннее 1000 токенов
- В. RAG всегда находит устаревшие документы
Показать ответ
Ответ: А. Поэтому такие тексты передают модели как данные, а системные инструкции ставят выше.