SkillBamboo
Когда мы посадили всю команду на ИИ-агентов, я рассчитывал, что фичи поедут в прод заметно быстрее, а вместо этого получил гору PR и вопрос, почему качество кода с ИИ проседает, хотя самого кода стало больше. Ревью (главный ревьюер у нас, разумеется, я) разбухало на глазах, а до пользователей всё доезжало так же медленно, как и раньше.
Я полез выяснять, куда девается время, которое агенты вроде бы экономят, и достаточно быстро нашёл его в очереди на ревью и в коде, который потом тяжело менять. Если дочитаете до конца, сможете настроить работу команды с агентами так, чтобы прирост кода наконец превращался в прирост продукта.
ИИ-агенты в разработке: кода больше, продукта нет – что показали данные
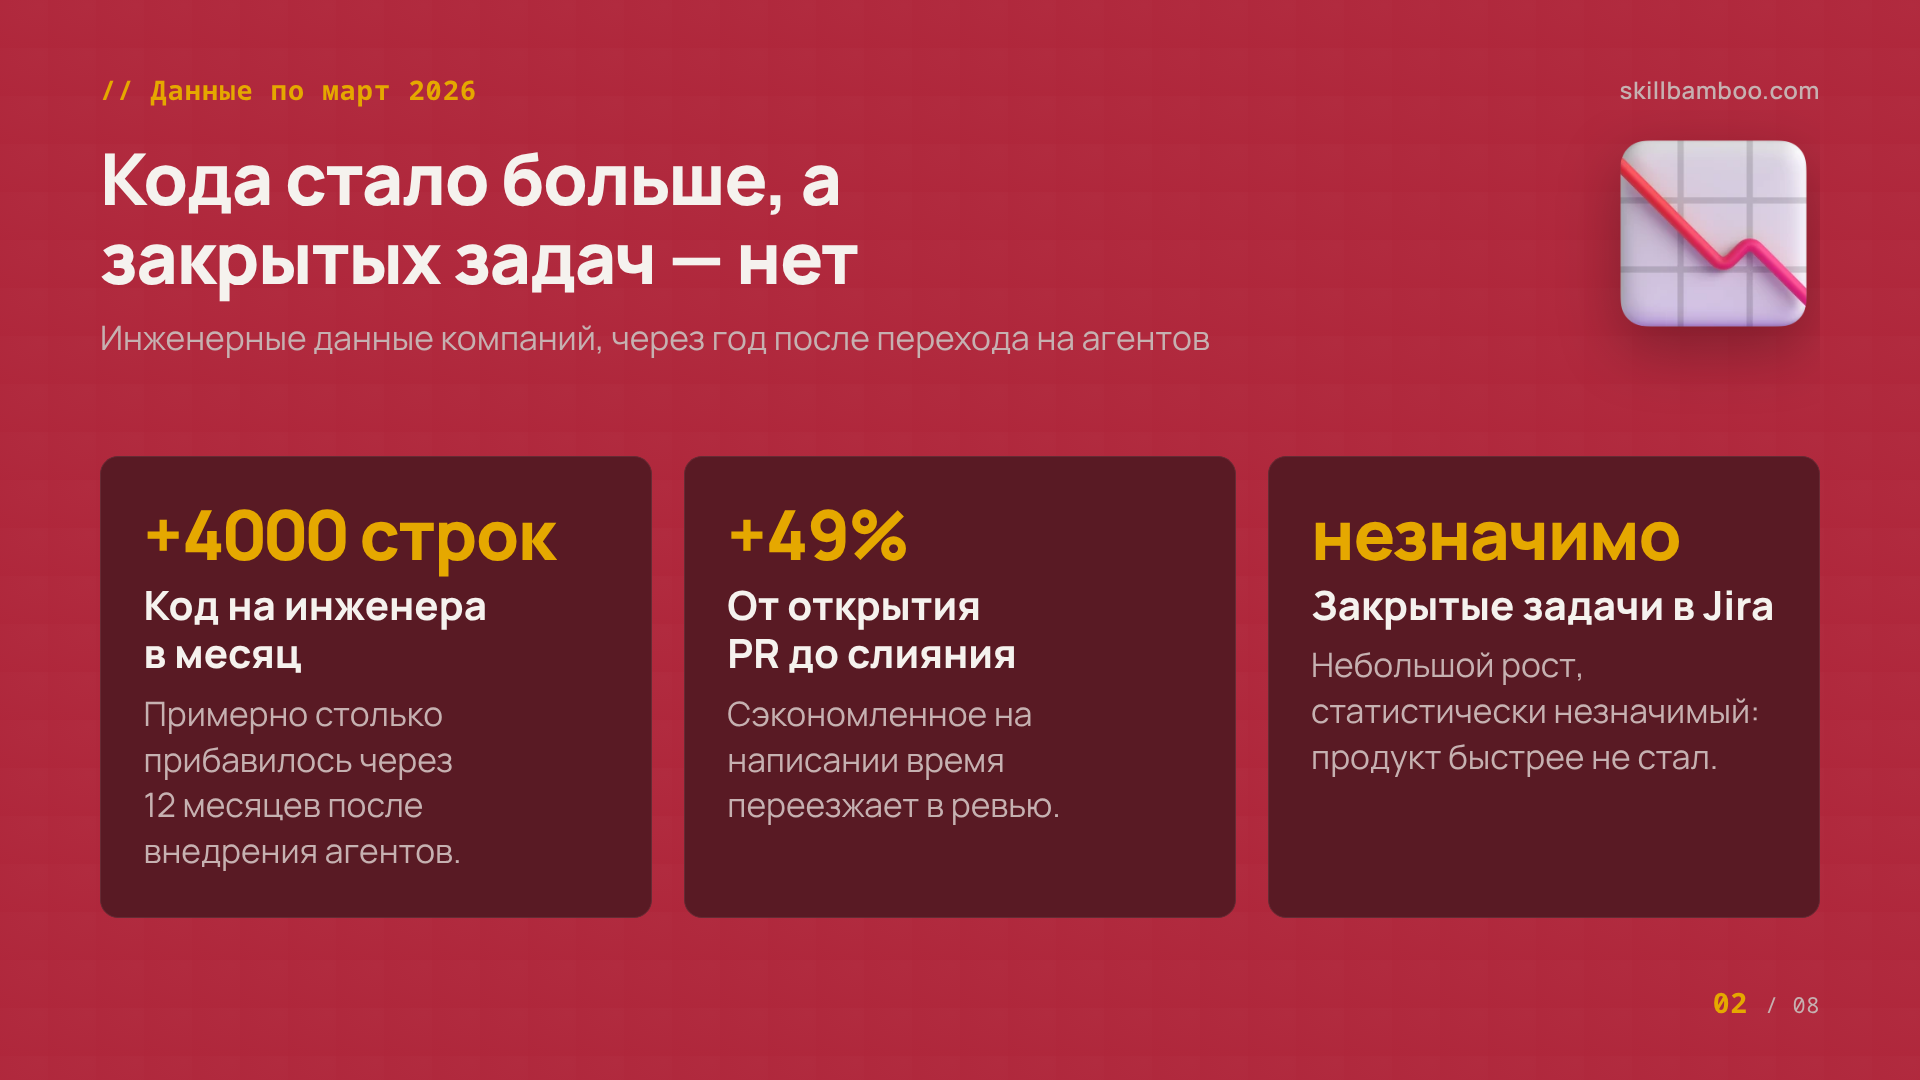
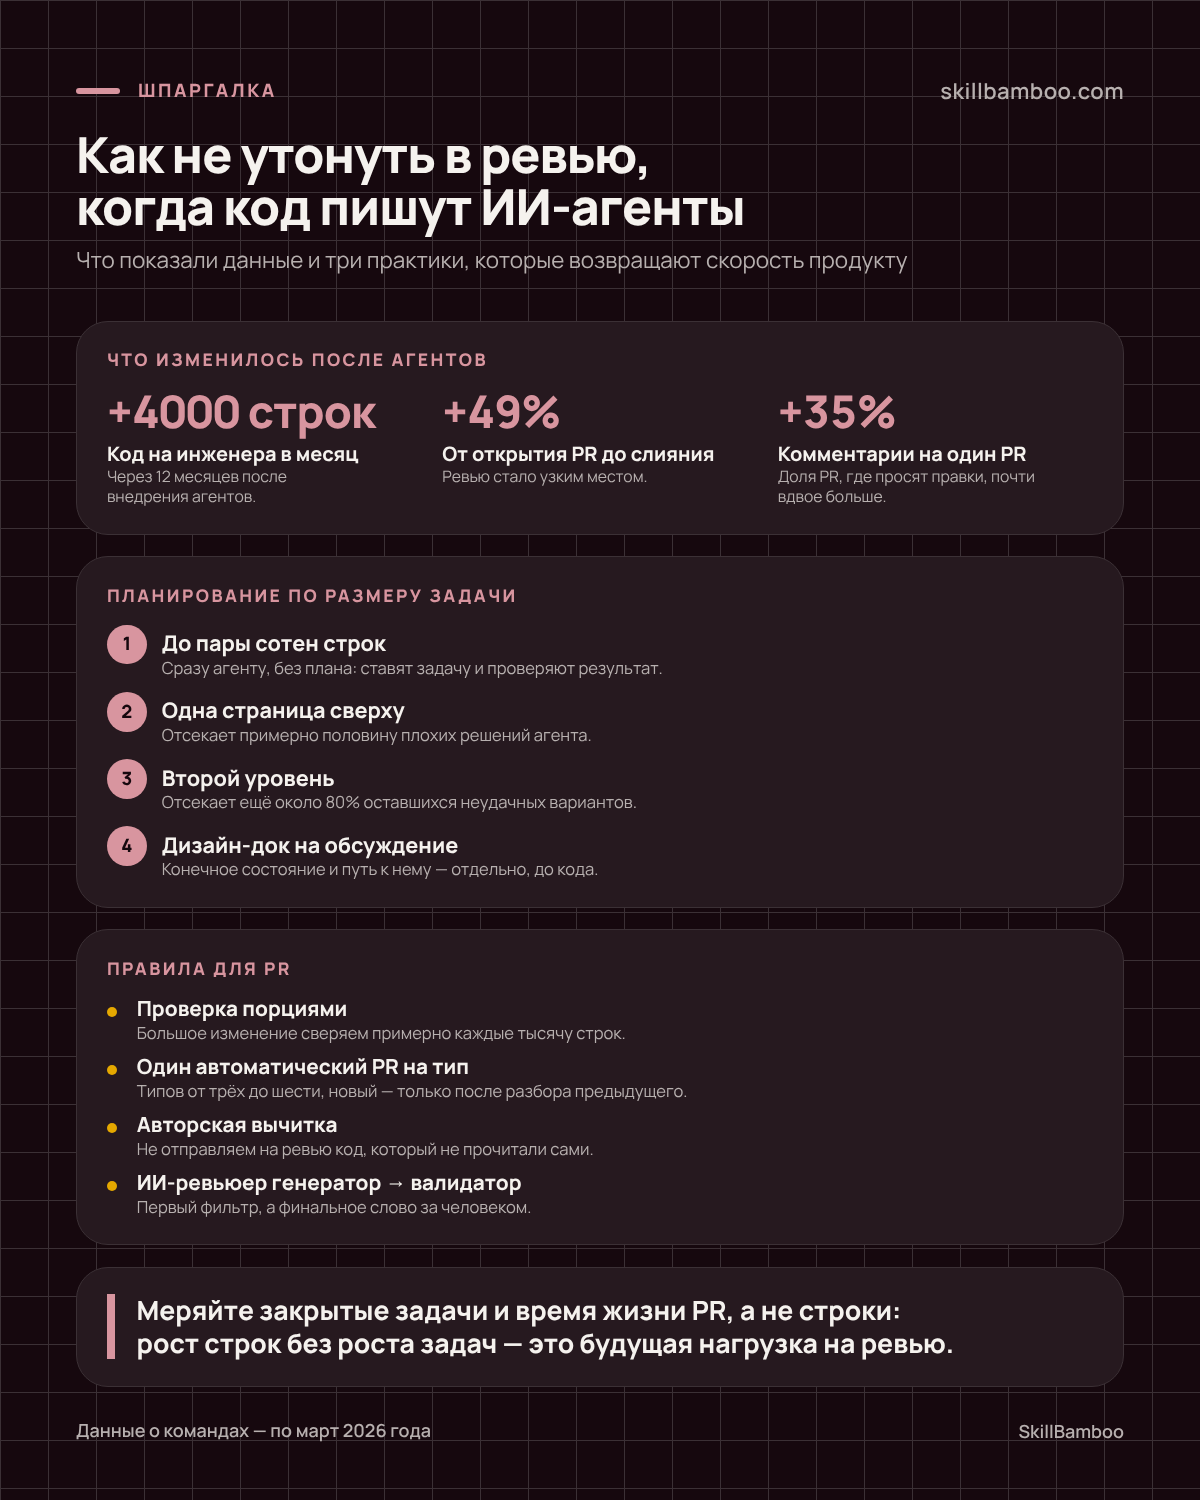
Исследователи Гарварда разобрали инженерные данные компаний из платформы Jellyfish (по март 2026 года). Картина получилась неприятная (особенно для тех, кто считает успех в строках и коммитах).
| Что измеряли | Что изменилось после внедрения агентов |
|---|---|
| Код на инженера | примерно +4000 строк в месяц через 12 месяцев |
| Закрытые задачи в Jira | небольшой рост, статистически незначимый |
| Время от открытия PR до слияния | +49% |
| Доля PR, где просят правки | почти вдвое больше |
| Комментарии на один PR | +35% |
Теперь важная деталь. Ассистенты уровня автодополнения качество кода не ухудшили: там каждый шаг по-прежнему ведёт человек. Падение началось именно с агентами, которые сами пишут большие куски и отдают готовый результат.
Отсюда первый вывод для тимлида: строки и число PR – плохая метрика. Если агенты действительно ускоряют команду, это видно по закрытым задачам и по тому, сколько живёт PR до слияния. Если растут только строки, то вы покупаете не скорость, а будущую нагрузку на ревью.
Куда уходит время: ревью стало узким местом
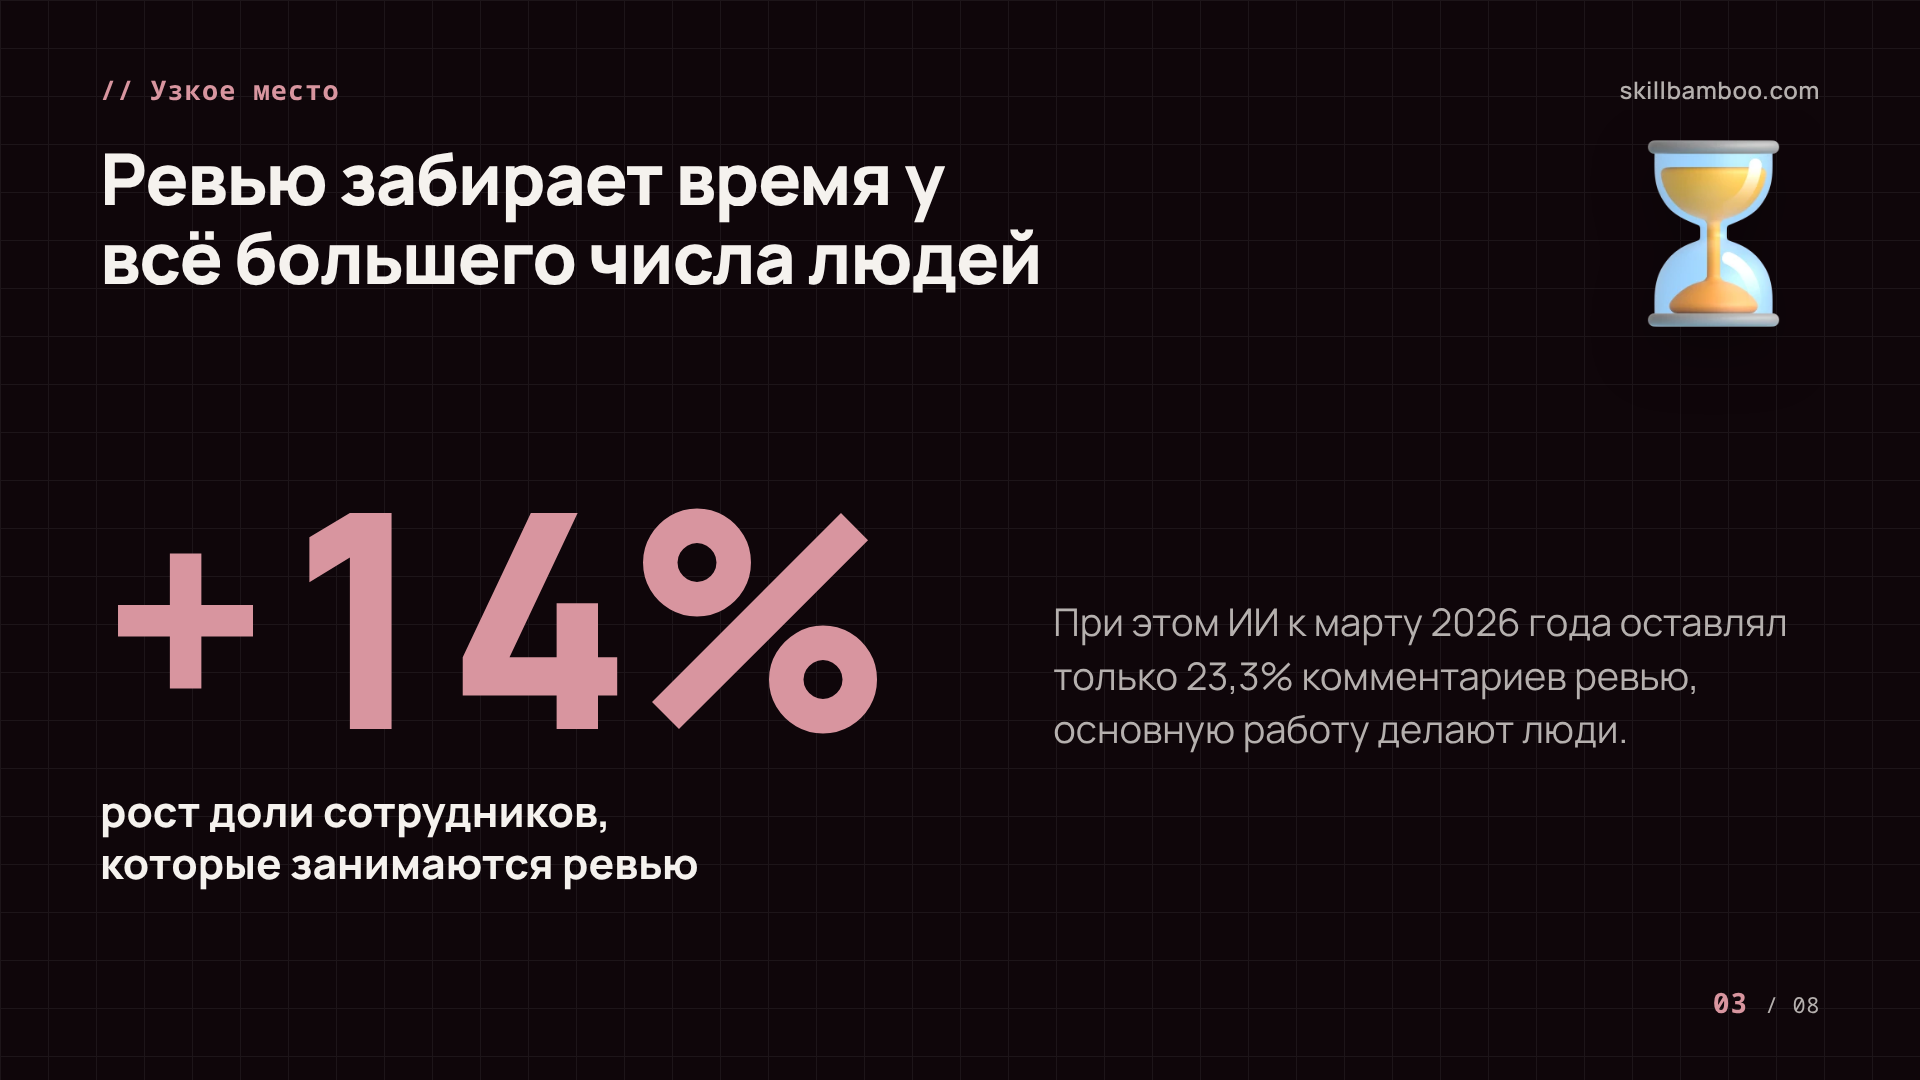
Сэкономленное на написании время никуда не девается, оно просто переезжает к тем, кто читает код. После прихода агентов доля сотрудников, которые занимаются ревью, выросла на 14%. То есть ревью забирает время у всё большего числа людей.
Особенно это заметно в командах, где одобрять изменения может только один эксперт. Один младший инженер рассказывал про проект, где право на одобрение было только у старшего коллеги, знавшего кодовую базу. Тот был настолько перегружен, что доходил до кода младшего раз в неделю. Агент пишет за минуты, а изменение неделю ждёт своей очереди. Прекрасная экономия времени.
Сверху добавляется обманчивое чувство скорости. В исследовании METR, опубликованном летом 2025 года, опытные разработчики с ИИ-помощниками справлялись с задачами примерно на пятую часть медленнее, и при этом считали, что ускорились примерно на столько же. Код появляется мгновенно, а время на чтение и исправление размазано по дню и не замечается.
Меняется и сам код. Аналитики GitClear видят в репозиториях больше почти дословно скопированных фрагментов и меньше переработки старого кода: дописать сверху проще, чем привести в порядок то, что есть.
ИИ-ревью пока нагрузку не снимает. К марту 2026 года его использовали почти 80% компаний в выборке, но ИИ оставлял только 23,3% комментариев ревью. В итоге основную работу по-прежнему делают люди.
Почему ИИ-агент портит качество кода со временем
Большинство бенчмарков дают модели задачу целиком. В реальной разработке так не бывает: требования приходят по частям. SlopCodeBench имитирует ровно это: модель сначала строит проект с нуля, а потом раз за разом добавляет новые фичи в тот же код, не зная заранее, что попросят дальше.
Результат плохой у всех: лучший агент прошёл лишь 14,8% чекпойнтов, ни один не решил задачу целиком, а качество кода ухудшается в трёх четвертях прогонов. То есть отдельную задачу модели решают хорошо, а вот код, который живёт и растёт, в порядке удерживают плохо.
Отсюда и ограничение автоматических проверок. Скриншоты и видео от агента подтверждают, что фича работает, но ничего не говорят о том, легко ли будет этот код менять через полгода. Корректность можно проверить тестами. А сопровождаемость пока только глазами человека, который понимает систему.
Не откладывайте чистку до новой модели
Соблазн понятный: мириться с неаккуратным кодом в расчёте, что через год выйдет модель, которая всё разгребёт. Но ставить кодовую базу в залог такой надежды опасно: прогресс в сопровождаемости пока медленный, а долг копится с каждой фичей.
Практика 1: планировать до кода, сужая решения уровнями
Самая дорогая ошибка – отдать агенту большую задачу одним промптом и потом разбираться с результатом. В команде HumanLayer пришли к схеме, где объём планирования зависит от размера изменения. Механика простая:
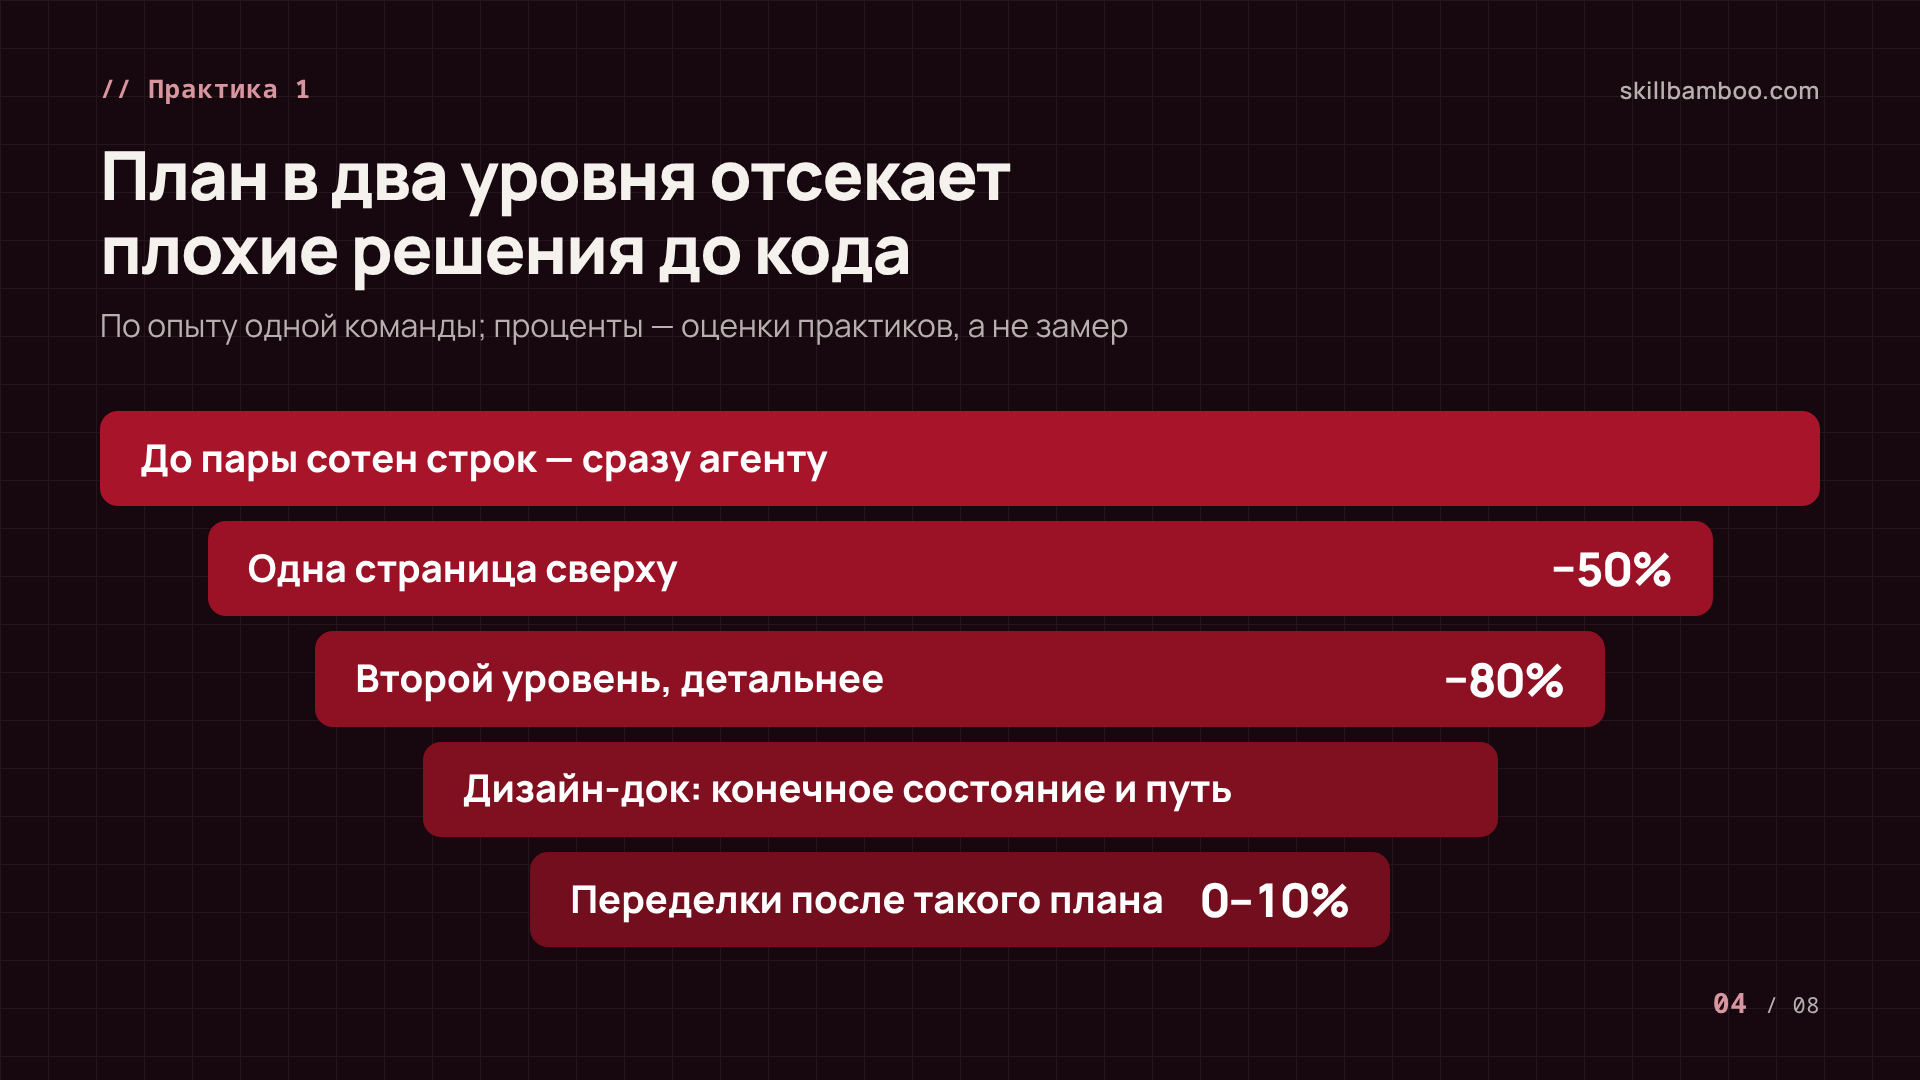
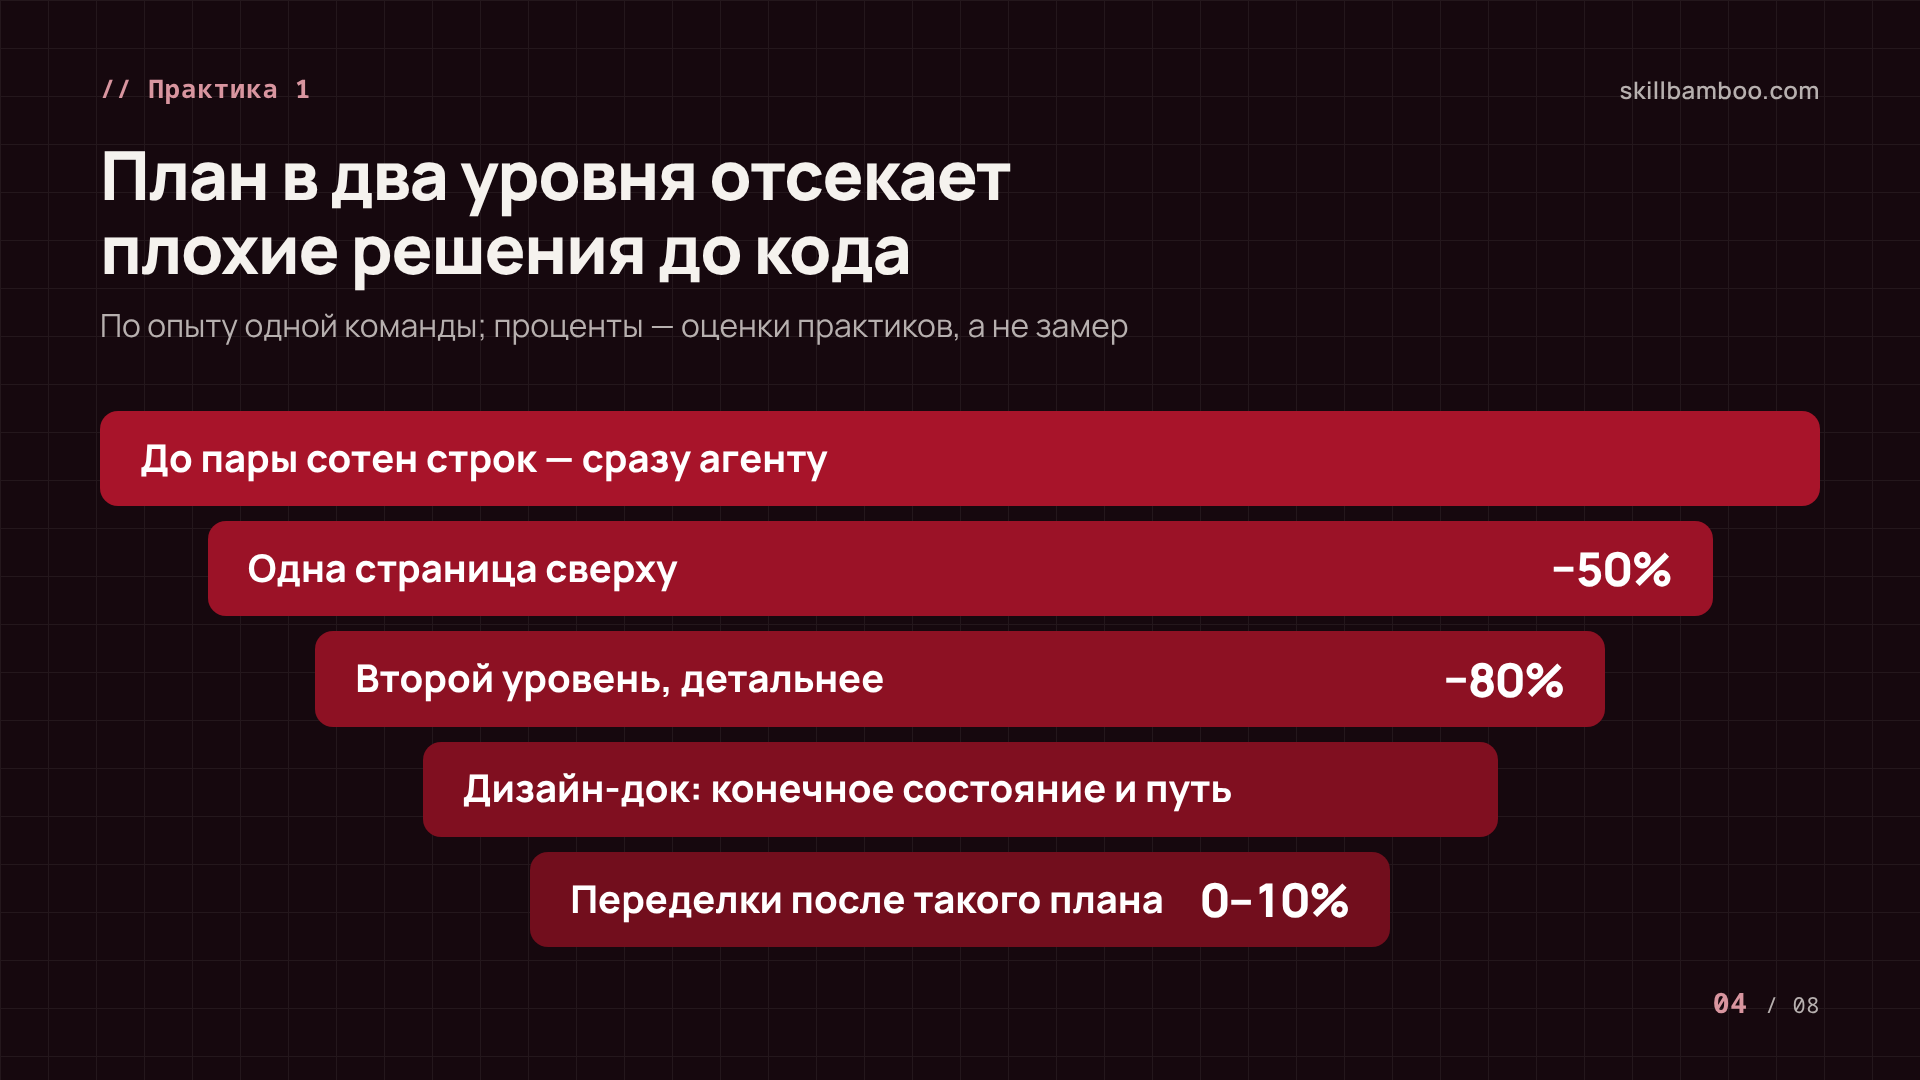
- Мелкое – сразу агенту. Если изменение укладывается в пару сотен строк, план не пишут: ставят задачу и проверяют результат.
- Первый уровень – одна страница. Для крупной задачи сначала описывают её сверху, на одном листе. Цель в том, чтобы отсечь примерно половину плохих решений, которые агент мог бы выбрать.
- Второй уровень – детальнее. Дальше опускаются на уровень ниже и отсекают ещё около 80% оставшихся неудачных вариантов.
- Дизайн-док вместо «плана». В документе разводят два вопроса: каким должно быть конечное состояние и каким путём к нему прийти. Это разные решения, и спорить о них удобнее по отдельности.
Зачем столько уровней? По опыту команды, после такой подготовки код требует 0–10% переделок. А если большую задачу пытаются закрыть агентом за один проход, переделывать приходится обычно от четверти до трёх четвертей результата. Это оценки практиков, а не замер, но разница в разы.
Совет
Отправляйте коллегам на обсуждение дизайн-док, а не готовый PR. Поспорить об архитектуре на одной-двух страницах достаточно быстро, а переписывать тысячи строк, которые агент уже написал, долго и больно.
Практика 2: маленькие порции и меньше задач параллельно
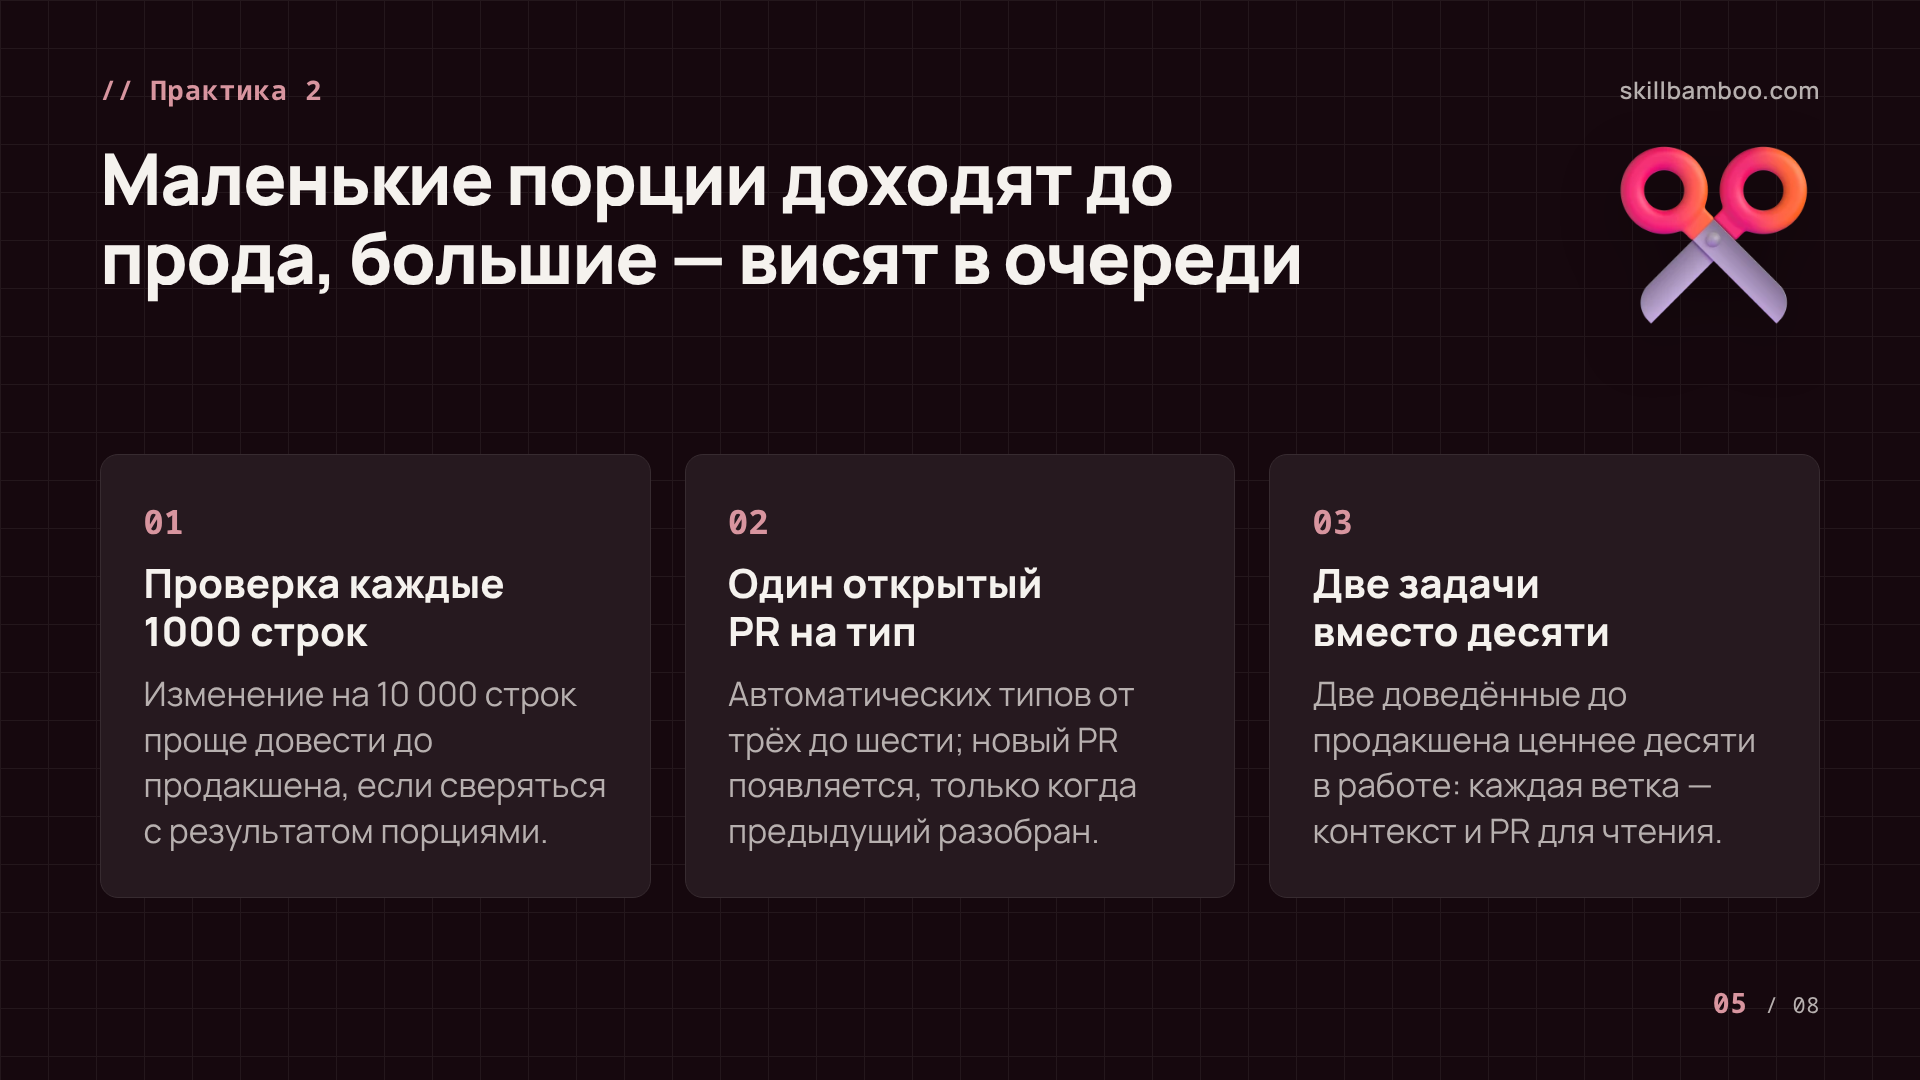
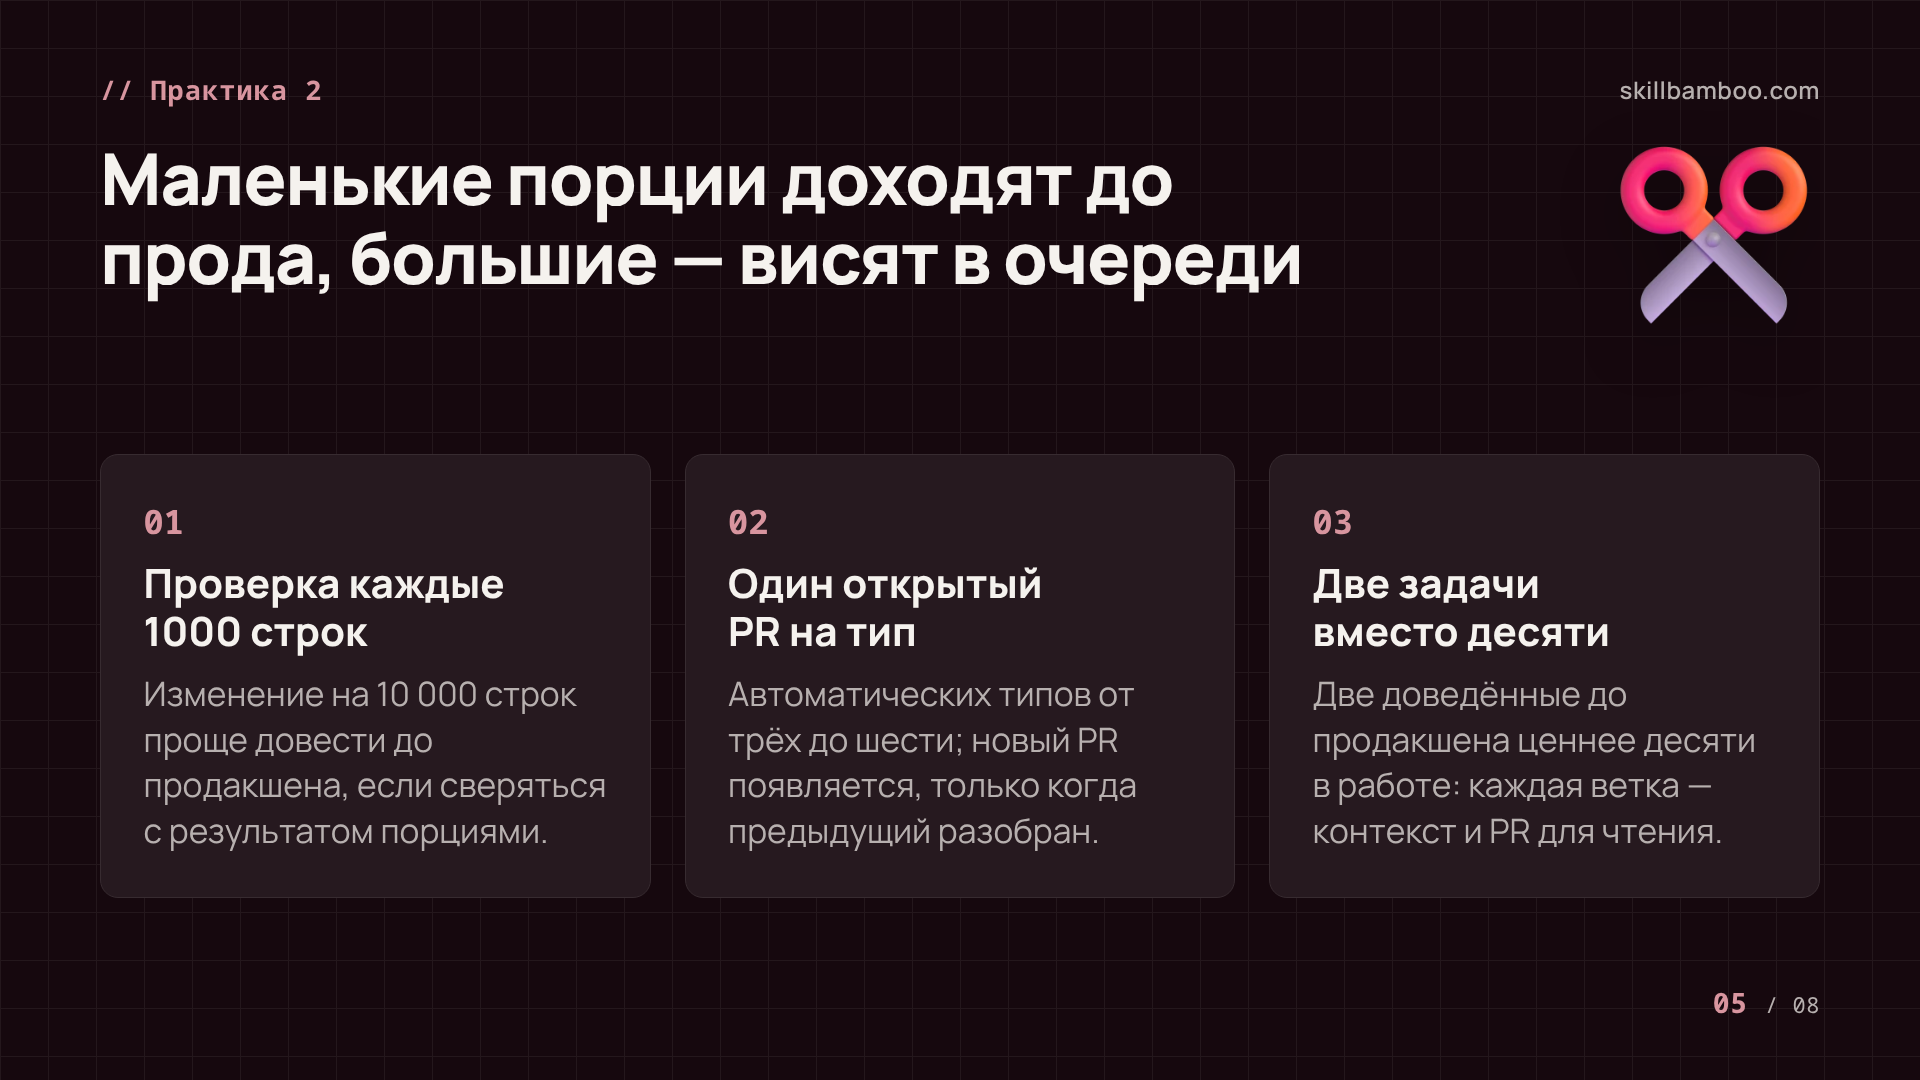
Второй рычаг – размер изменений. Большой объём кода сам по себе не страшен, страшно проверять его одним куском. Изменение на 10 000 строк проще довести до продакшена, если сверяться с результатом каждые тысячу строк: ошибка всплывает рано, и искать её приходится на небольшом участке, а не по всему диффу.
То же правило работает для автоматических задач. В HumanLayer всё, что агенты делают по расписанию (рефакторинг, мелкие миграции, правки по правилам линтера), режут на очень маленькие PR. Слишком большой PR так и не сливают: у ревьюера не находится на него времени. Типов таких автоматических PR у команды от трёх до шести, и для каждого типа одновременно открыт максимум один. Новый появляется, только когда предыдущий разобран. В итоге очередь не разрастается.
Ну и напоследок – параллельность. Агенты подталкивают запустить десять задач сразу и вернуться к ним утром. Практика показывает обратное: две задачи, доведённые до продакшена, ценнее десяти, висящих в работе. Каждая незавершённая ветка – это контекст, который нужно держать в голове, и PR, который кто-то должен прочитать. Держите одну главную задачу и доводите её первой, а остальным занимайтесь, пока она ждёт.
Практика 3: правила код-ревью и ИИ-ревьюер на PR
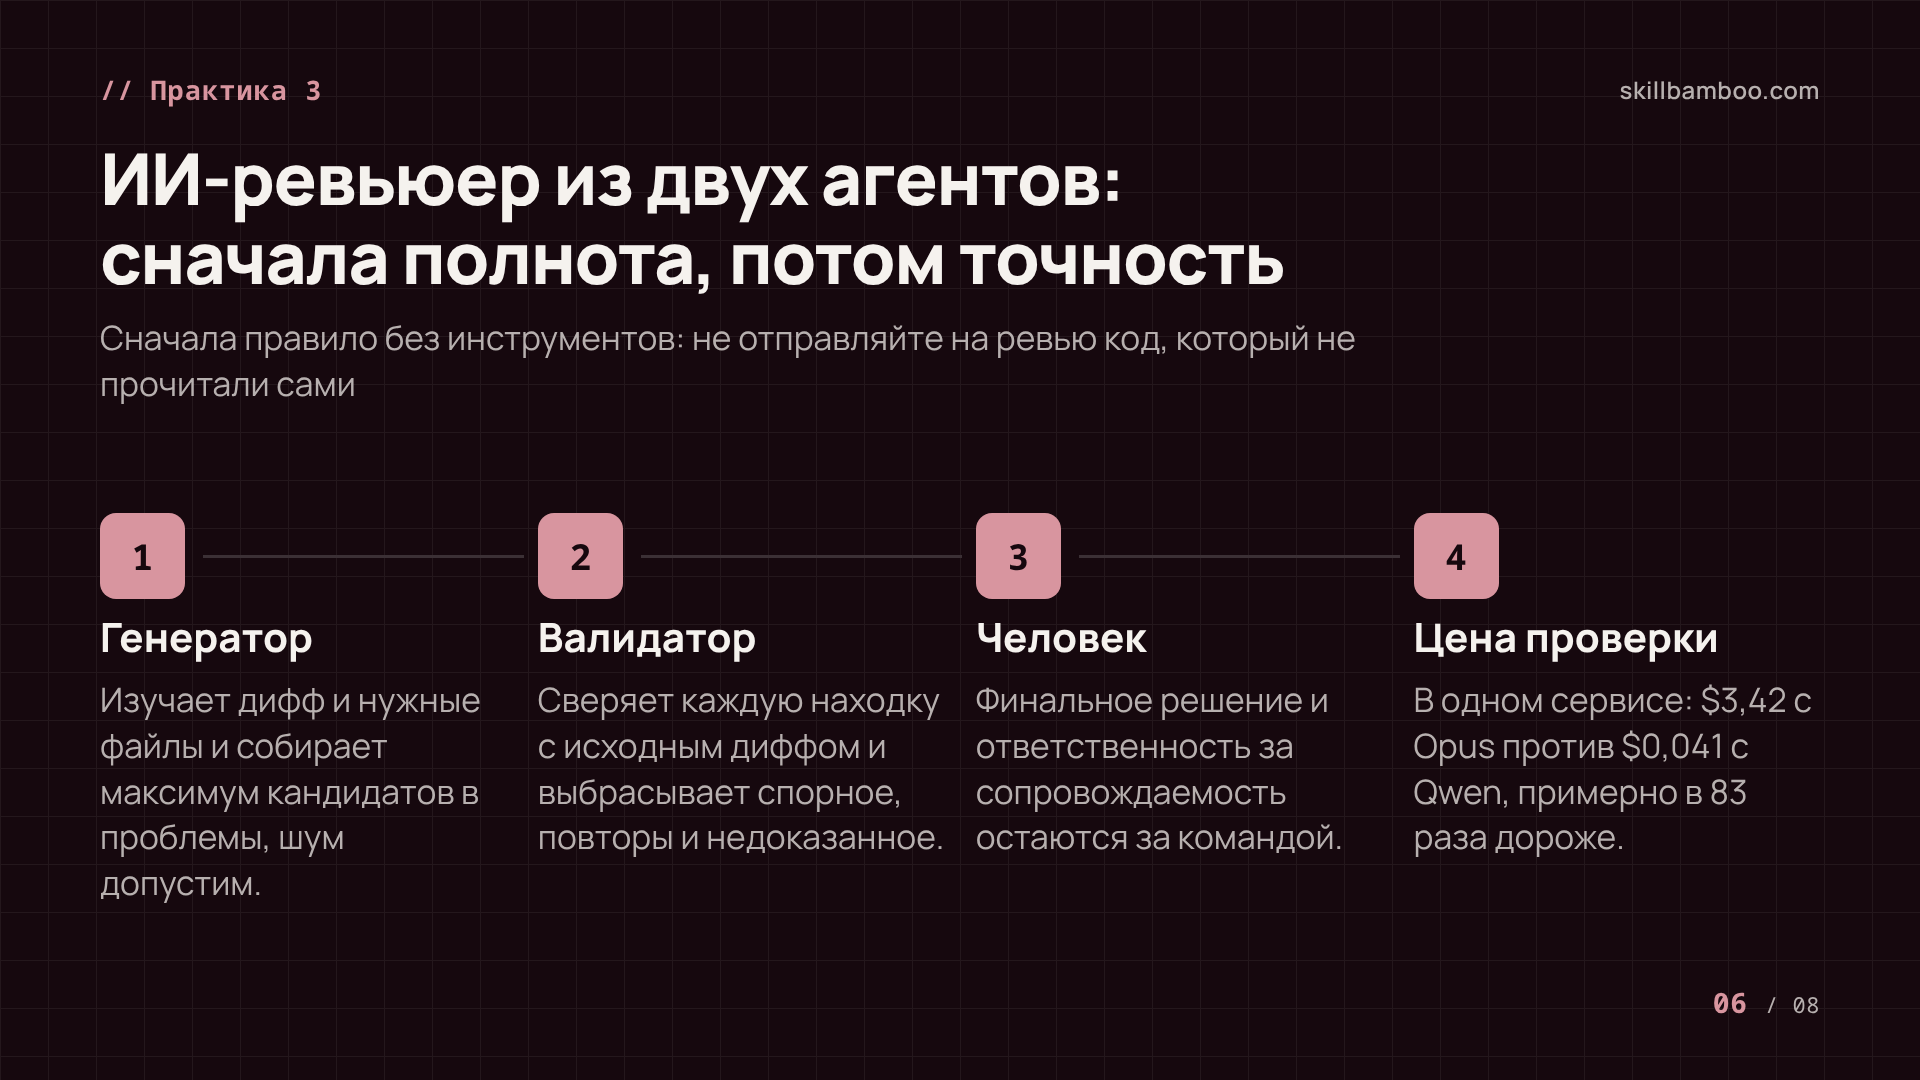
Первое правило не требует никаких инструментов: не отправляйте на ревью код, который не прочитали сами. Коллега не должен первым видеть сырой вывод агента. Автор отвечает за свой PR, и неважно, кто набирал строки.
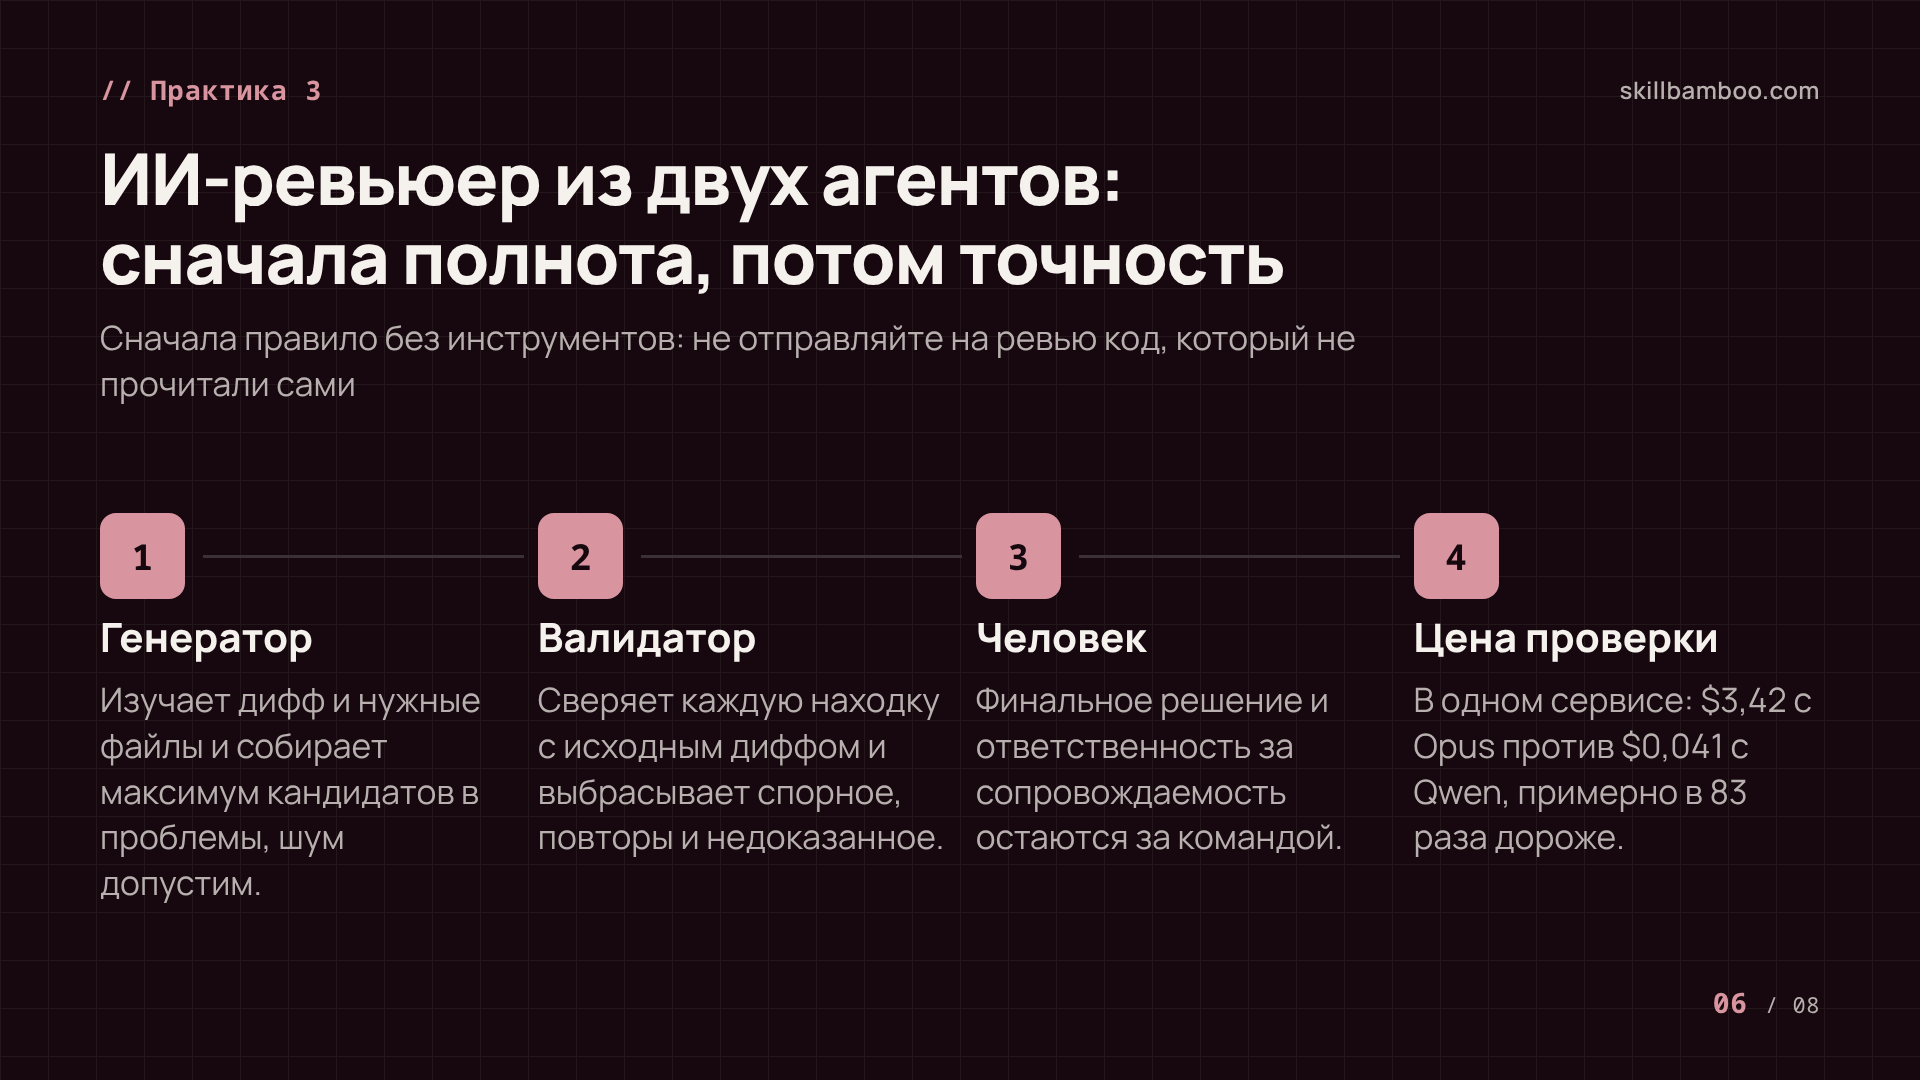
Второе правило: отдать рутину ревью кода ИИ, но устроить такого ревьюера правильно. В одном продакшен-сервисе, который проверяет тысячи PR в день, ревью делают два агента по очереди:
- Генератор изучает дифф и нужные файлы и собирает максимум кандидатов в проблемы. Его задача – полнота, шум допустим.
- Валидатор заново сверяет каждую находку с исходным диффом и отбрасывает спорное, повторы и всё, что не удалось подтвердить. Его задача – точность.
Такая связка даёт полезный сигнал: разработчики принимают почти каждое третье замечание, а доля лайков под комментариями ревьюера за полгода выросла с 50 до 70%.
Есть и ограничения. На очень больших PR, которые затрагивают сотни файлов, полезный контекст размывается, и ИИ-ревьюер справляется хуже (ещё один довод за маленькие порции из прошлого раздела). И отдельно про цену. При сравнении конфигураций самый сильный вариант (с Opus) стоил $3,42 за проверку против $0,041 у выбранного (с Qwen), то есть примерно в 83 раза дороже. На потоке в тысячи PR в день это решающая разница.
Важно
ИИ-ревьюер – первый фильтр, не больше. Человека он не заменяет: даже там, где ИИ-ревью уже внедрено, основную часть замечаний оставляют люди, а финальное решение и ответственность за сопровождаемость остаются за командой.
Ключевые термины
- SlopCodeBench – Бенчмарк, который проверяет, как модель сопровождает собственный код: сначала строит проект с нуля, затем пошагово добавляет в него новые фичи.
- Дизайн-док – Короткий документ перед реализацией, в котором отдельно описаны конечное состояние системы и путь к нему.
- Сопровождаемость кода – Насколько легко людям и агентам читать, менять и расширять код без поломок.
- Двухэтапное ИИ-ревью – Схема, в которой один агент ищет кандидатов в дефекты, а второй перепроверяет их и отбрасывает шум.
- Агентный ИИ – Инструмент, который по высокоуровневой задаче сам планирует работу, правит несколько файлов и запускает тесты, в отличие от автодополнения.
Итог: чек-лист для команды с ИИ-агентами
- Измеряем закрытые задачи и время жизни PR, а не строки и коммиты.
- Изменения до пары сотен строк отдаём агенту сразу, крупные – через план в два уровня.
- Пишем дизайн-док с конечным состоянием и путём к нему и обсуждаем его до кода.
- Большие изменения проверяем порциями примерно по тысяче строк.
- Автоматические PR маленькие, открыт один на тип.
- Доводим до конца одну-две задачи.
- Не отправляем на ревью код, который не прочитали сами.
- ИИ-ревьюер работает в связке генератор → валидатор, но финальное слово (и ответственность за сопровождаемость) остаётся за человеком.
Итог
Код агенты пишут быстрее, но без дисциплины эта скорость оседает в очереди ревью и в долге кодовой базы. Правила выше переносят усилия туда, где они окупаются: в планирование до кода, в маленькие порции и в фильтр перед человеком. Начните с двух пунктов (авторской вычитки и порога «пара сотен строк») и через месяц сравните время жизни PR и число закрытых задач.
Проверьте себя
1. Команда внедрила ИИ-агентов, и число строк кода и pull request заметно выросло. Какой показатель лучше всего скажет, ускорился ли выпуск продукта?
- А. Расход токенов на команду
- Б. Число закрытых задач и эпиков в трекере
- В. Число строк кода на инженера
- Г. Число открытых pull request
Показать ответ
Ответ: Б. Задачи и эпики отражают доставленную функциональность; строки и PR растут и без роста продукта.
2. Агент прислал видео и скриншоты, где новая фича работает. Что это подтверждает?
- А. Что фича работает как задумано
- Б. Что ревью кода можно пропустить
- В. Что код легко сопровождать
Показать ответ
Ответ: А. Демонстрация проверяет корректность поведения.
3. Нужно внести правку примерно на 150 строк и параллельно – большую фичу в нескольких сервисах. Как разумно поступить?
- А. Мелкую правку отдать агенту сразу, а для фичи сделать план в несколько уровней и дизайн-док
- Б. Для обеих задач писать подробный дизайн-док
- В. Обе задачи отдать агенту одним промптом без плана
Показать ответ
Ответ: А. Задачи в пару сотен строк можно делать без плана, а большую задачу план сужает и сокращает переделки.
4. Вы настраиваете ночных агентов, которые сами чистят и рефакторят код. Какие правила помогут, чтобы их PR действительно сливали? (Верных ответов несколько.)
- А. Держать не больше одного открытого PR на каждый тип задачи
- Б. Собирать все правки за ночь в один большой PR
- В. Делать PR очень маленькими
Показать ответ
Ответ: А, В. А – Так агенты не плодят дубли и не перегружают ревью. В – Большие автоматические PR так и не сливают – их сложно проверить.
5. Зачем ИИ-ревьюеру два агента – генератор и валидатор?
- А. Чтобы ревью можно было делать только самой дорогой моделью
- Б. Чтобы ИИ-ревьюер заменил ревью архитектуры
- В. Генератор ищет как можно больше проблем, а валидатор отсекает шум и недоказанное
Показать ответ
Ответ: В. Разделение ролей позволяет и не пропускать дефекты, и не заваливать автора лишними замечаниями.