 SkillBamboo
Вы гоняете агента на Claude Code, а счёт растёт быстрее, чем хотелось бы: дорогая модель тратит токены на то, чтобы выбрать скилл, разложить обращения по категориям или решить, нужна ли здесь вообще серьёзная проверка. Тут все заговорили о Jev — нейросети, которая якобы делает такое в разы дешевле. Только поговорить с ней как с обычным чатом не получится. Разберемся, что такое Jev, в каких точках агента он экономит время и токены, где связка проигрывает Claude в одиночку и как проверить, окупится ли она на ваших задачах.
Что такое Jev и почему это не ещё один чат
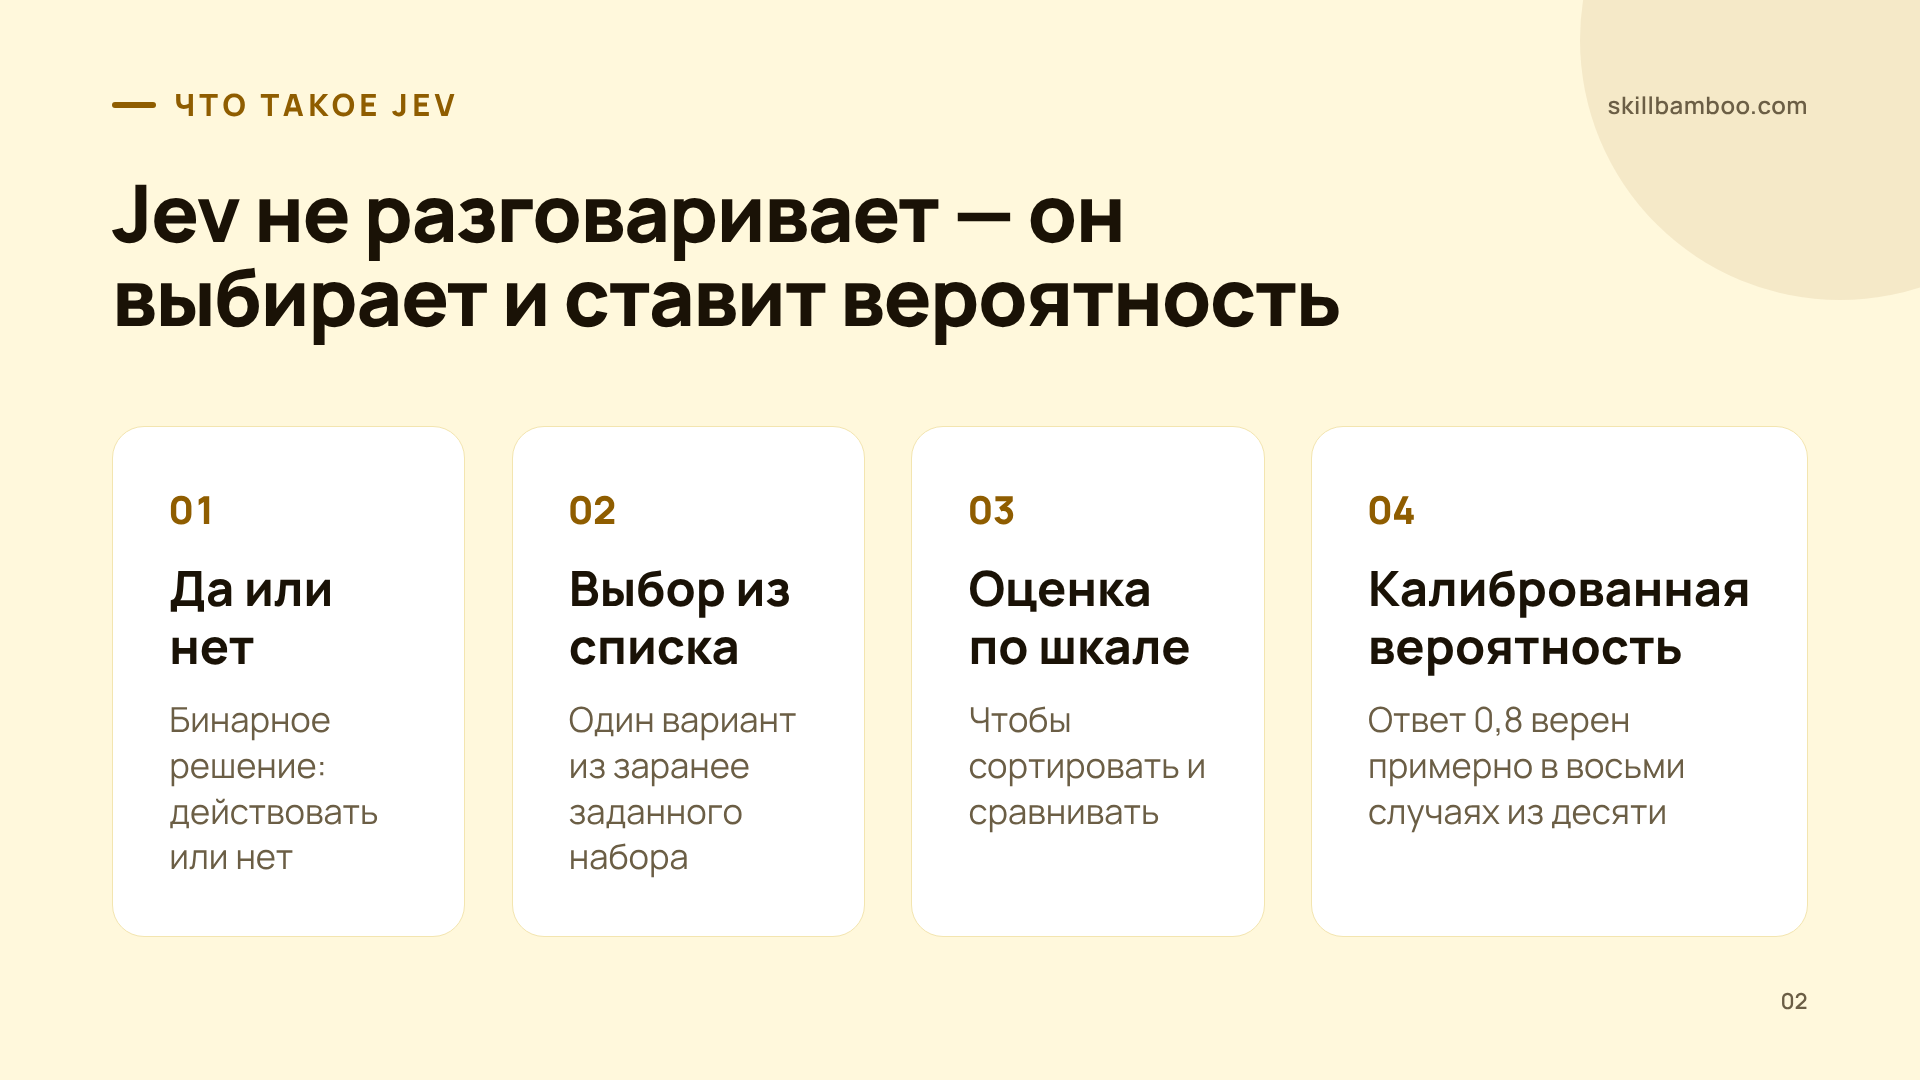
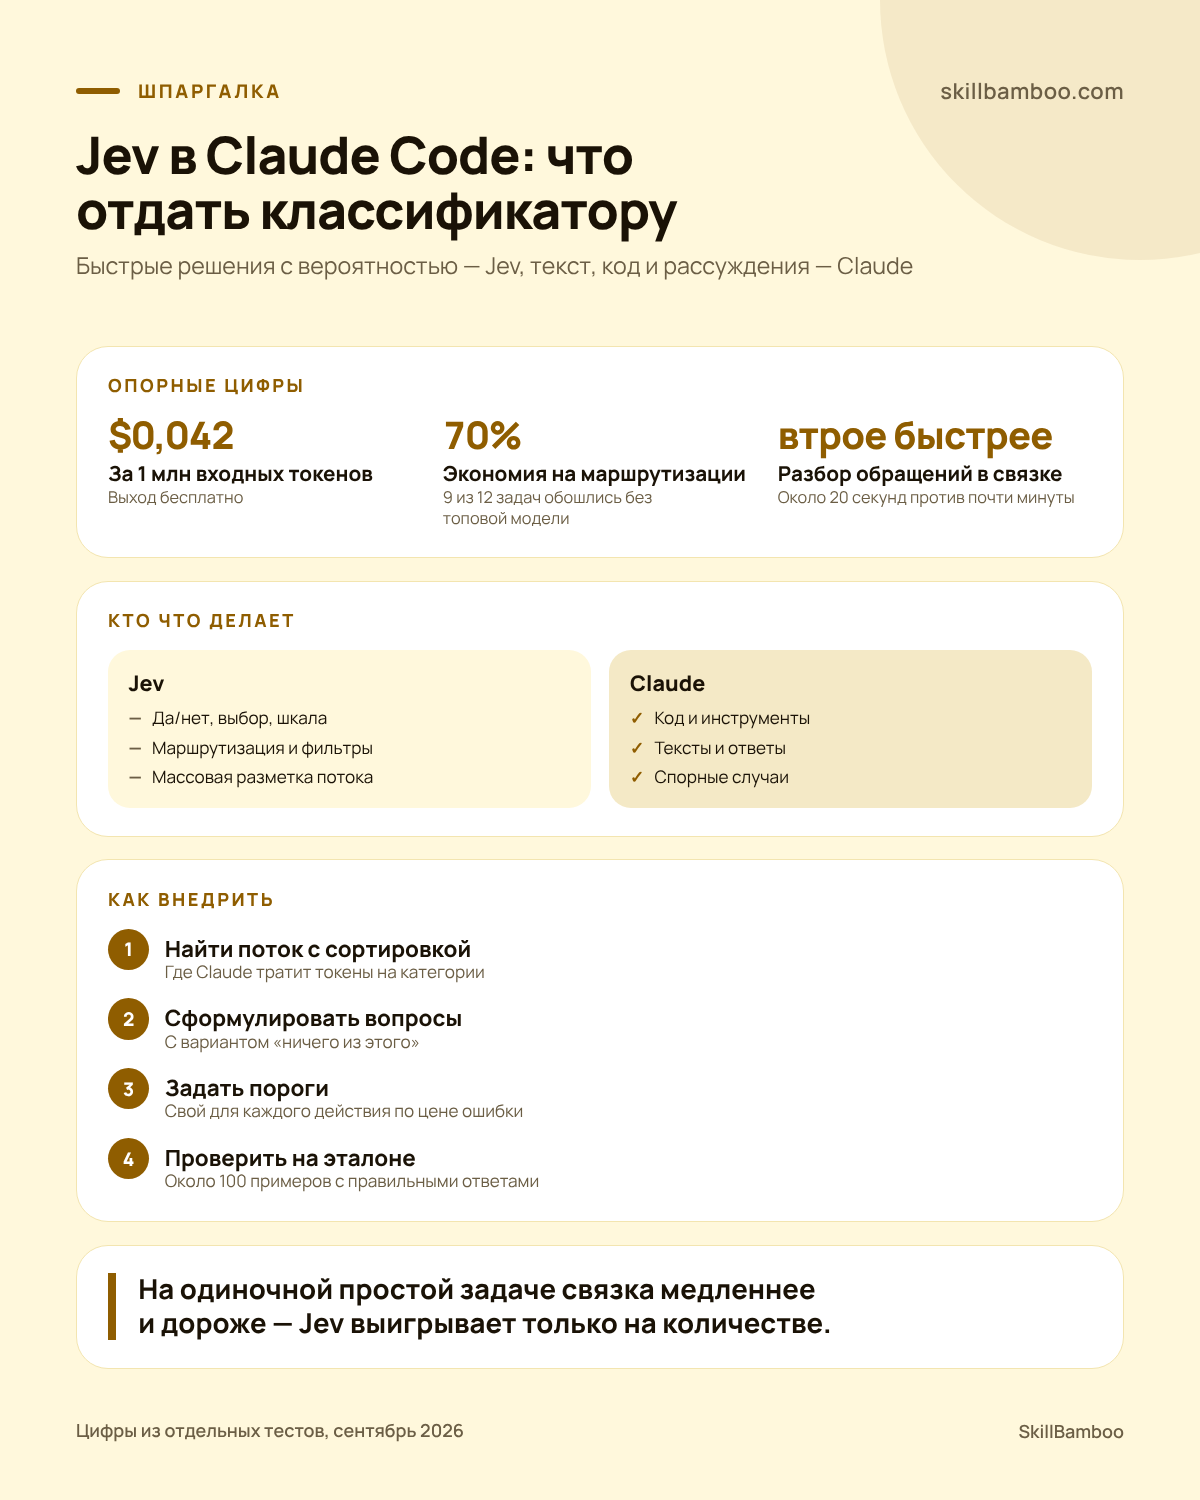
Jev — модель решений, а не языковая модель в привычном смысле. Она не генерирует ответ слово за словом, а отвечает в одной из трёх форм: «да или нет», выбор одного варианта из заданного списка или оценка по шкале. Во многом именно из-за этого ограничения она такая быстрая и дешёвая.
Jev: System One models for Prod, not God — Latent Space — интервью с создателем Jev о типах ответов
Отсюда и границы. Jev не пишет тексты, не делает выжимки, не ищет общие темы и не проводит глубокий анализ. Код он тоже не пишет и с инструментами не работает. Внутри Claude Code его роль одна — принимать решения, которые потом использует основной агент или ваш скрипт.
Зато каждое решение приходит с числом. Вероятности у Jev откалиброваны: если модель выдала 0,8, такой ответ должен быть верным примерно в восьми случаях из десяти. Для автоматики это, по сути, главное свойство. Программа сравнивает число с порогом и сама решает, действовать или передать вопрос дальше.
Основателю компании TypeSafe AI, которая выпустила Jev, Диогу Алмейде, приписывают такое описание ролей: Claude — это разговор, а Jev — «трубопровод» под ним. Картинку полезно держать в голове. Jev не заменяет агента, а работает под ним как быстрый слой решений.
Сколько стоит нейросеть Jev и насколько она быстрее: цифры из тестов
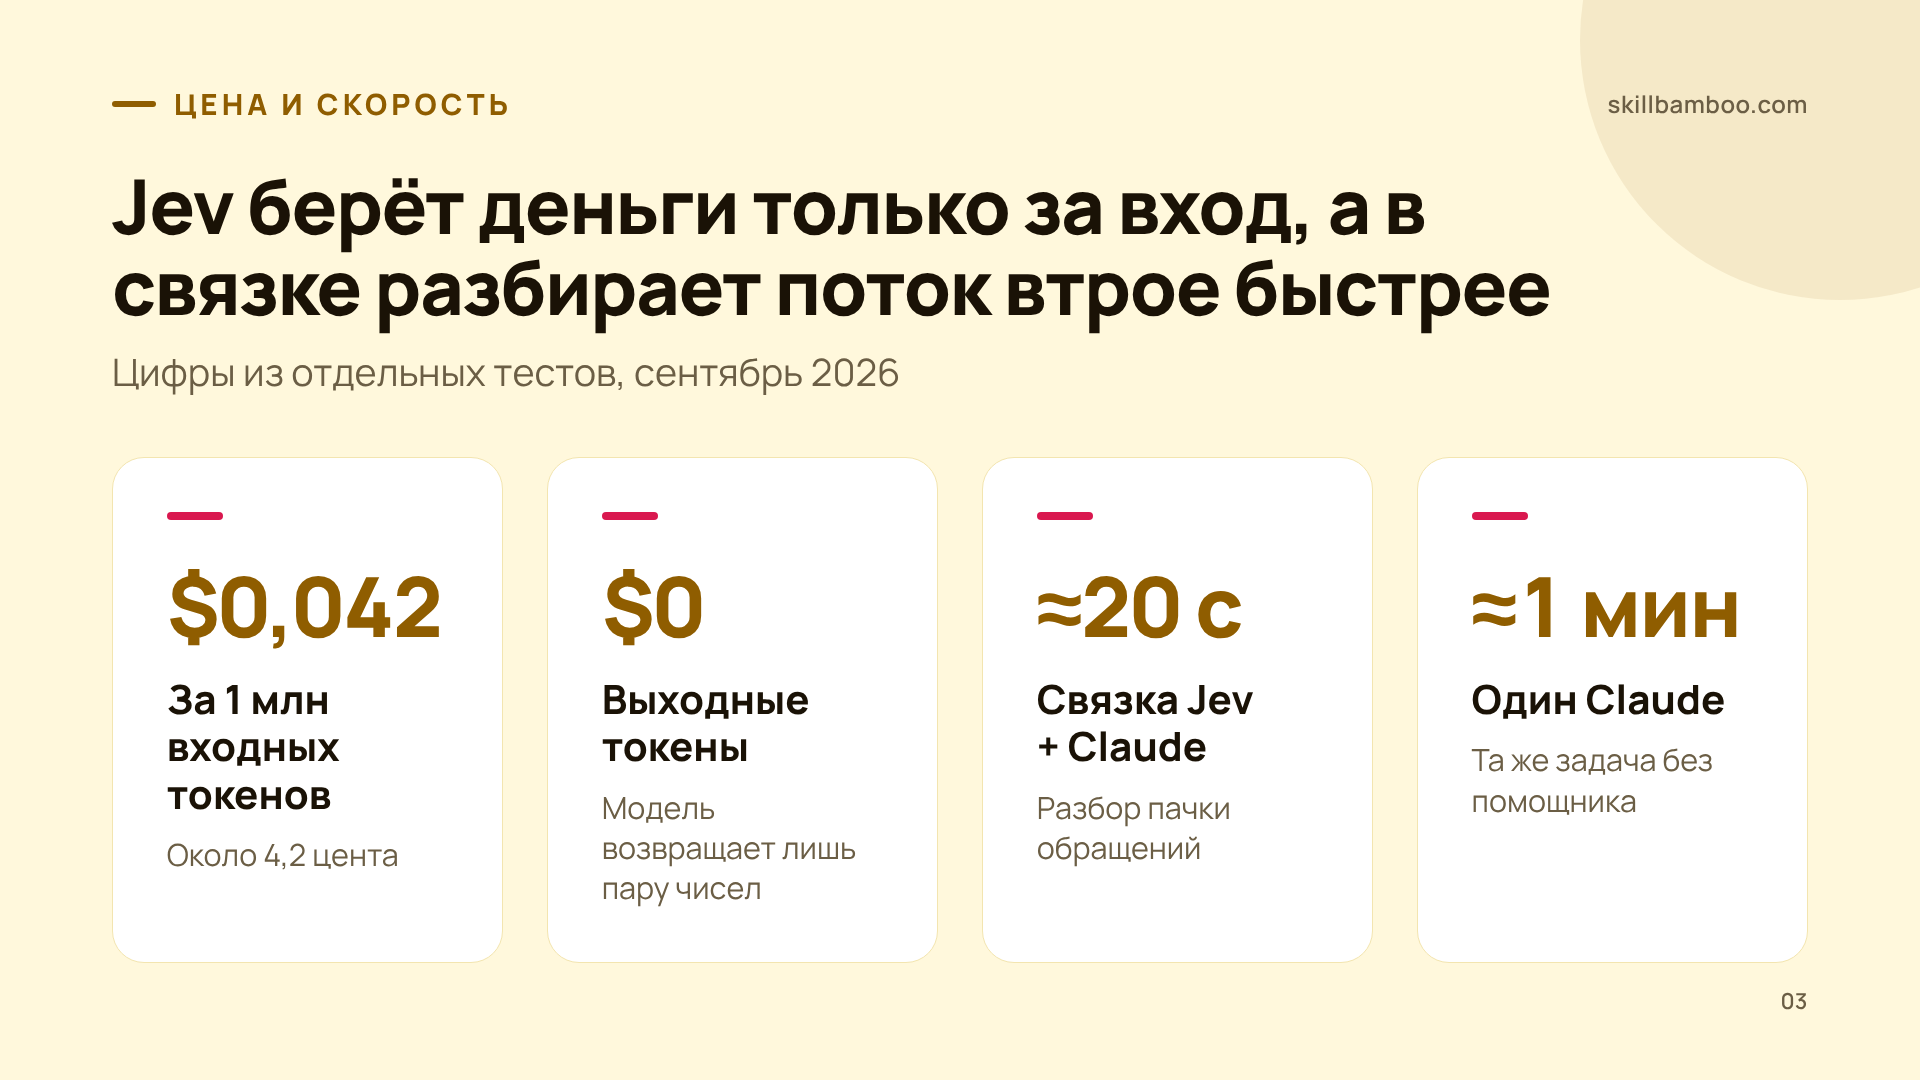
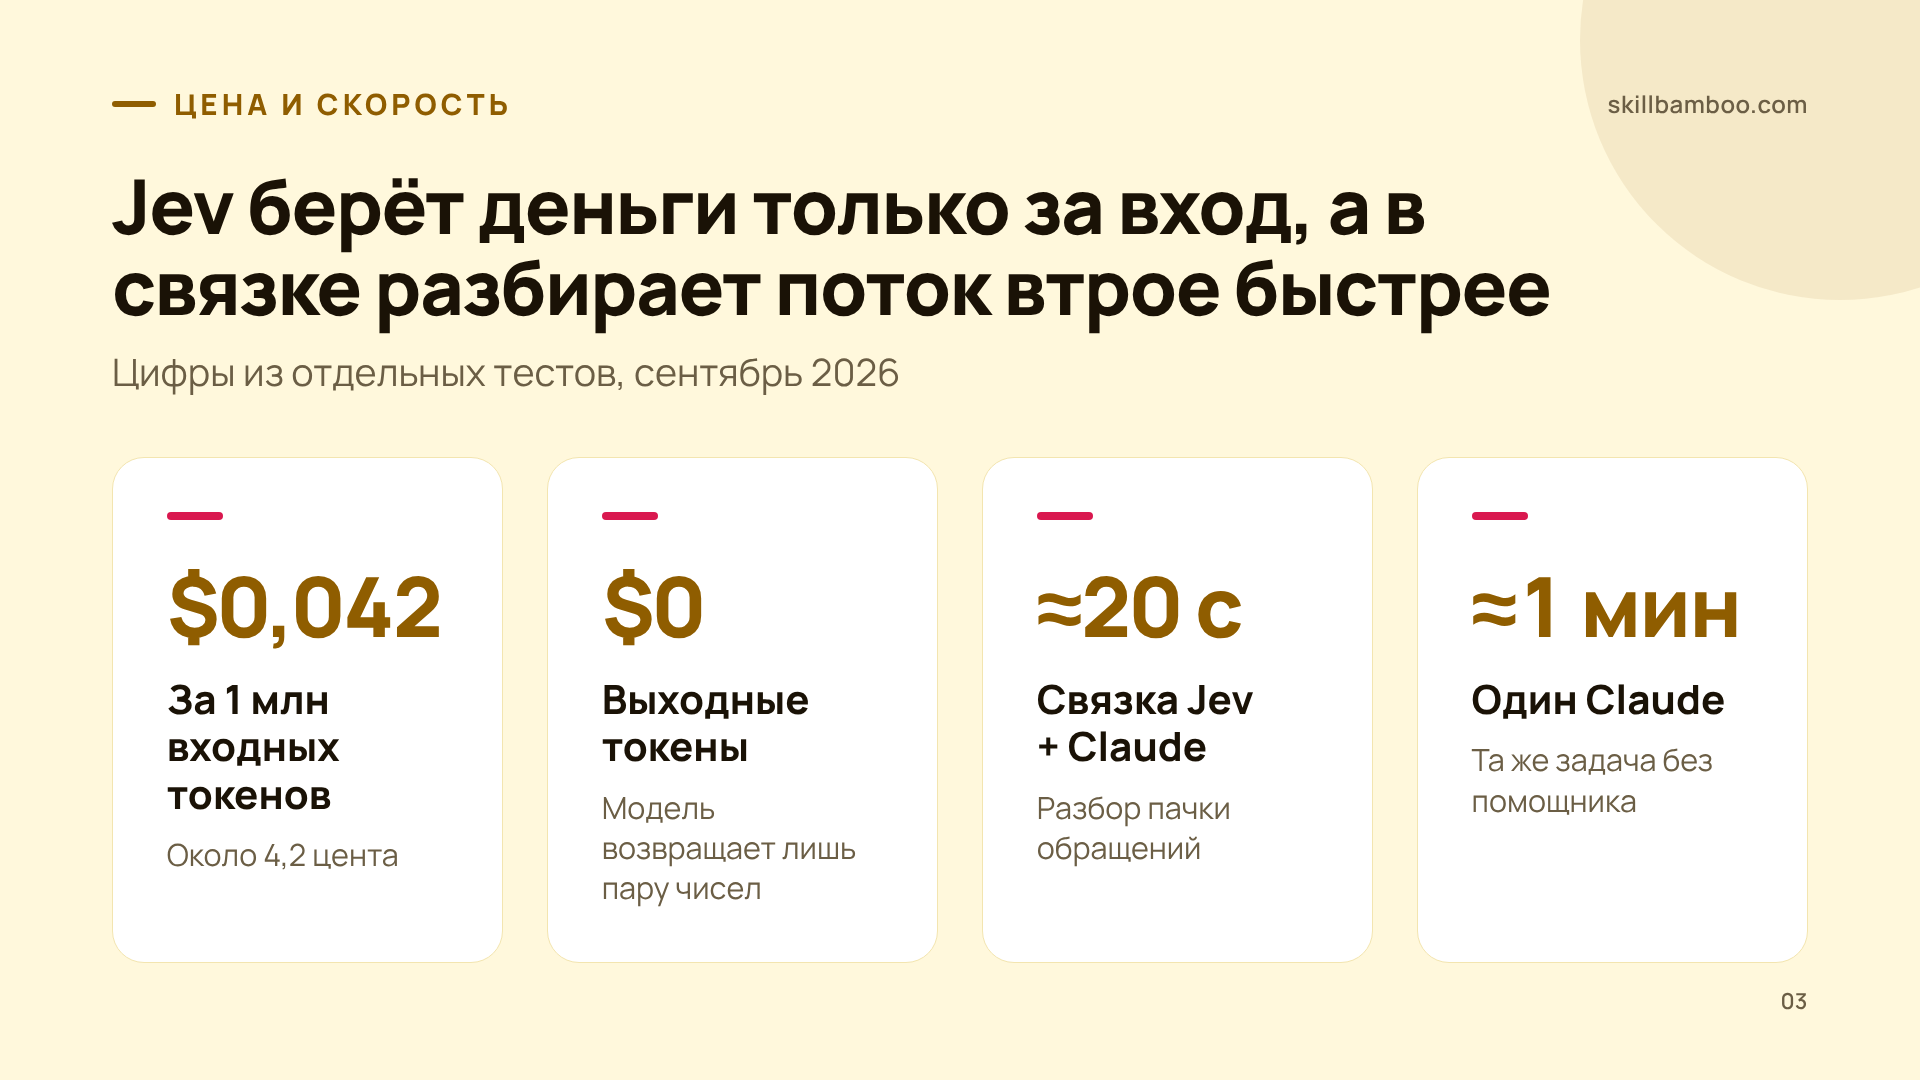
По цене разница принципиальная. На сентябрь 2026 года миллион входных токенов Jev стоит около 4,2 цента ($0,042), а за выходные токены не платят вовсе — модель возвращает лишь пару чисел.
| Jev | Claude | |
|---|---|---|
| Форма ответа | да/нет, выбор, шкала с вероятностью | свободный текст, код, действия |
| Что умеет | классифицировать и оценивать | писать, рассуждать, работать с инструментами |
| Цена (сентябрь 2026) | около 4,2 цента ($0,042) за 1 млн входных токенов, выход бесплатно | платите и за вход, и за выход |
| Разбор пачки обращений | связка Jev + Claude — около 20 секунд | один Claude — почти минута |
Последняя строка — из практического теста в сентябре 2026 года: на разборе пользовательских обращений связка справилась втрое быстрее, чем Claude без помощника. Но важно: это именно связка. Jev раскидал обращения, Claude сделал то, что требует текста.
Цифры — это демонстрации
Все замеры скорости и экономии получены в отдельных тестах на конкретных данных. Порядок величин по ним оценить можно, а вот рассчитывать на те же цифры в своих задачах — нет.
Карта задач внутри Claude Code: что отдать Jev
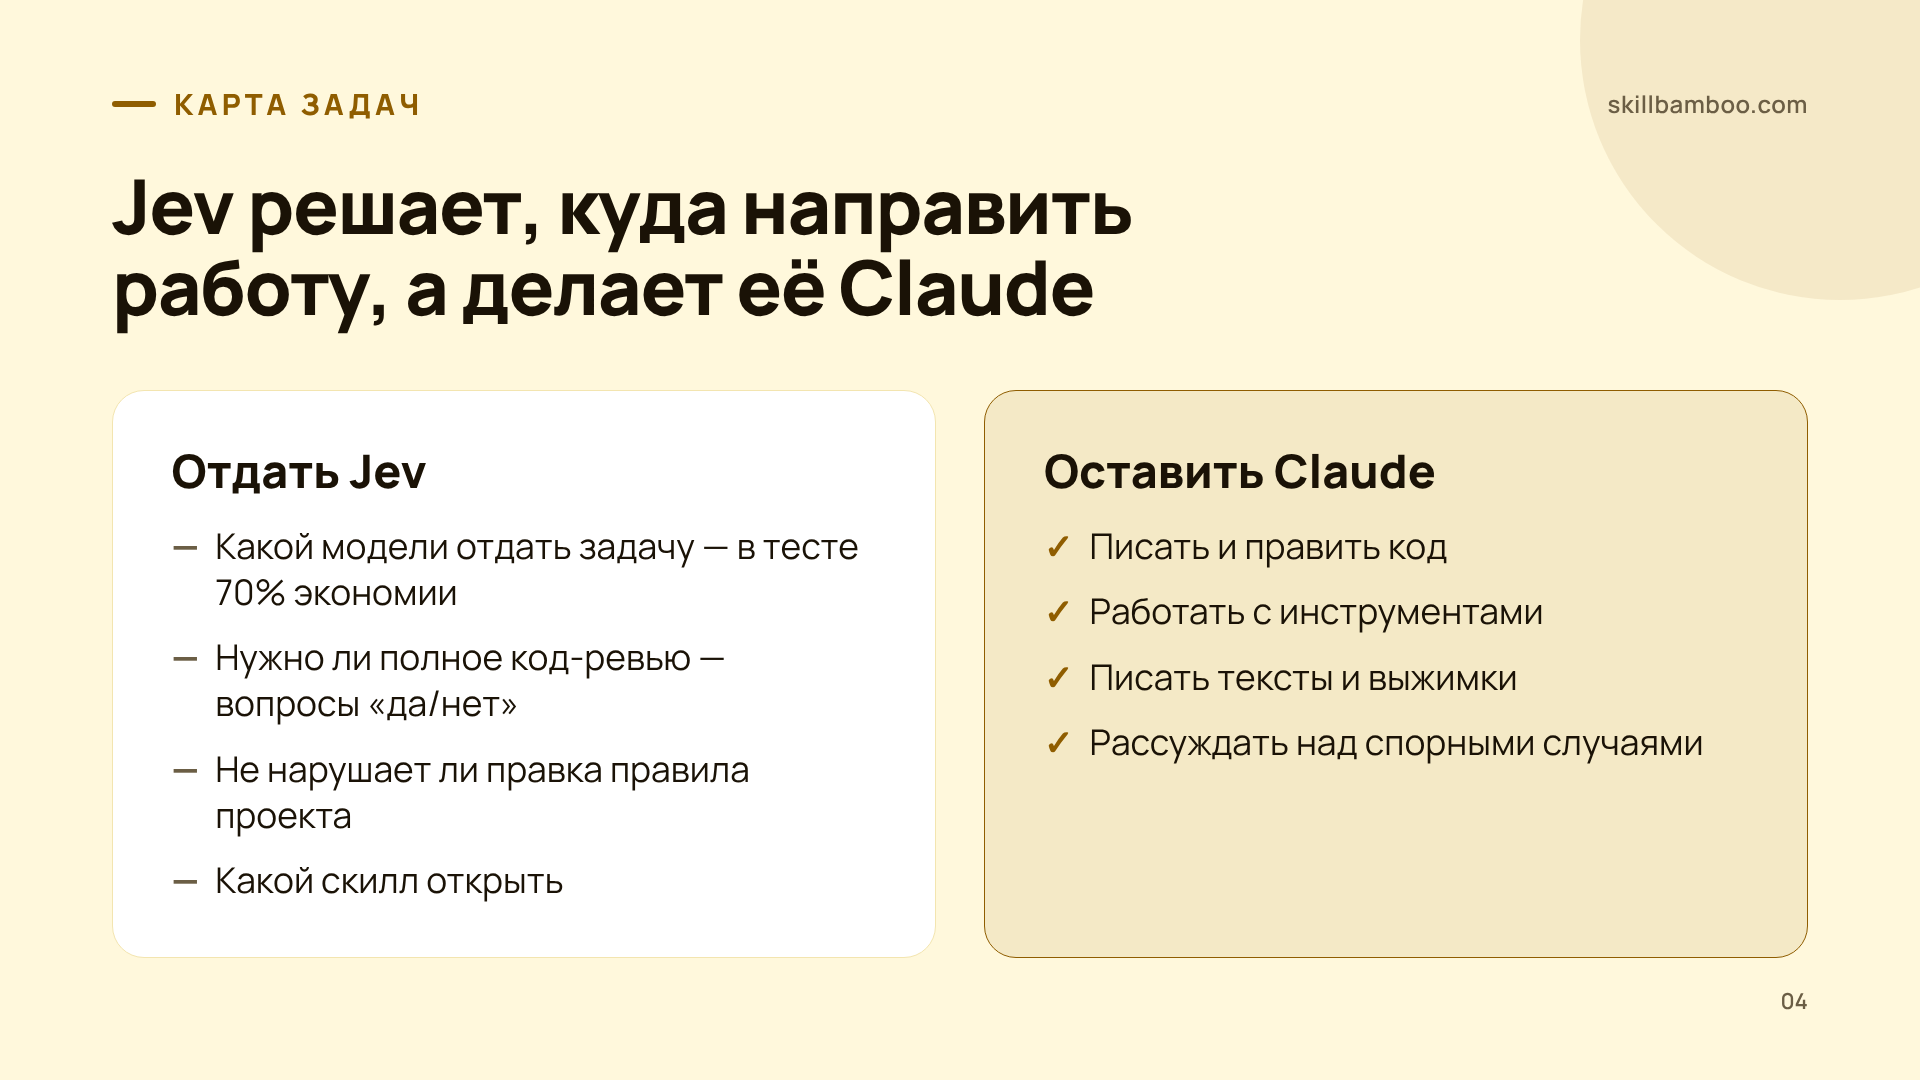
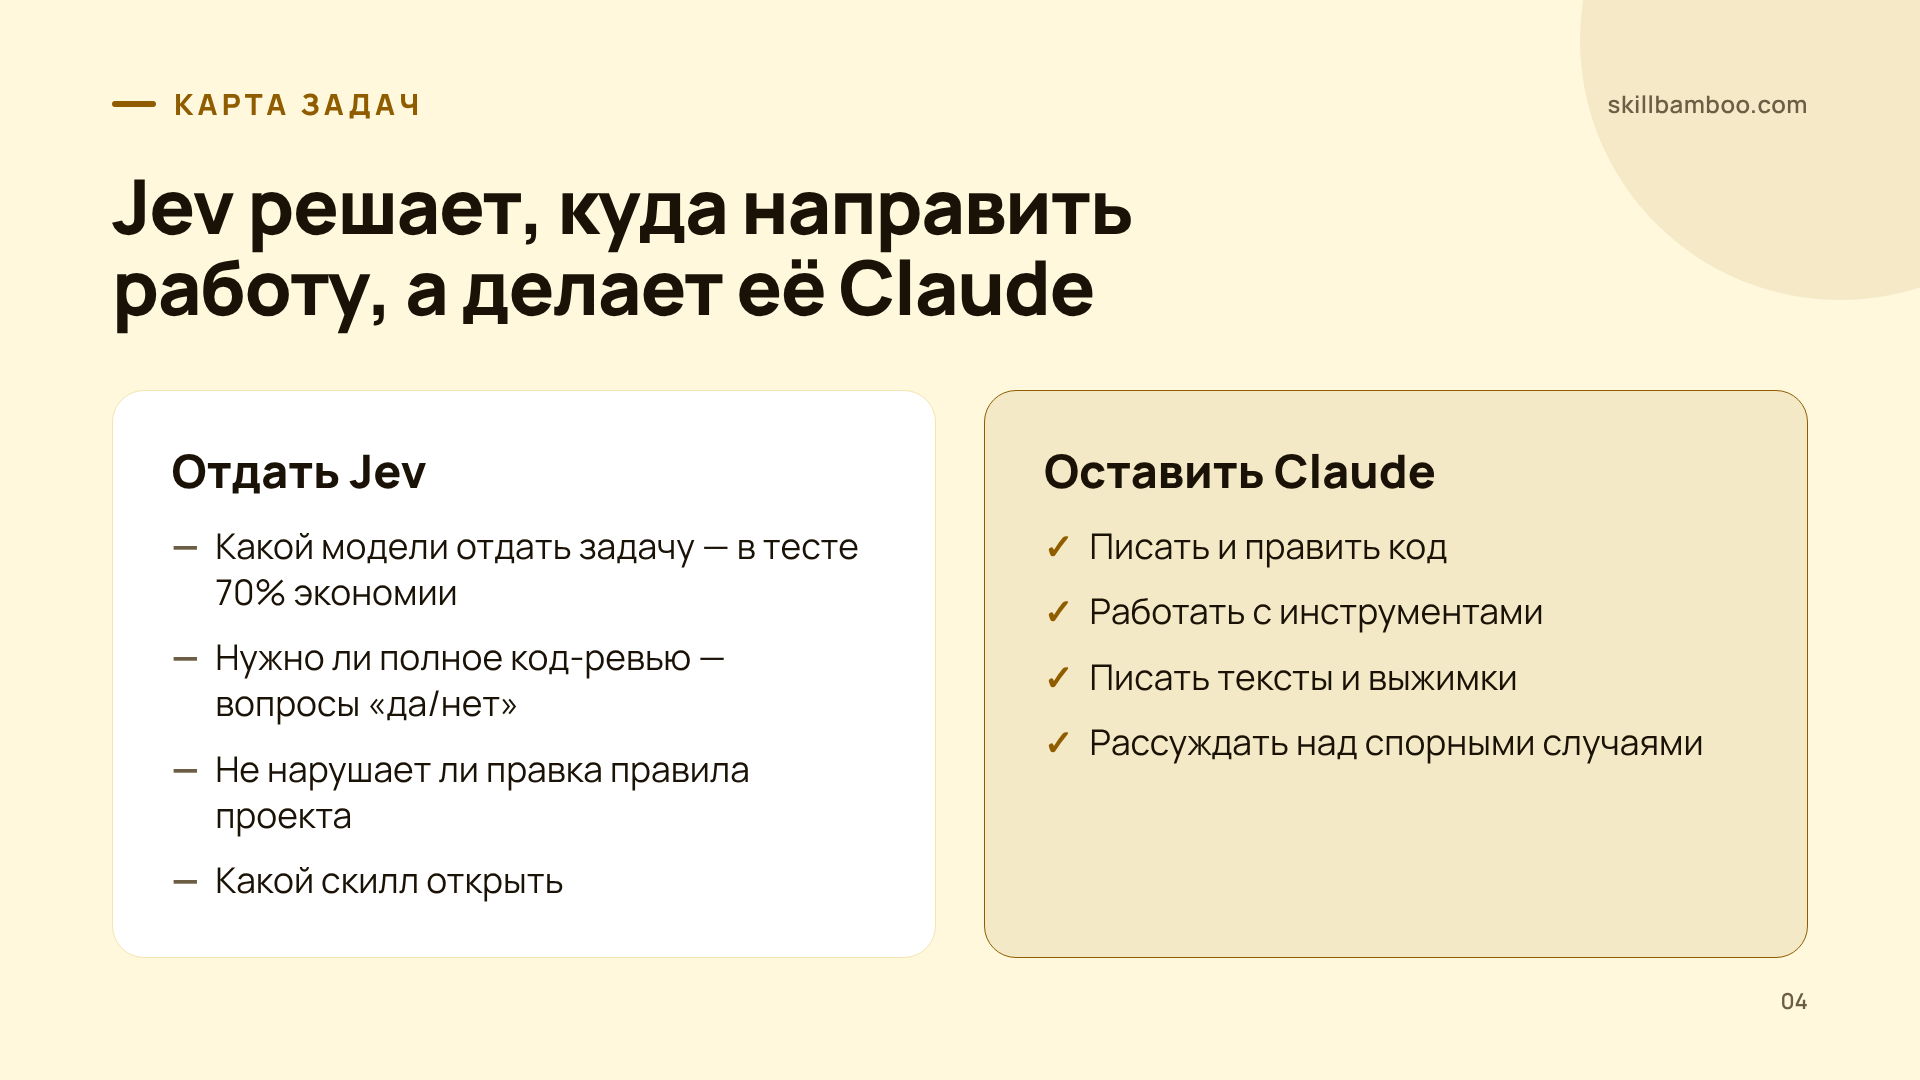
Внутри агента постоянно возникают мелкие решения: какую модель позвать, какой скилл открыть, насколько глубоко проверять правку, не нарушает ли она правила проекта. Каждое из них — выбор из ограниченного набора вариантов. Ровно то, что Jev делает быстро. Вот точки, где его уже пробовали встраивать.
| Решение в агенте | Тип вопроса к Jev | Что получаете |
|---|---|---|
| Какой модели отдать задачу | выбор из списка моделей | в тесте на 12 запросах — 70% экономии: 9 задачам из 12 топовая модель не понадобилась |
| Нужно ли полное код-ревью | серия вопросов «да/нет» о правке | если все ответы «нет», ревьюер делает один быстрый проход, иначе — полное ревью |
| Не нарушает ли правка правила проекта | «да/нет» по каждому правилу | при нарушении правка блокируется, а Claude узнаёт, какое именно правило он нарушил |
Принцип у всех трёх строк общий: Jev ничего не делает сам, он только решает, куда направить работу. Маршрутизация моделей экономит на том, что простые задачи уходят дешёвым моделям. Важное ограничение: упал ли при этом результат на задачах, отданных дешёвым моделям, в тестах не проверяли. Фильтр перед ревью — проверкой кода — экономит время на мелких правках и не ослабляет проверку рискованных. Хук с правилами (скрипт, который срабатывает на действие агента) превращает инструкции в обязательную проверку, которую агент не может пропустить.
Если агент живёт у вас на сервере и работает часами, такие хуки и проверки особенно полезны — их ставят один раз, а дальше они срабатывают на каждой правке. Как поднять сам Claude Code на своём компьютере и на VPS, разобрано в курсе «Установка Claude Code на локальный сервер + VPS».
Логика здесь такая: Jev — не дешёвая замена Claude, а слой решений внутри процесса, который у вас уже работает. Если процесса нет и агент делает одну задачу от начала до конца, встраивать некуда.
Связка Jev и Claude на потоках данных: Jev сортирует, Claude пишет
Вторая большая область — массовые потоки: обращения в поддержку, комментарии, заявки, лиды. Jev уместен там, где классифицировать и принимать решения нужно на большом объёме и в рабочем режиме, а не разово.
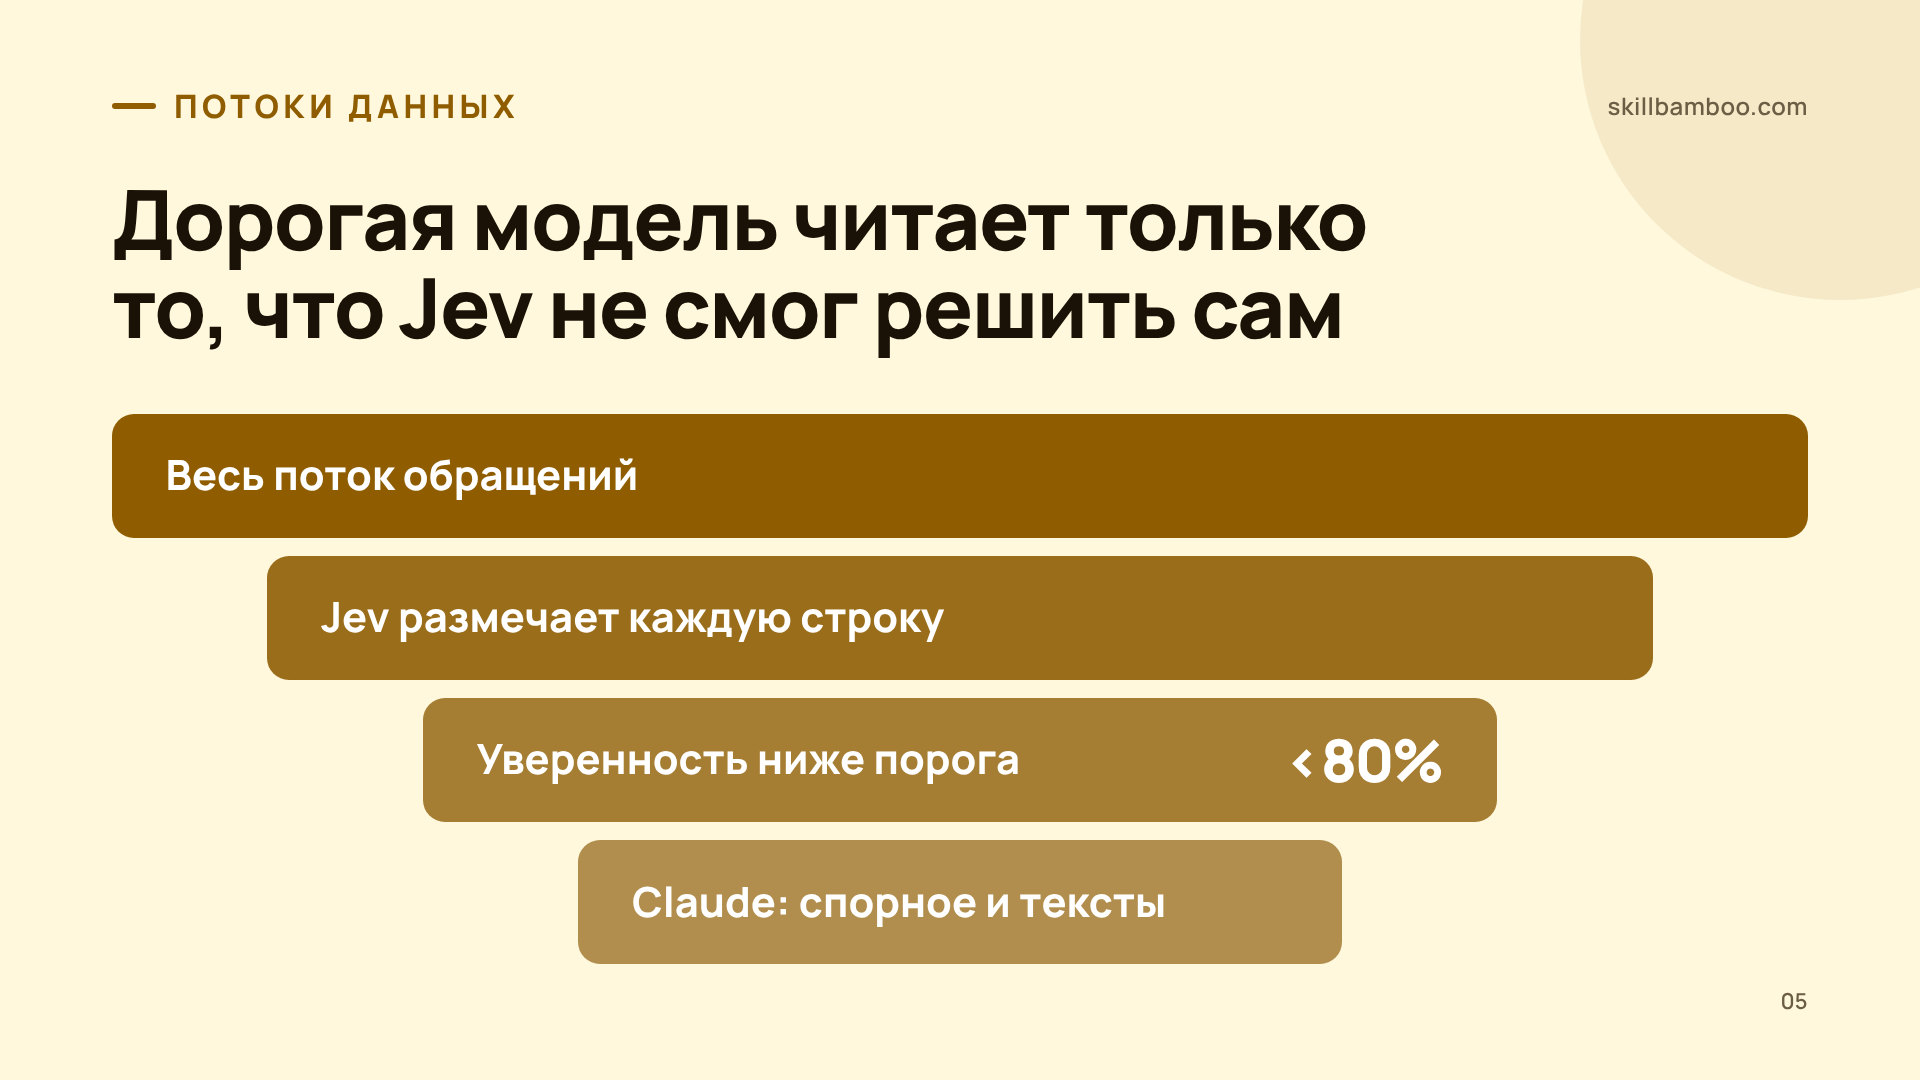
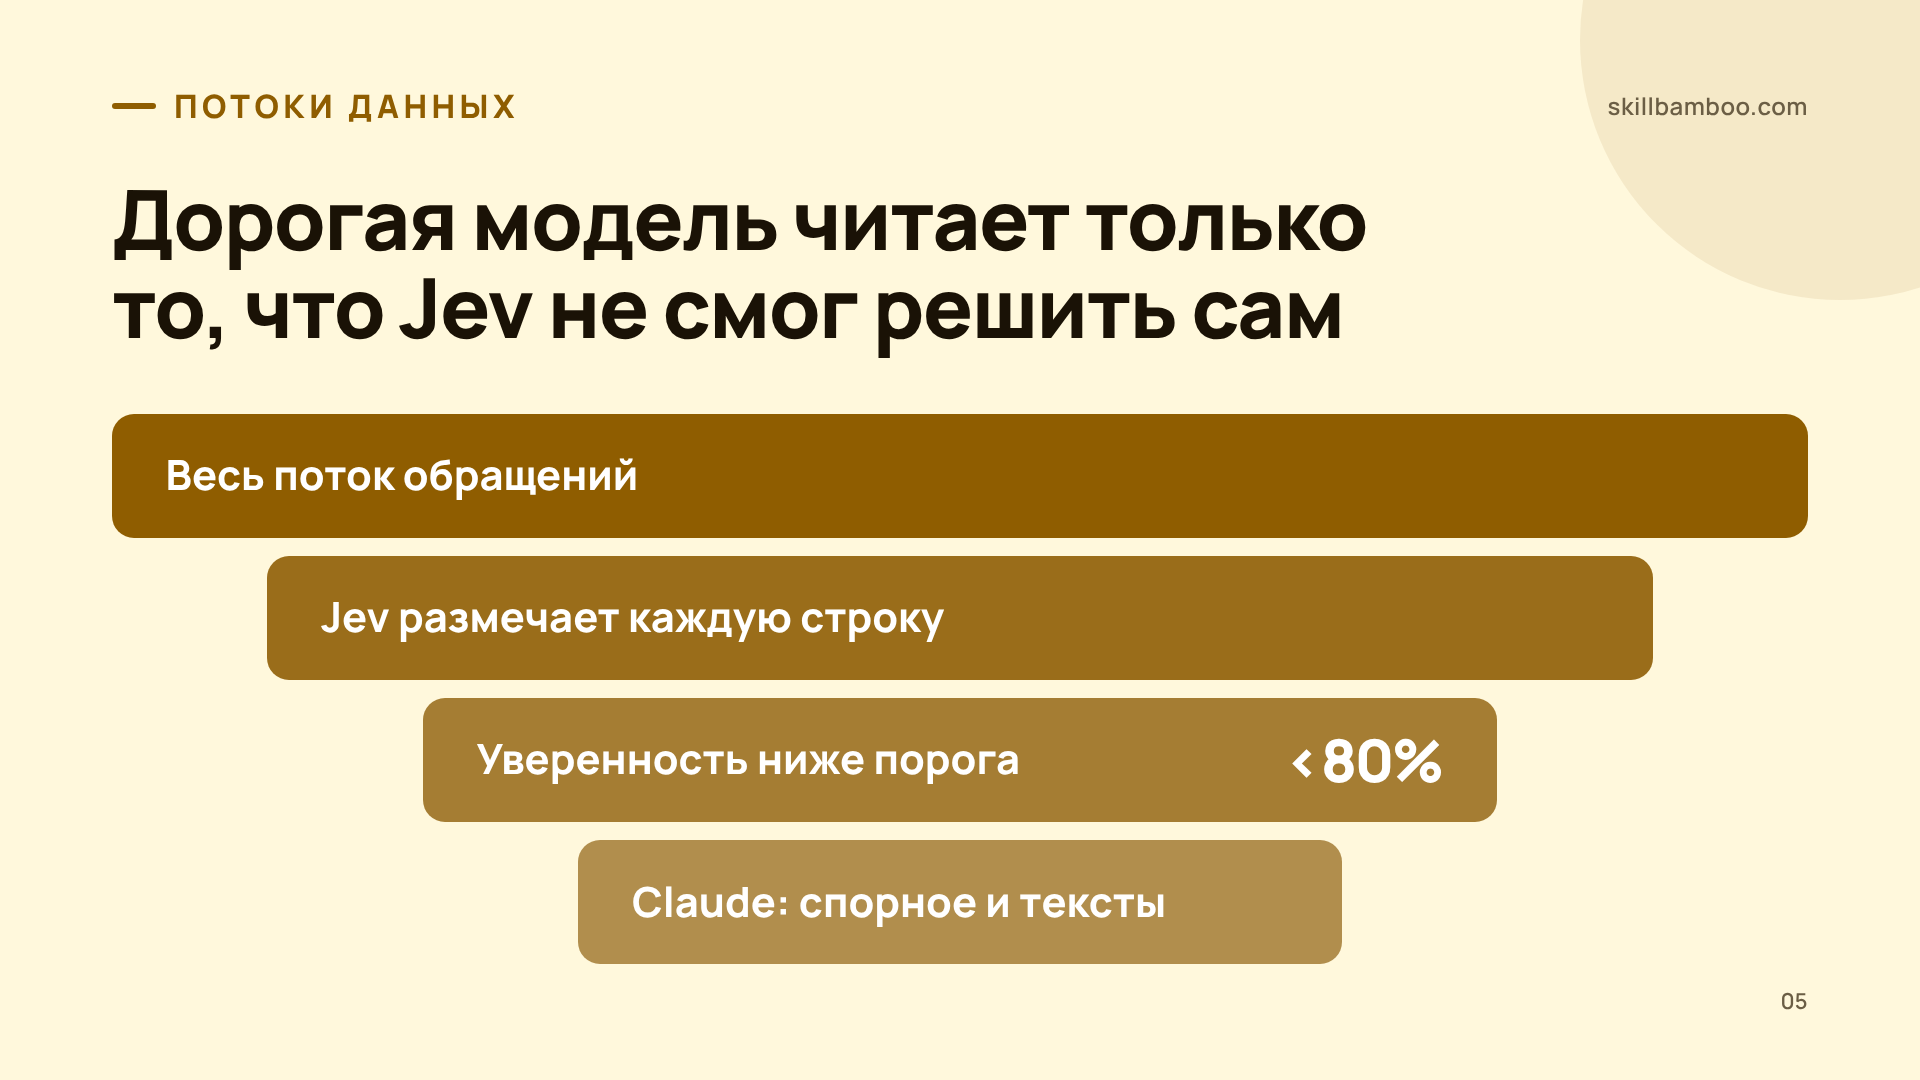
Схема простая: Jev размечает весь поток — категория, срочность, нужен ли человек. Claude получает только две группы: строки, в которых Jev не уверен, и строки, где нужно что-то написать — ответ клиенту, задачу для команды, пояснение. Всё остальное дорогая модель вообще не читает.
Граница между «уверен» и «не уверен» задаётся числом. В одном рабочем варианте связки правило такое: если уверенность Jev ниже 80% или данных для решения мало, сообщение перепроверяет Claude. Порог можно сдвигать. Выше — больше уйдёт на перепроверку и будет дороже, ниже — больше решений примется автоматически.
Не гоняйте Claude по всему потоку
Если в конвейере дорогая модель читает каждую строку только ради того, чтобы присвоить ей категорию, это первый кандидат на перенос в Jev.
Так за Claude остаётся работа, которую умеет только он: рассуждение над спорными случаями и генерация текста. А сортировка, которая раньше съедала большую часть токенов, уходит в слой, где за выход не платят.
Как правильно спрашивать Jev
Качество ответов Jev почти целиком зависит от того, как сформулированы вопросы. Сказать «вопрос некорректный» модель не может — она выберет один из предложенных вариантов. Поэтому основная работа переезжает в постановку вопросов, и её удобно поручить Claude: он пишет вопросы и критерии, Jev отвечает, скрипт действует по числам.
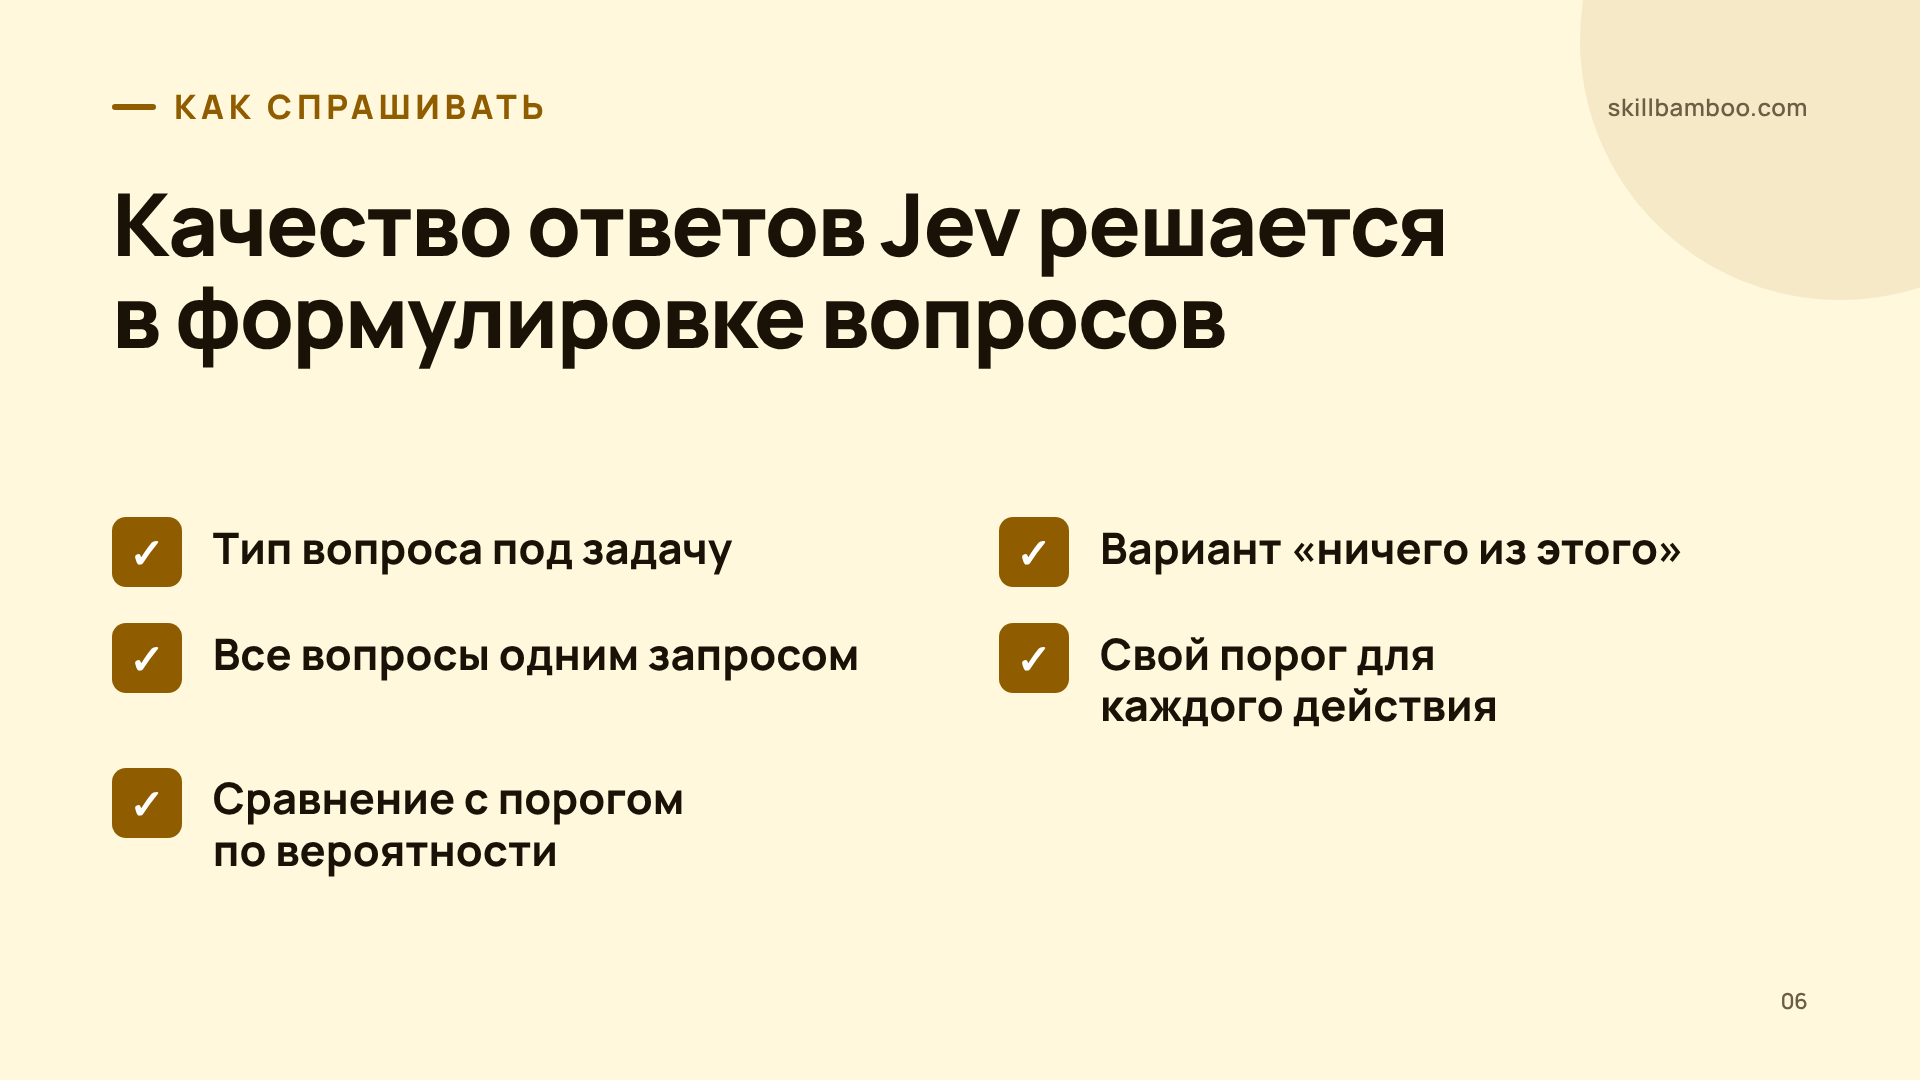
Перед запуском пройдитесь по списку:
- Для каждого вопроса выбран тип: «да/нет», если код должен действовать или нет; выбор, если надо направить в одно из мест; шкала, если надо отсортировать.
- В каждом вопросе-выборе есть вариант «ничего из этого». Без него Jev отнесёт неподходящий объект к самой похожей категории.
- Все вопросы к одному объекту собраны в один запрос. Они обрабатываются параллельно, а за чтение текста вы платите один раз.
- У каждого действия свой порог уверенности, и он зависит от цены ошибки именно в этом действии.
- Код сравнивает с порогом откалиброванную вероятность, а не просто берёт вариант с наибольшим числом.
Пороги. Отправить обращение в общую очередь можно и при средней уверенности: ошибка стоит пару минут сотрудника. Автоматически закрыть тикет или заблокировать правку лучше только при высокой — здесь ошибка обходится дороже. Один порог на всё — частая причина, почему автоматика то перестраховывается, то пропускает лишнее.
Где связка не окупается и как это проверить
Jev выигрывает на количестве, а не на отдельном решении. Когда решение одно и ответ очевиден, дополнительный вызов только удлиняет цепочку. Это хорошо видно на тесте в сентябре 2026 года: на простой задаче — собрать форму на React из готовых компонентов — связка с Jev оказалась примерно на 4,2 секунды медленнее и примерно на 50% дороже, чем Claude в одиночку. Jev там выбирал скилл и проверял результат, но экономить было не на чем.
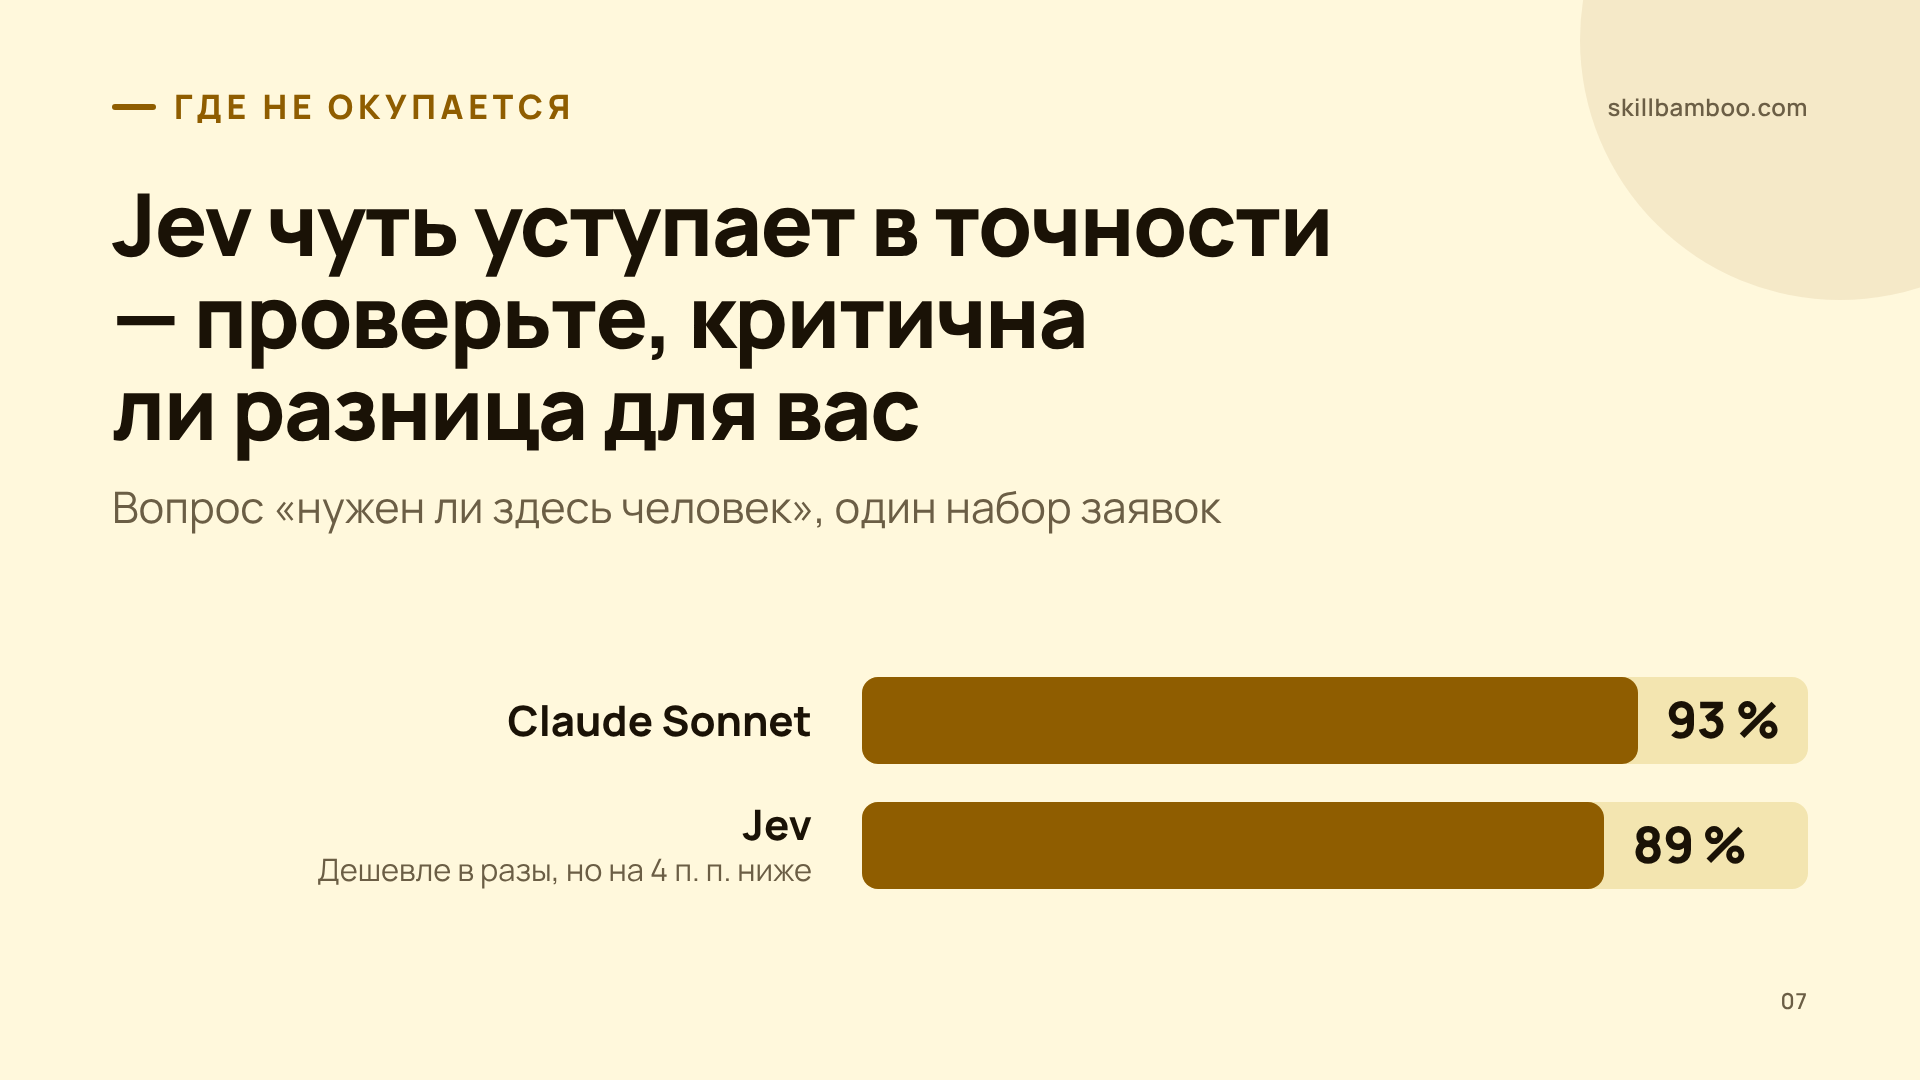
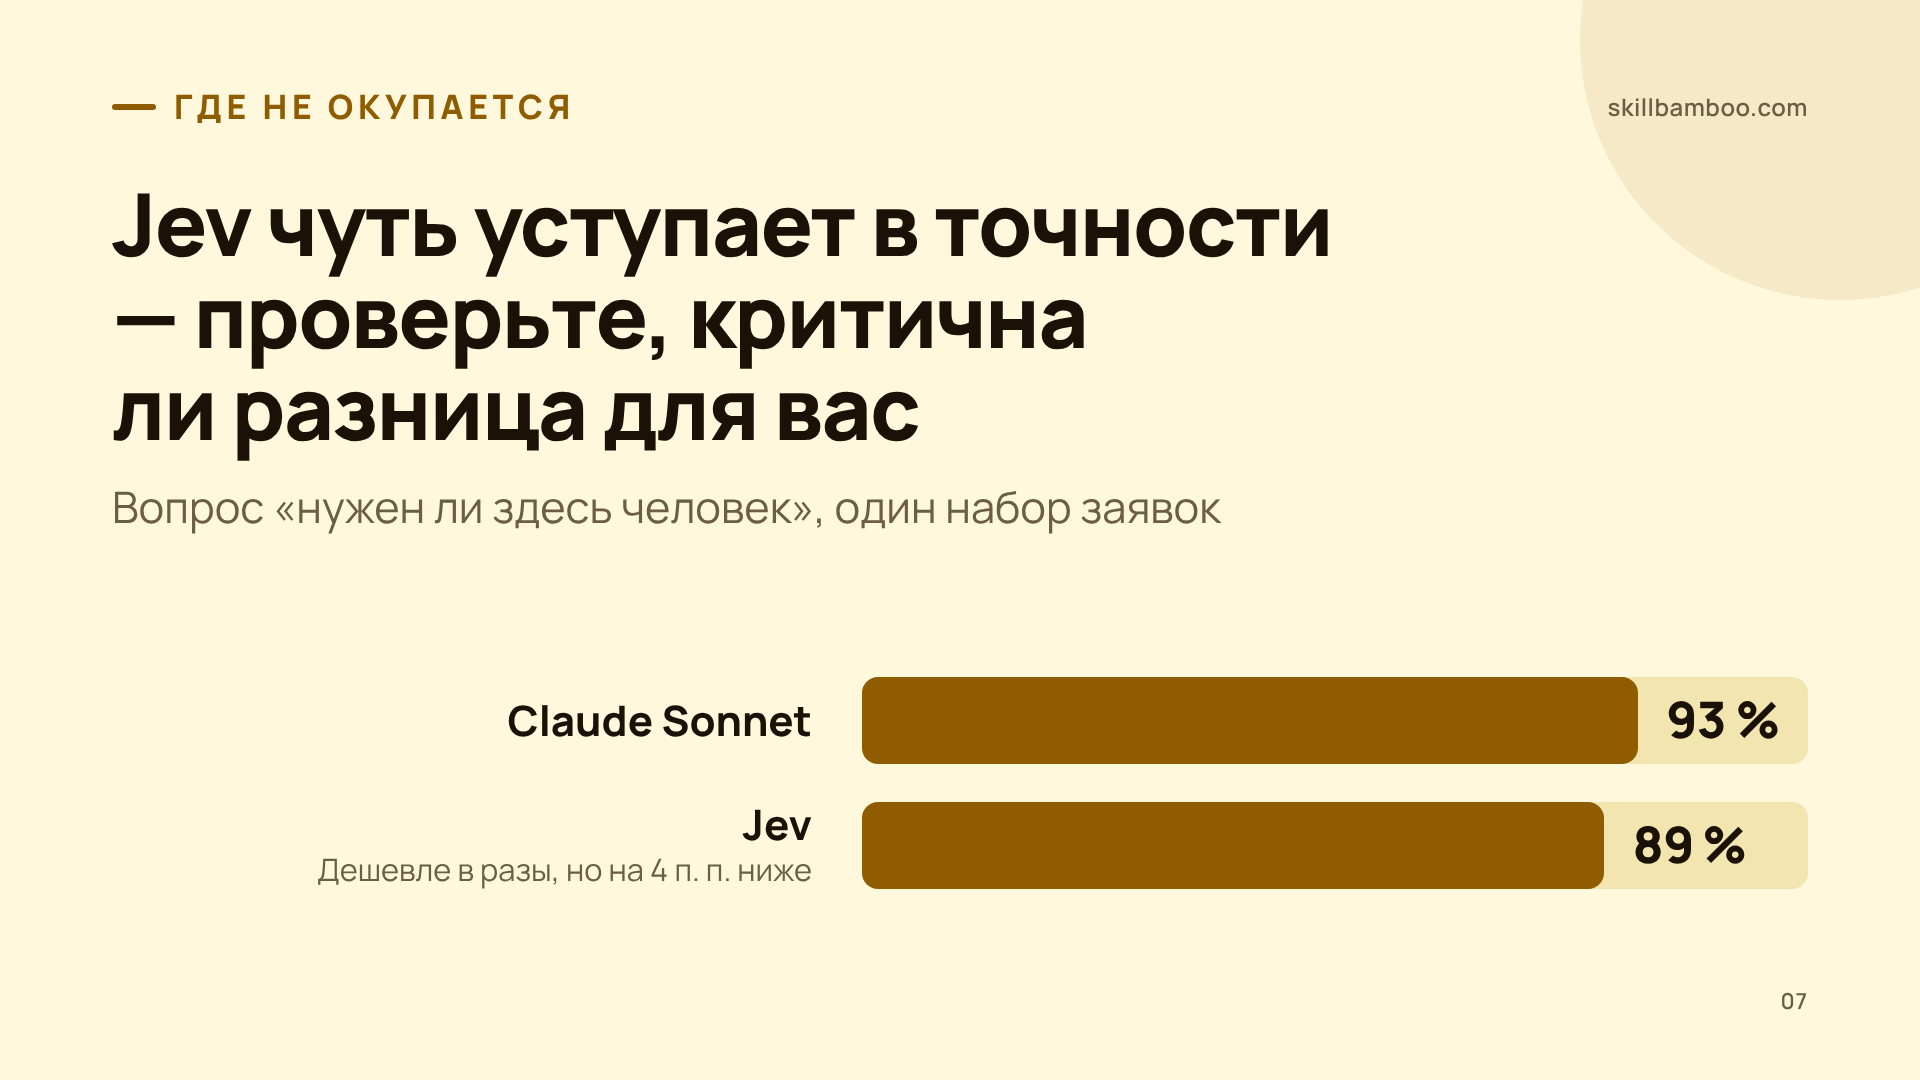
Второй вопрос — точность. В сравнении на одном наборе заявок по вопросу «нужен ли здесь человек» Jev был прав в 89% случаев, Claude Sonnet — в 93%. Разница небольшая, и при многократной разнице в цене она часто того стоит. Но для каких-то решений четыре процентных пункта могут оказаться критичными. Все зависит от того, сколько стоит ошибка.
Не подключайте Jev вслепую
Перед внедрением соберите эталонный набор: около 100 примеров из ваших реальных данных с заранее известными правильными ответами. Прогоните по нему Jev и модель, которую используете сейчас, и сравните точность, стоимость и, если важно, скорость.
Такой набор отвечает сразу на оба вопроса: даст ли Jev выигрыш на ваших объёмах и не просядет ли качество там, где ошибка стоит денег. Если отличий в точности нет, а объёмы большие, — переносите. Если задача единичная или точность заметно падает, оставляйте её Claude.
Ключевые термины
- Модель-классификатор (модель решений) — Модель, которая не генерирует текст, а возвращает выбор из заданных вариантов с вероятностью.
- Калиброванная вероятность — Вероятность, которая совпадает с реальной частотой: ответ 0,8 верен примерно в восьми случаях из десяти.
- Порог уверенности — Значение уверенности, ниже которого программа не действует автоматически, а передаёт решение Claude или человеку.
- Маршрутизация моделей — Автоматический выбор, какой модели отдать задачу — дешёвой для простых и мощной для сложных.
- Хук — Скрипт, который Claude Code запускает при каждом заданном событии, например перед правкой файла, и который модель не может пропустить.
- Эвал — Проверка модели на эталонном наборе примеров с заранее известными правильными ответами.
Итог: решения — Jev, работа — Claude
Главное: Jev — быстрый классификатор с откалиброванными вероятностями, а не дешёвая версия Claude. Ему стоит отдавать маршрутизацию моделей, выбор скиллов, фильтры перед проверками и массовую разметку, а Claude оставлять текст, код и разбор спорных случаев. Связка окупается там, где решений много и они однотипны, и проигрывает на одиночных простых задачах. Начните с одного потока, где Claude сейчас тратит токены на сортировку: сформулируйте вопросы с вариантом «ничего из этого», задайте пороги и проверьте результат на эталонном наборе. Если агент у вас ещё не работает постоянно, сначала разверните его — в курсе «Установка Claude Code на локальный сервер + VPS» это разобрано по шагам.
Проверьте себя
1. Какую задачу в агенте разумно отдать Jev?
- А. Сделать выжимку длинного созвона
- Б. Отредактировать код по замечаниям ревью
- В. Выбрать один скилл из библиотеки в 140 скиллов по запросу пользователя
- Г. Написать черновик ответа клиенту
Показать ответ
Ответ: В. Это выбор из списка вариантов — ровно та форма ответа, в которой Jev быстр и дёшев.
2. Вы просите агента собрать одну простую форму на React. Стоит ли добавлять шаг с Jev для выбора скилла?
- А. Да, потому что Jev сам соберёт форму быстрее
- Б. Скорее нет: на одиночной простой задаче лишний вызов может сделать путь медленнее и дороже
- В. Да, Jev всегда ускоряет работу
Показать ответ
Ответ: Б. Выигрыш Jev появляется на множестве однотипных решений, а не на одном очевидном.
3. Jev выбирает категорию обращения: биллинг, техника или функция. Что важно добавить в варианты?
- А. Вариант «ничего из этого»
- Б. Как можно больше почти одинаковых категорий
- В. Просьбу объяснить выбор текстом
Показать ответ
Ответ: А. Без запасного варианта модель отнесёт неподходящее обращение к самой похожей категории.
4. Как выбирать порог уверенности для автоматических действий?
- А. Порог не нужен, Jev не ошибается
- Б. Один порог 0,5 на все действия
- В. Отдельно для каждого действия — выше там, где ошибка дороже
Показать ответ
Ответ: В. Показать баланс можно при низкой уверенности, а перевод денег требует высокой.
5. Нужно пометить 5000 обращений и на спорные написать ответы. Какая схема разумнее?
- А. Отдать всё Jev, включая написание ответов
- Б. Отдать всё Claude — он точнее
- В. Jev размечает все обращения, Claude получает только неуверенные и те, где нужен текст
Показать ответ
Ответ: В. Так дорогая модель тратит токены только там, где без неё не обойтись.