SkillBamboo
Ситуация из серии «задача в Claude Code на середине, а счётчик пятичасового лимита почти на нуле». Лимиты Claude Code на тарифе за $20 кончаются, до конца недели ещё несколько дней, и непонятно, кто виноват: тариф или то, как вы работаете. Может, выгоднее уйти на Codex или Cursor? Я решил разобрать замер трёх подписок за $20 на одних и тех же задачах и посмотреть, почему лимит тает в настоящих проектах. Цель простая: выбрать тариф под свой ритм работы и раскидать задачи между Opus, Sonnet и Haiku так, чтобы недельного лимита хватало на всю неделю.
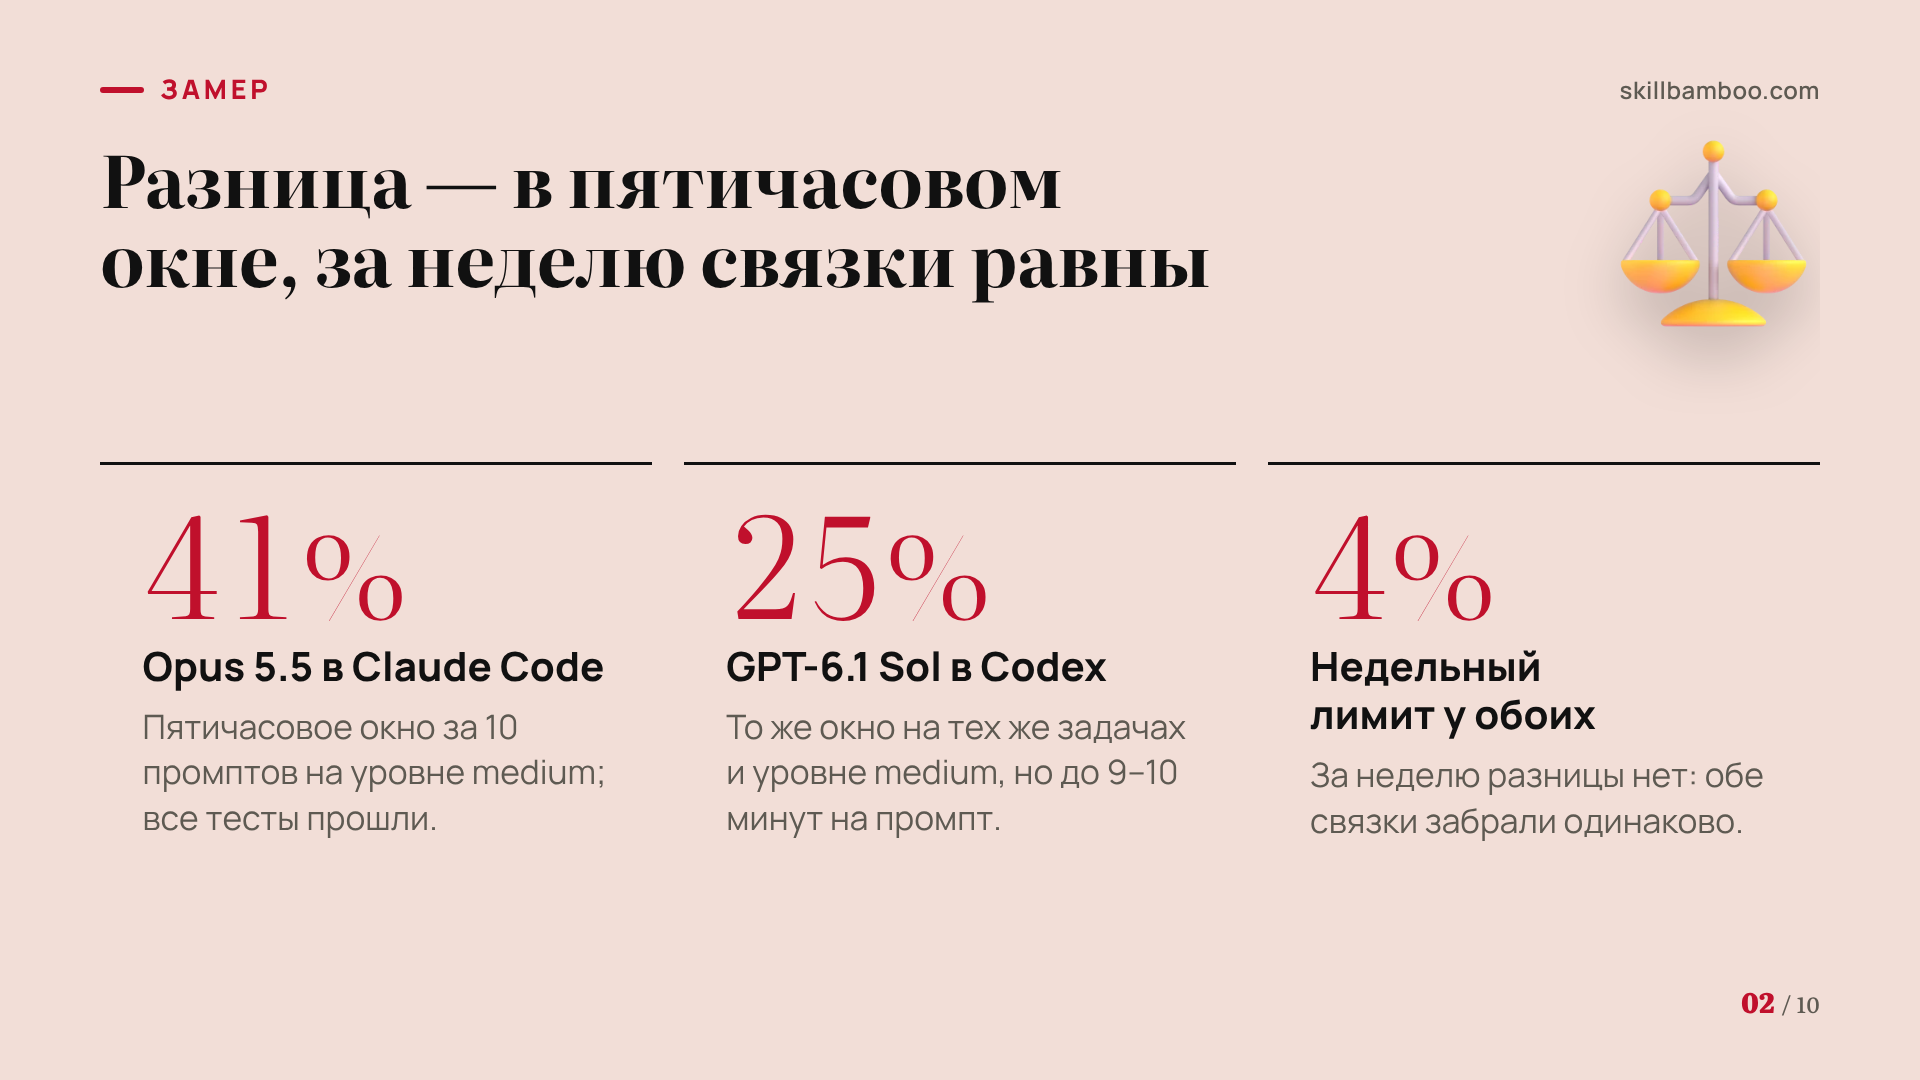
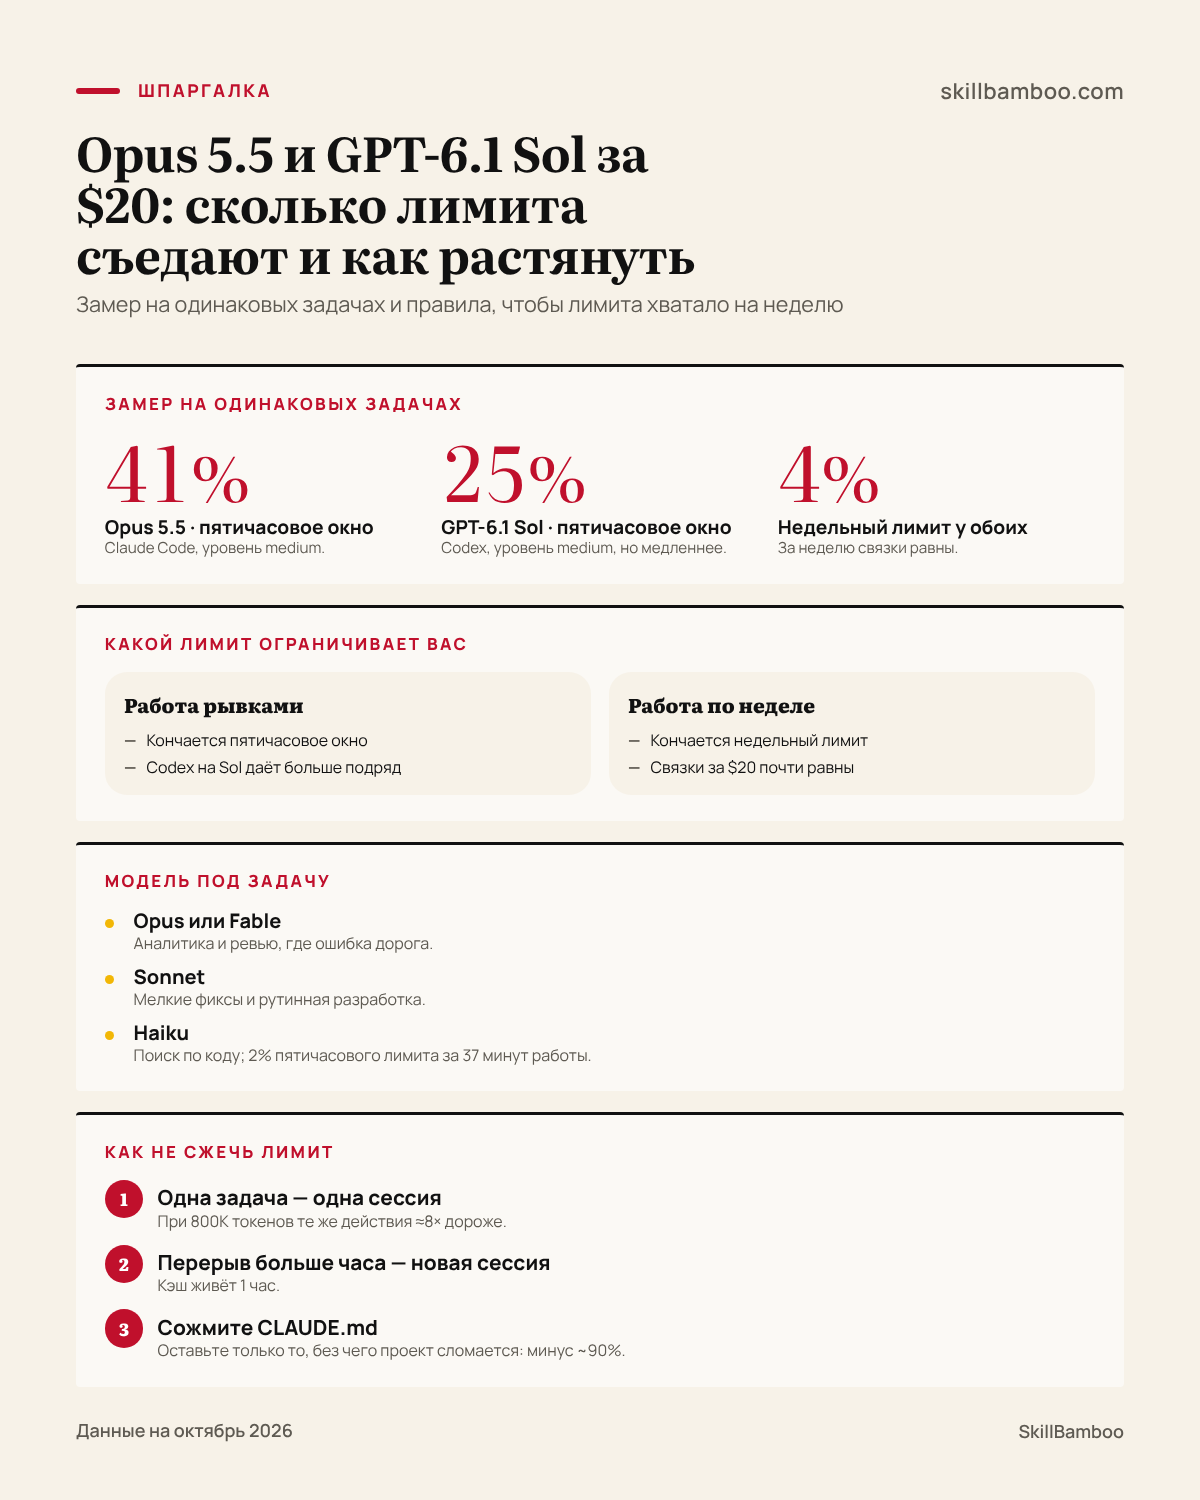
Главное открытие замера неожиданное. На одних и тех же задачах Claude Code с Opus 5.5 забрал 41% пятичасового окна, а Codex с GPT-6.1 Sol – 25%. Но недельный лимит у обоих сдвинулся одинаково: на 4%. А вот одна и та же работа при контексте в 800К токенов стоит почти в 8 раз больше, чем при 100К. То есть выбор тарифа решает меньше, чем кажется.
Как сравнивали: одни и те же задачи на трёх тарифах за $20
В сравнении участвовали три подписки по $20: Claude Code от Anthropic, Codex в составе ChatGPT и Cursor (там доступны модели Grok и Composer). Это ровно тот выбор, перед которым стоит разработчик или фрилансер, когда одного тарифа перестаёт хватать.
Cursor Docs – Models & Pricing – Тариф Cursor Pro за $20 и пулы моделей
Важная оговорка: Claude Code, Codex и Cursor – оболочки, через которые модель работает с вашим кодом. Лимит расходует модель внутри и её уровень рассуждений. Поэтому честно сравнивать можно только связки «продукт · модель · уровень», а не «Claude Code против Codex» вообще.
Механика замера простая – всем моделям давали одинаковые промпты, и каждый запуск начинали с чистого листа, без заранее прогретого кэша. Всего 10 промптов: по пять запусков на каждый из двух проектов. Связки в замере такие:
- Claude Code – сначала Opus 5.5 на уровне усилий medium, потом Sonnet 5.5 на уровне high;
- Codex – GPT-6.1 Sol на уровне medium;
- Cursor – Grok 4.6 на уровне high, без быстрого режима.
Стартовую точку тоже зафиксировали. Перед замером на тарифе $20 уже было израсходовано 7% пятичасового и 28% недельного лимита Claude Code. В Codex счётчик показывает остаток: до старта там оставалось 93% пятичасового и 90% недельного лимита. Дальше уже считали, насколько сдвинутся оба счётчика.
Но у такого замера есть ограничение. Задачи были короткими и отдельными, без многочасовых сессий; а в длинной сессии расход начинают определять размер контекста и кэширование (и у разных моделей это устроено по-разному). Поэтому цифры ниже = нижняя граница. В живом проекте с длинной историей диалога лимит, скорее всего, уйдёт быстрее (виноваты контекст и кэш).
Сравнение лимитов Claude Code, Codex и Cursor: сколько съели одинаковые задачи
Проценты в таблице – доля своего лимита у каждой подписки, которую съели одни и те же 10 промптов.
| Связка: продукт · модель · уровень | Пятичасовой лимит | Недельный лимит | Тесты | Время |
|---|---|---|---|---|
| Claude Code · Opus 5.5 · medium | 41% | 4% | все прошли | 27 минут на все 10 промптов |
| Claude Code · Sonnet 5.5 · high | около 27% | около 2% | в одном проекте падали 2 теста | нет данных |
| Codex · GPT-6.1 Sol · medium | 25% | 4% | все прошли | от 4 до 9–10 минут на промпт |
| Cursor · Grok 4.6 · high | такого лимита нет | такого лимита нет, месячный вырос на 2% | местами падали | больше часа на все 10 |
Картина такая. Codex с GPT-6.1 Sol бережнее расходует пятичасовое окно: 25% против 41% у Opus 5.5. А недельный лимит обе связки сдвинули одинаково, на 4%. Тесты у обеих прошли полностью, но Sol заметно медленнее: один промпт у него занимал от 4 до 9–10 минут, а Opus справился со всеми десятью за 27 минут.
Учтите, что именно сравнивали. Sol – не старшая модель OpenAI: по описанию компании, она даёт результат, близкий к старшей GPT-6 Astra, но дешевле. Так что это не модели одного уровня, а цена одинакового результата: Opus 5.5 и Sol на уровне medium сделали всё без ошибок. Другая модель или другой уровень в Codex дадут другие цифры, как Opus и Sonnet внутри одного Claude Code.
OpenAI – GPT-6.1 Sol – Место Sol в линейке GPT-6, уровни рассуждений и цены по API
Sonnet 5.5 на уровне high обходится дешевле Opus: после него счётчики Claude Code показали 75% пятичасового и 34% недельного лимита, то есть он забрал около 27% окна и 2% недели. Но экономия оплачивается качеством: в одном из проектов у него падали два теста, и как раз в этом состояла разница между моделями. Когда код потом всё равно проверяется, это нормально. А без проверки сэкономленный лимит уйдёт на исправления.
Cursor с Grok 4.6 в эту таблицу напрямую не встаёт. У него нет ни пятичасового, ни недельного лимита – только месячный, и за те же 10 промптов он вырос всего на 2%. Но это доля месяца, а не недели: с 4% у Claude Code и Codex её не сравнить. К тому же связка оказалась самой медленной (больше часа на весь набор), и тесты у неё местами падали.
Если вы из России и только собираетесь подключать Claude, сначала понадобится рабочий аккаунт и способ оплаты: как оформить подписку на Claude.ai из России.
Пятичасовой или недельный лимит Claude: что на самом деле ограничивает
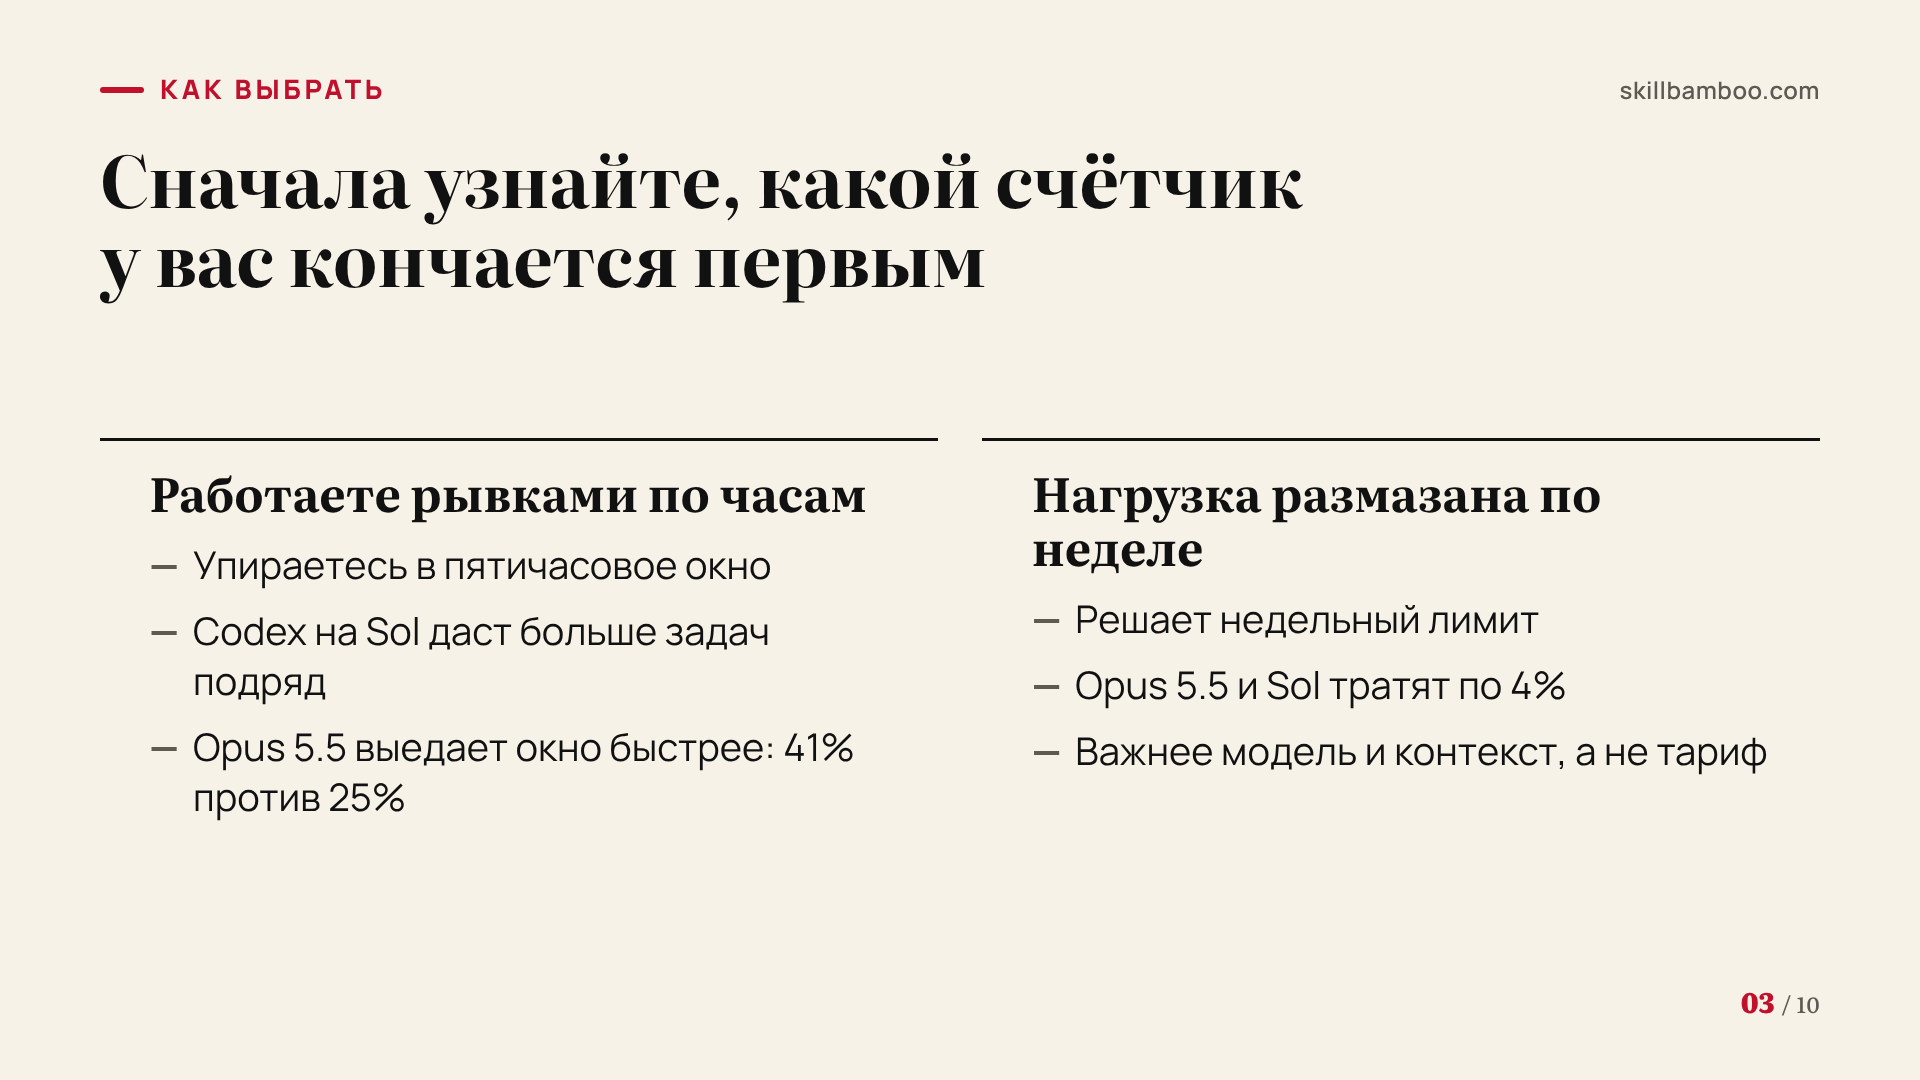
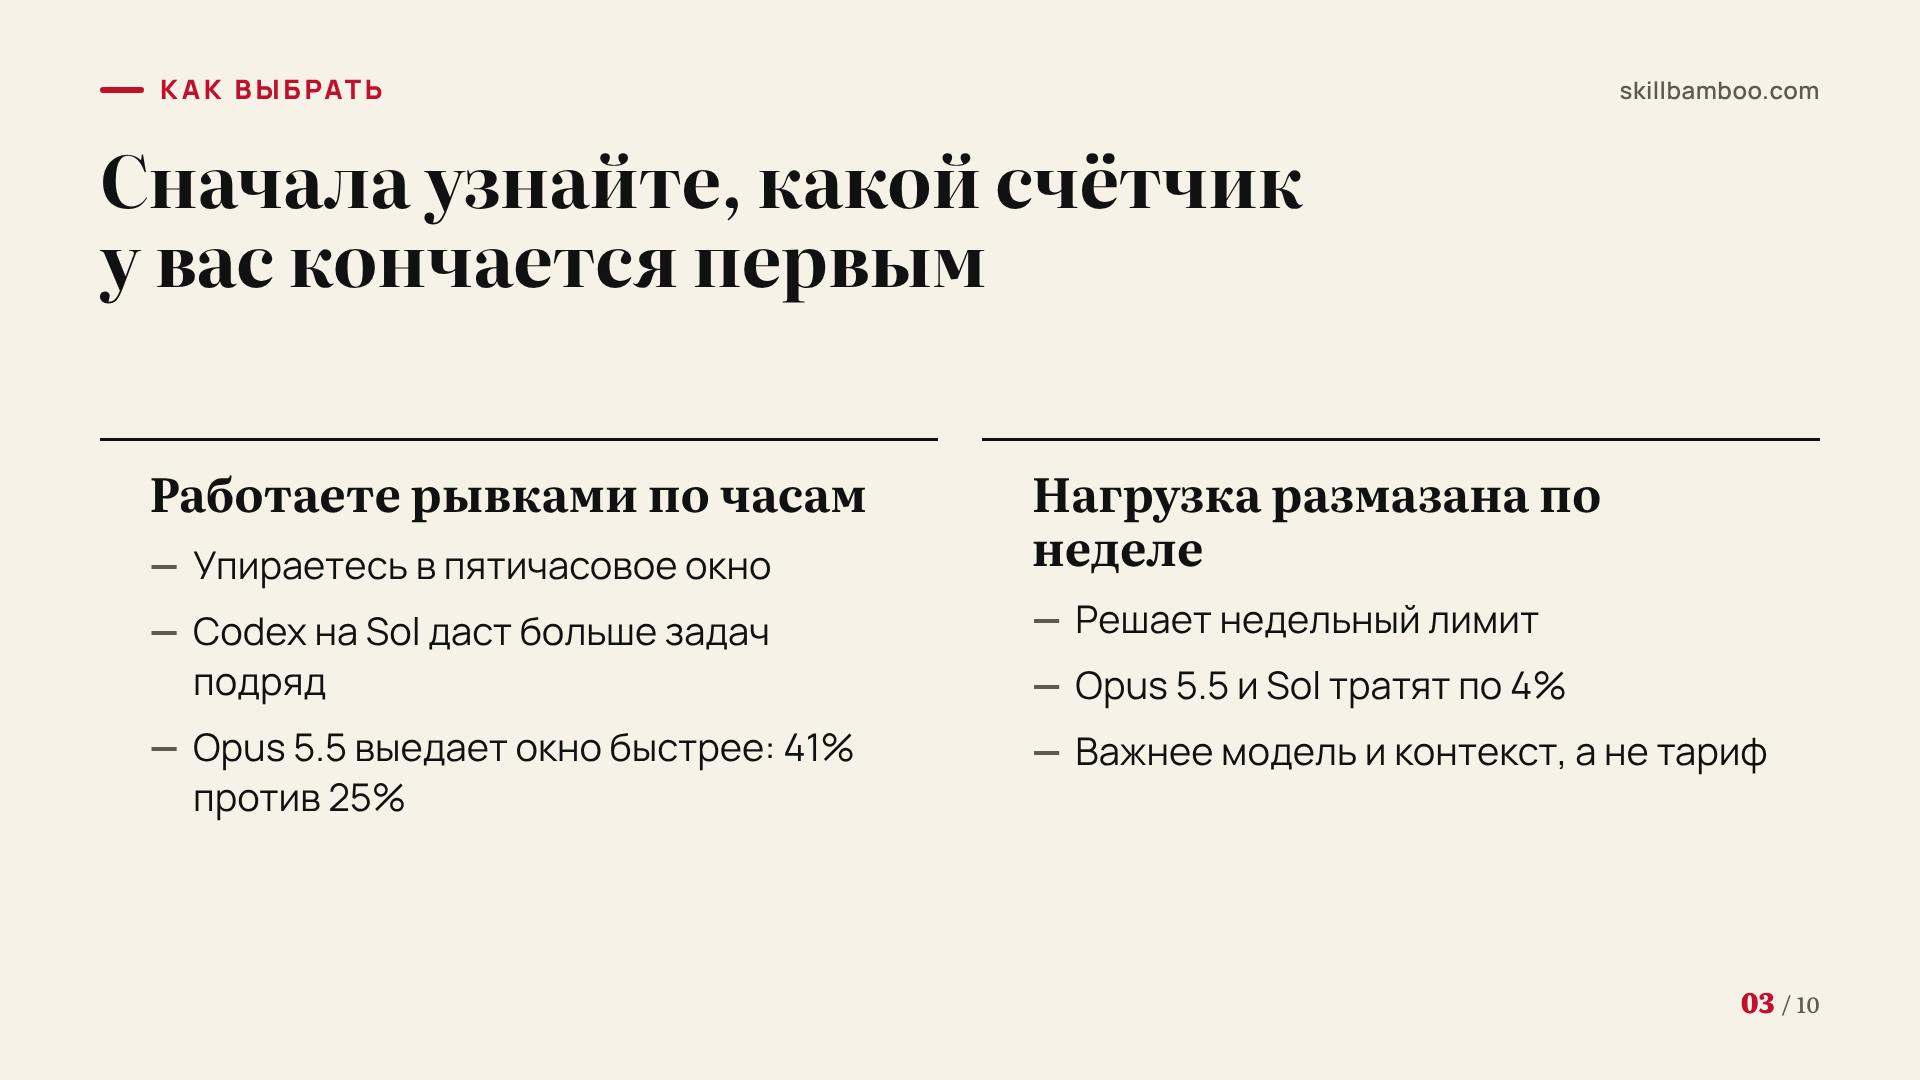
Вывод из таблицы простой: Opus 5.5 съедает пятичасовой лимит быстрее, чем Sol в Codex, но недельный – так же. То есть решает ваш ритм работы.
Работаете плотными рывками, по несколько часов подряд гоняя агента по задачам? Тогда упрётесь в пятичасовое окно. Здесь у Codex на Sol запас больше: подряд он позволит сделать больше задач, хотя каждая будет идти дольше. Если же нагрузка размазана по неделе, решает недельный лимит, а по нему тарифы за $20 в этом замере оказались практически равны.
Есть нюанс: замеры расходятся. Другая независимая оценка того, сколько API-использования на самом деле покупает подписка, пришла к выводу, что тариф Claude выгоднее ChatGPT. Небольшой замер на коротких задачах и более широкая оценка дают разные ответы, т.к. результат зависит от задач, моделей и того, как устроена работа. К тому же в замере всего 10 промптов, по прогону на связку, а счётчики – в целых процентах: «4% и 4%» значит лишь, что на таком объёме разницы не видно.
Как читать эти цифры
Пятичасовое окно ограничивает интенсивность, а недельный лимит ограничивает общий объём. Сначала поймите, какой счётчик у вас заканчивается первым, и только потом сравнивайте тарифы.
Почему лимит тает в реальной работе: контекст, кэш и батчи
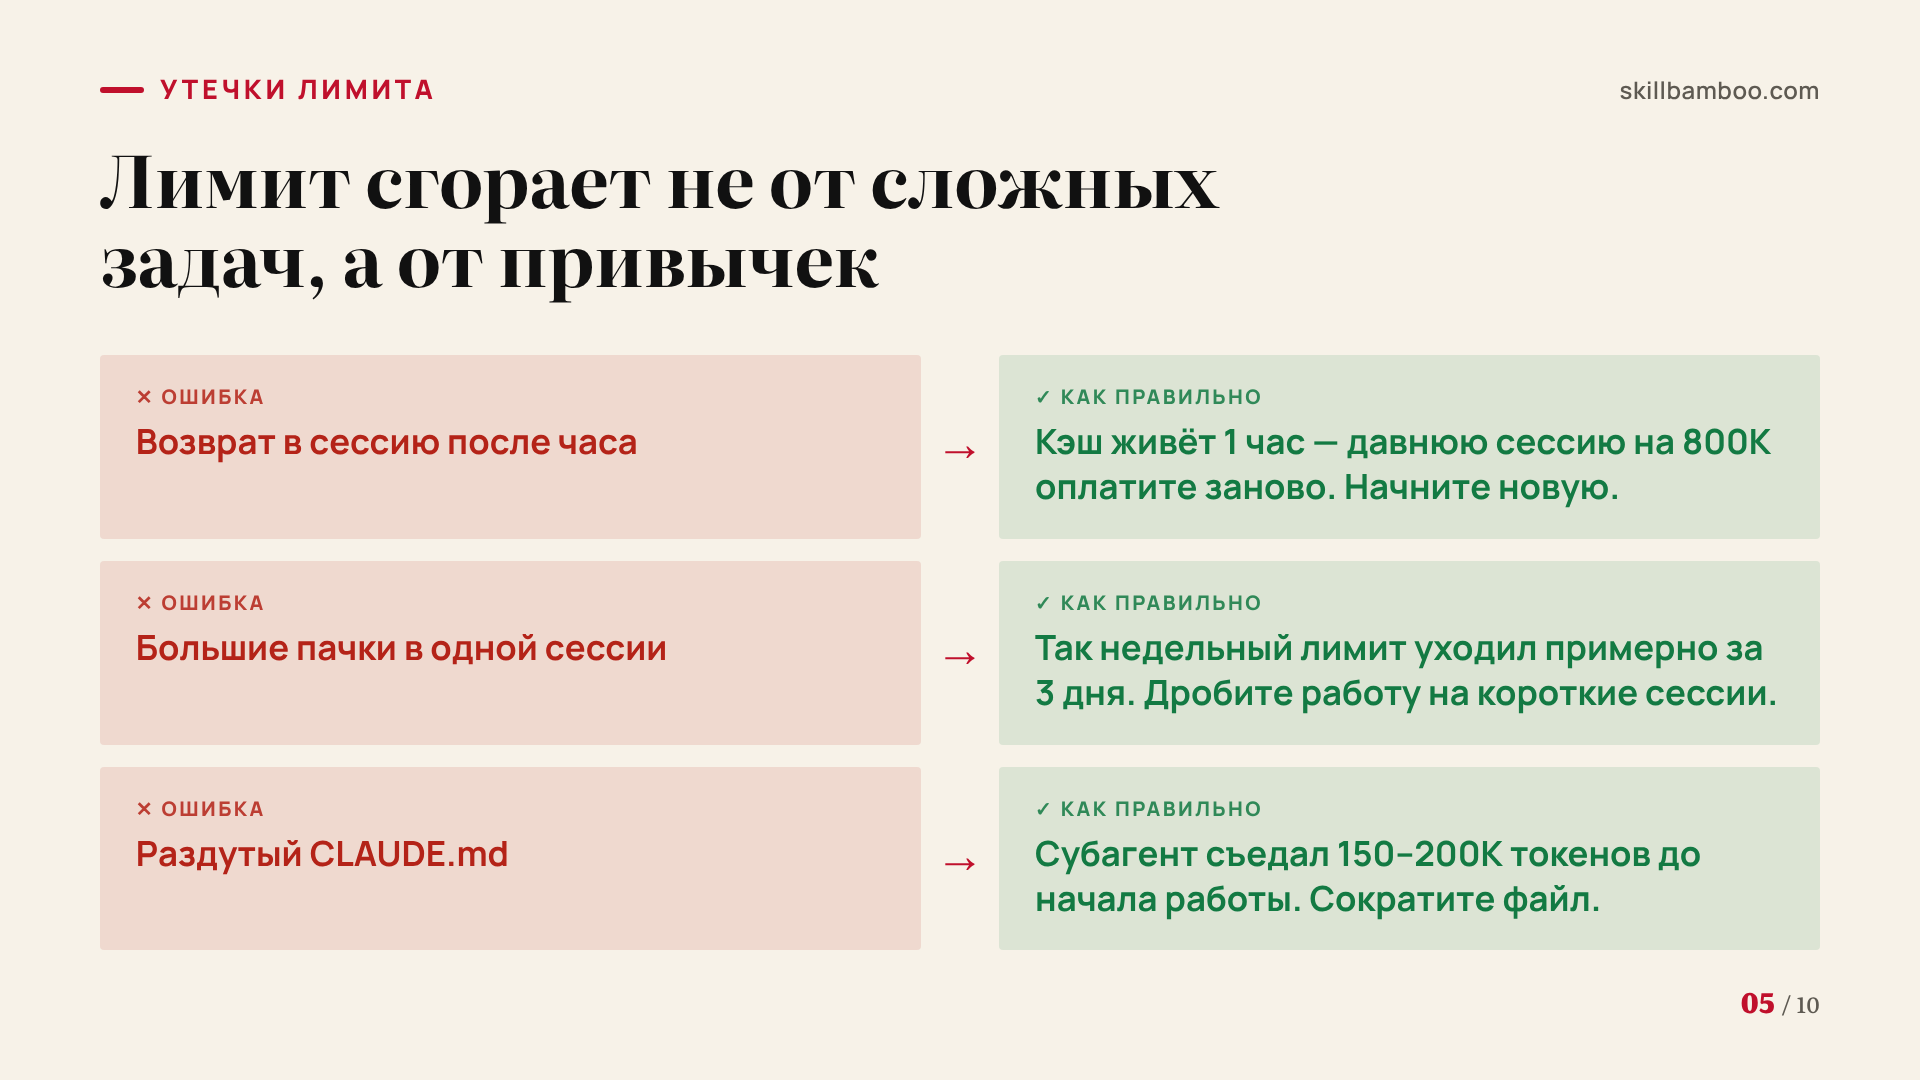
В замере недельный лимит сдвинулся на единицы процентов. В реальных проектах картина другая. Кейс: один разработчик в августе 2026 года обнаружил, что лимитов ему хватает только на проектирование решений, а саму реализацию приходится переносить на следующую неделю. При работе большими пачками задач недельный лимит у него заканчивался примерно за 3 дня. И дело оказалось не в сложности задач, а в устройстве кэша и контекста.
Механика тут простая – и неприятная. На подписке в пределах лимита главный агент в Claude Code хранит кэш 1 час между запросами (с API-ключом или на платных usage credits – 5 минут). Субагенты ушли в долгую работу, вернулись позже, а кэш уже протух. В итоге следующее обращение к давней сессии объёмом 800К токенов оплачивается заново целиком, токен за токеном: лимитом подписки или деньгами по API.
How Claude Code uses prompt caching – Как Claude Code кэширует промпты и сколько живёт кэш
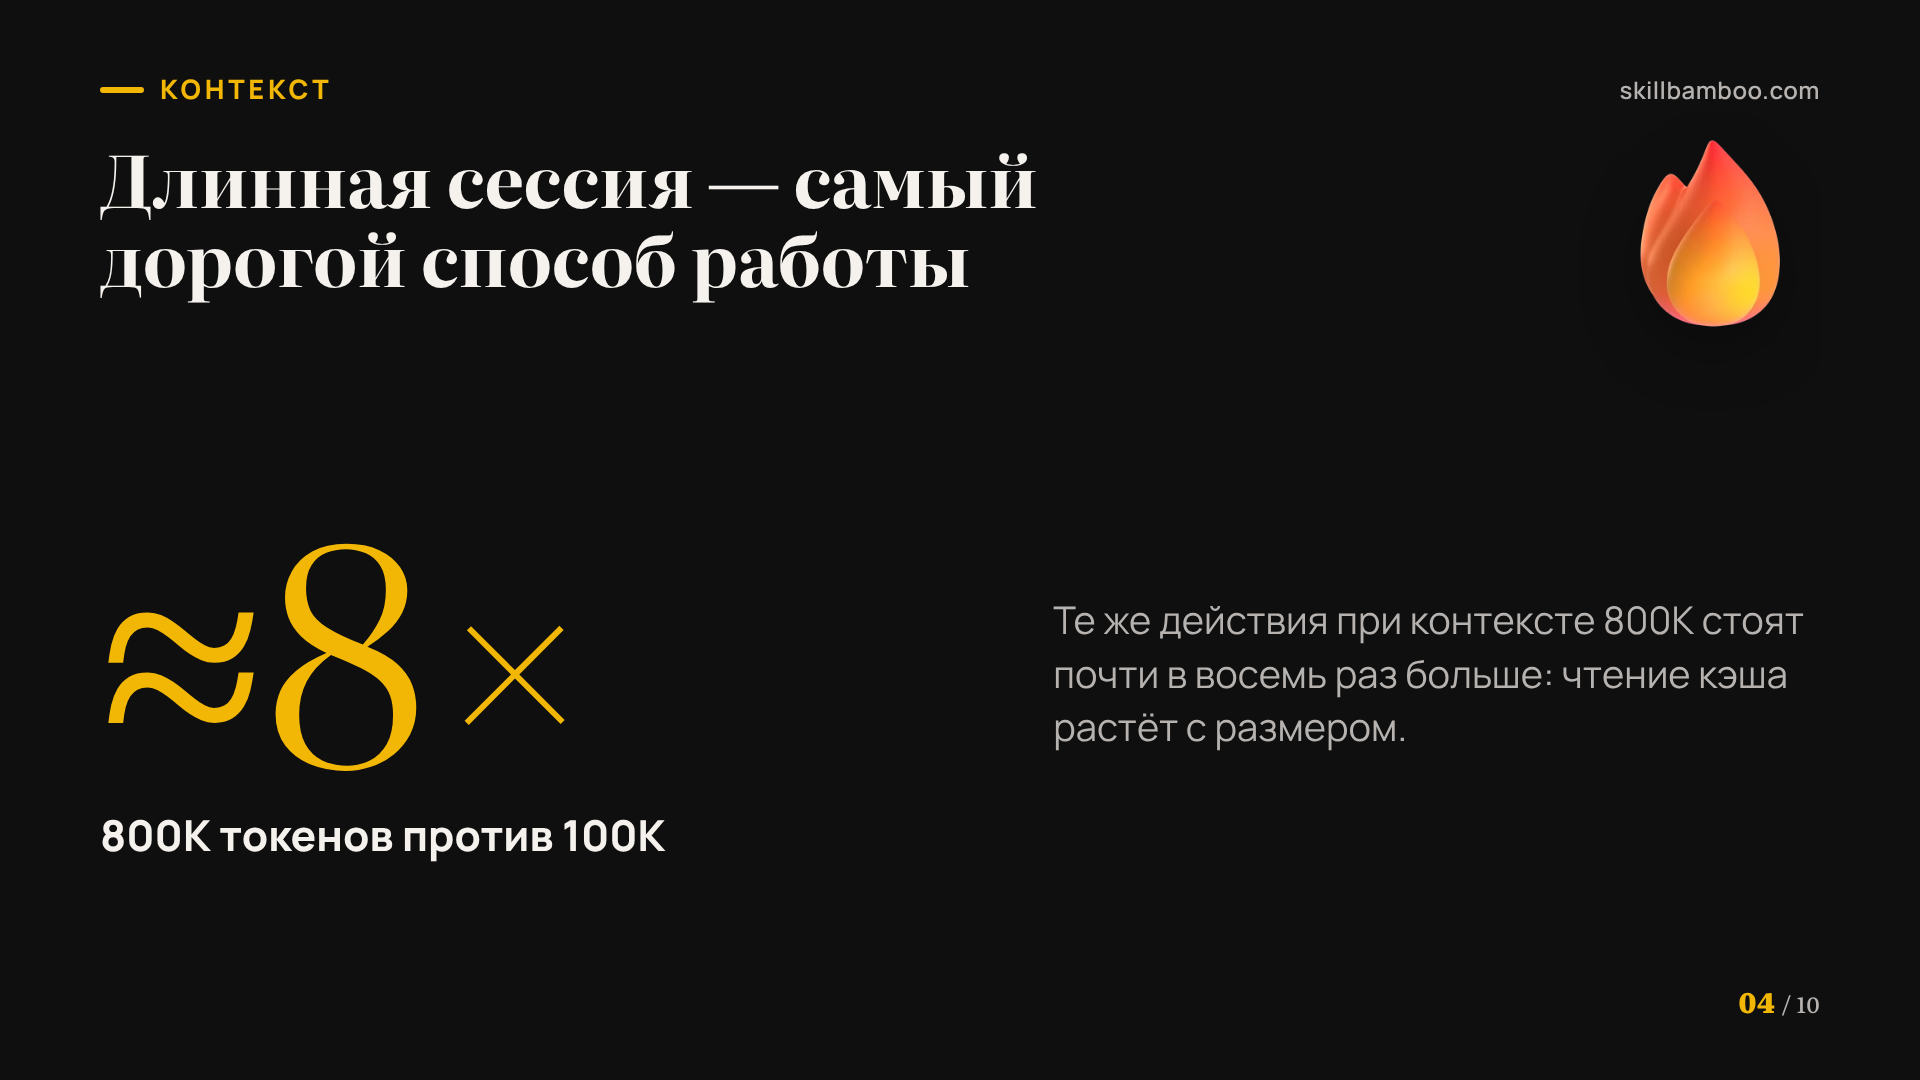
Даже живой кэш читается не бесплатно, и стоимость растёт вместе с размером контекста. Одни и те же действия при контексте в 800К токенов стоят почти в восемь раз больше, чем при 100К. Длинная сессия, в которую неделями «докидываются» задачи, оказывается самым дорогим способом работы.
Третья утечка: служебные файлы. Когда CLAUDE.md разрастается, каждый субагент читает его при старте. В одном проекте субагент съедал 150–200К токенов ещё до того, как приступал к делу (просто чтобы сориентироваться).
Возврат в старую сессию
Отошли больше чем на час, а контекст огромный? Следующий запрос может обнулить экономию за весь день. Новую задачу надёжнее начинать в новой сессии.
Как растянуть подписку: модели по задачам и короткий контекст
Хорошая новость: почти всё, что сжигает лимит, настраивается. Переходить на дорогой тариф не нужно: достаточно распределить задачи между моделями и держать контекст под контролем.
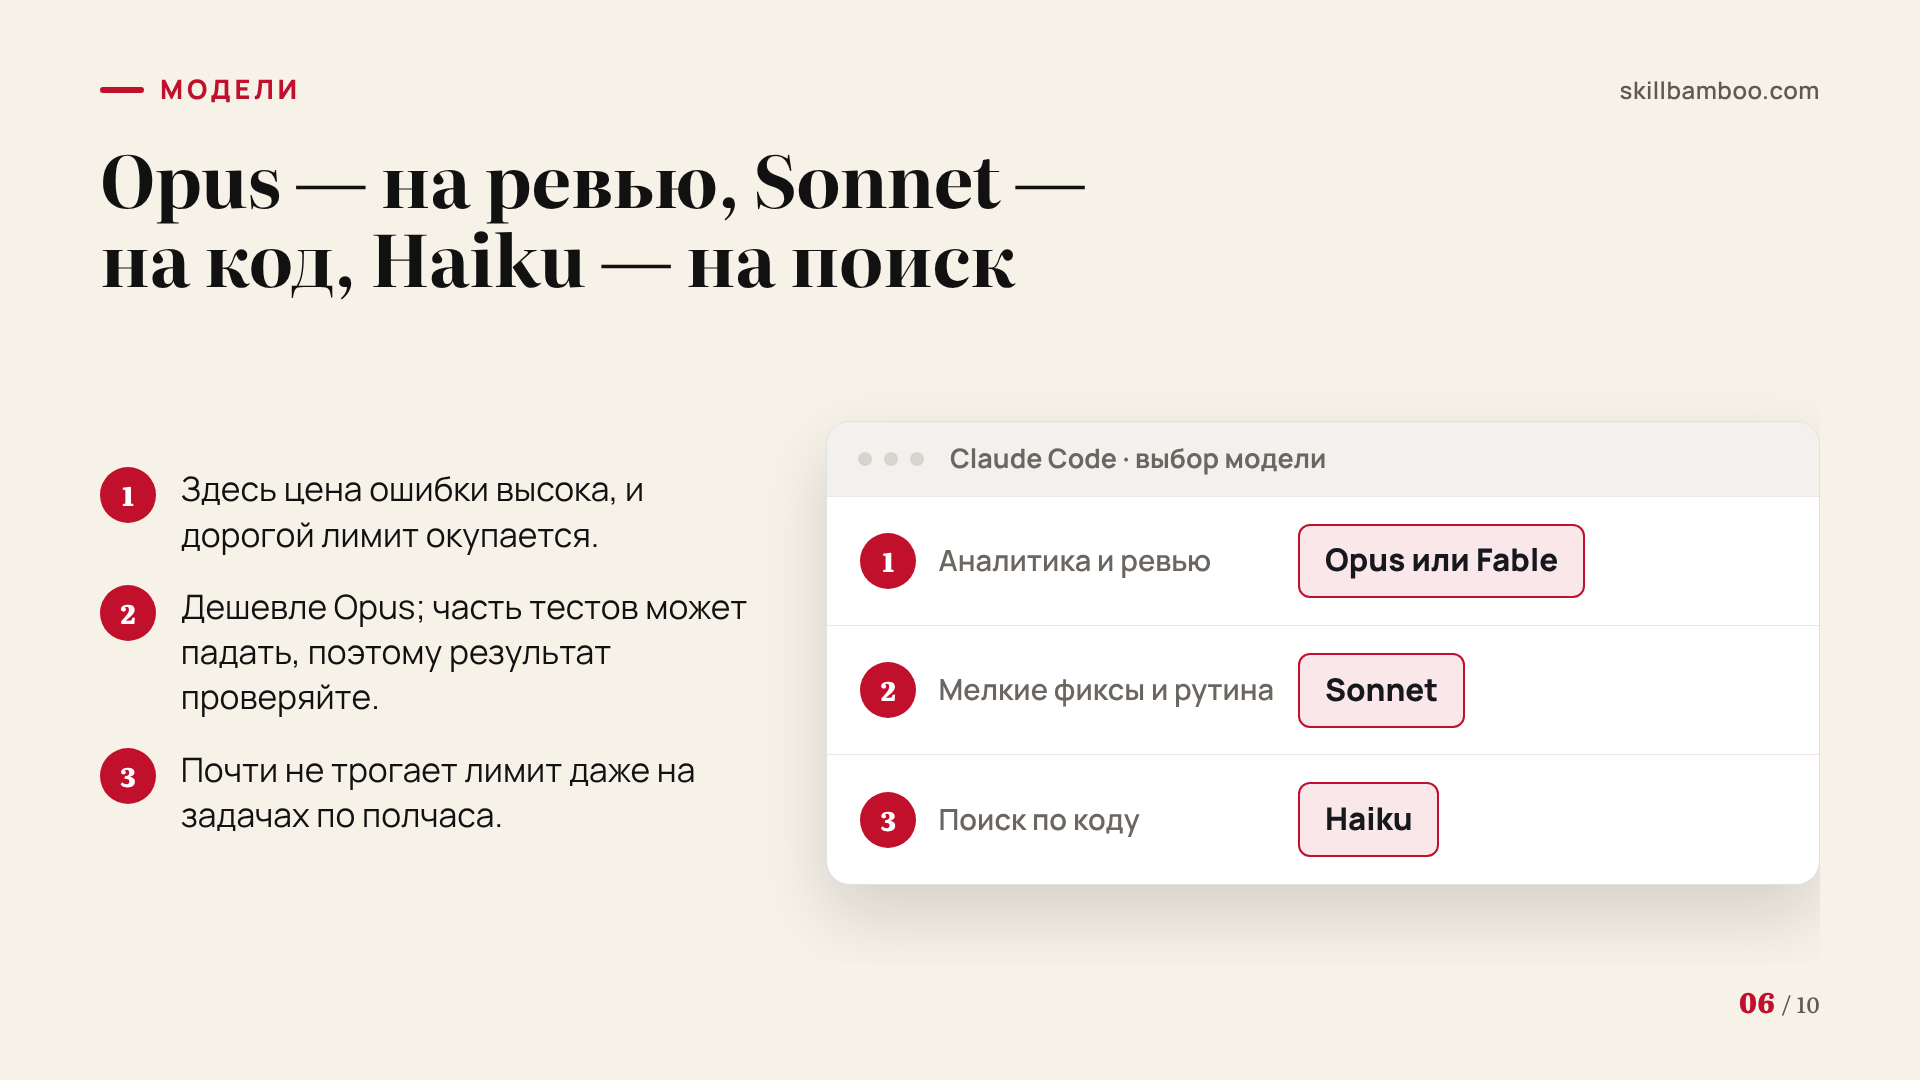
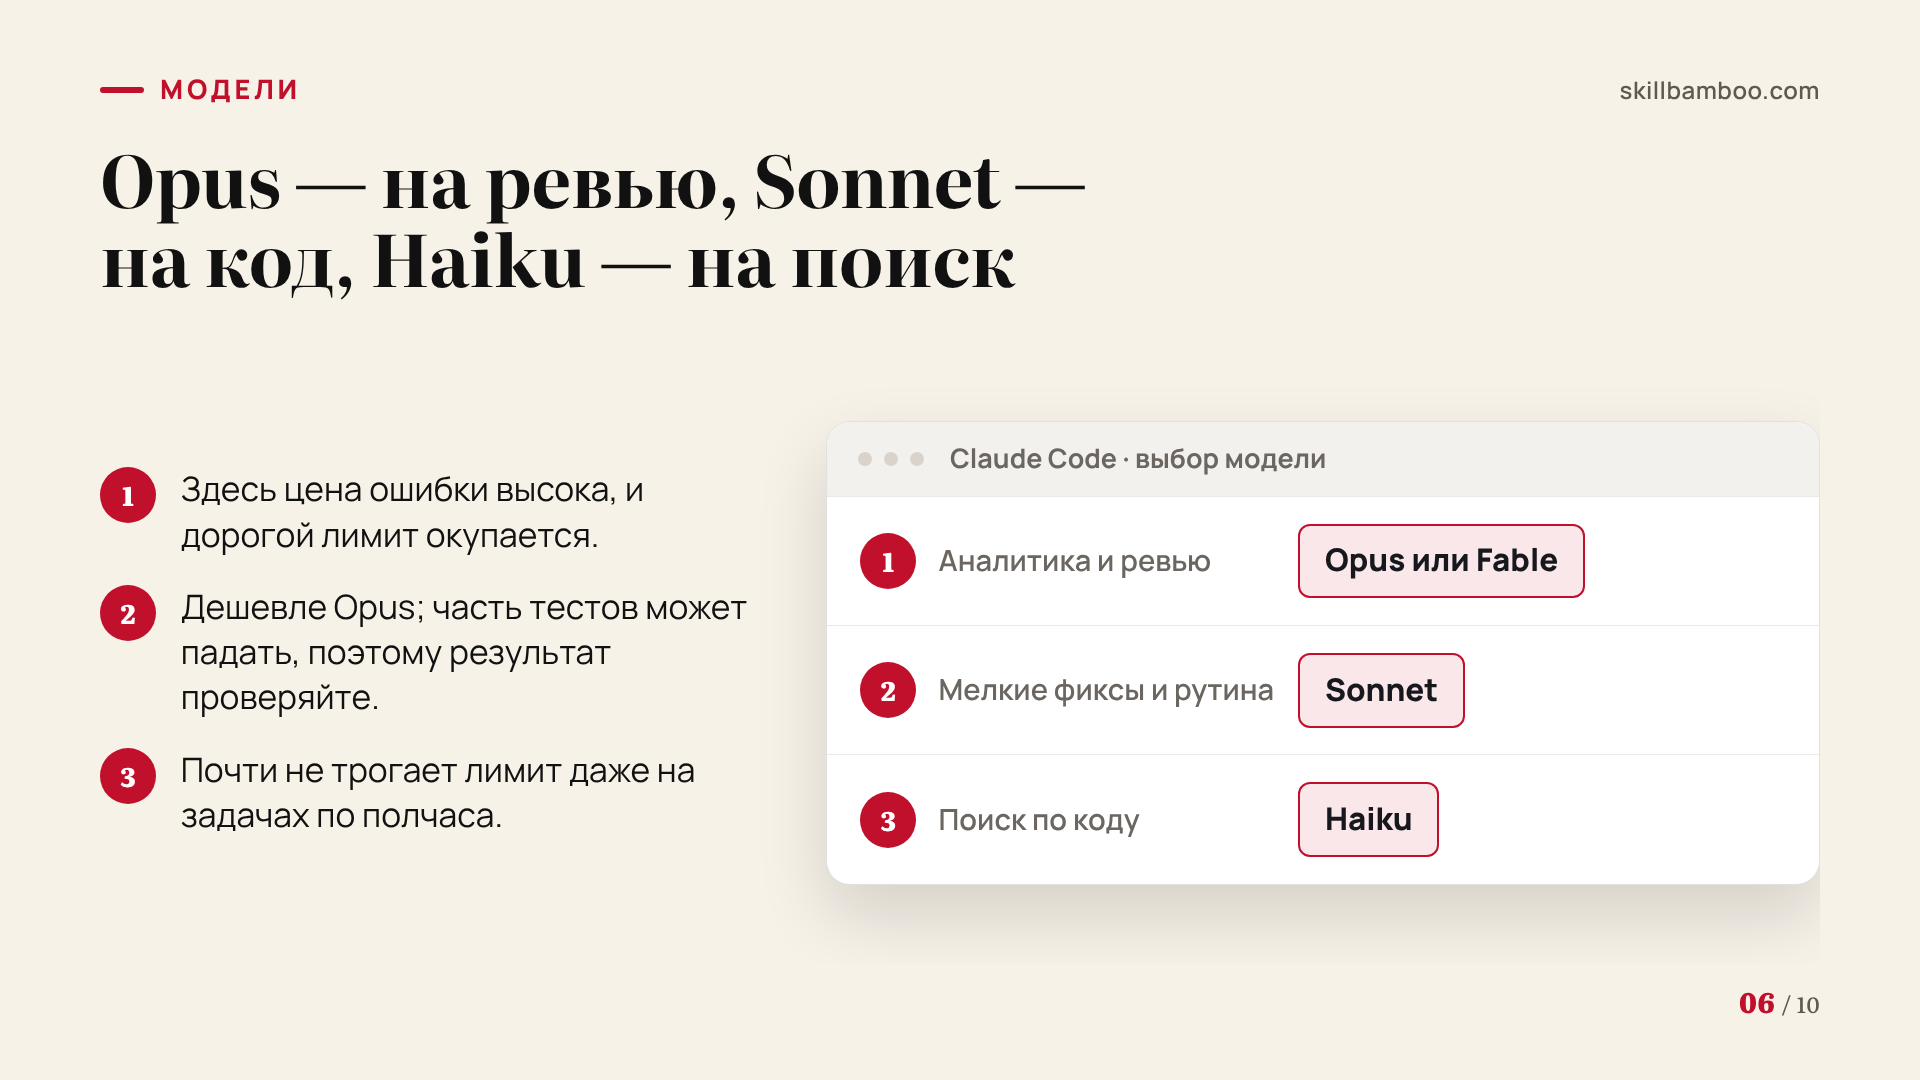
Первое и самое полезное: не гонять всё через топовую модель. Opus или Fable оставьте для того, где цена ошибки высока: аналитики и ревью. Мелкие фиксы и рутинную разработку отдайте Sonnet, а поиск по коду Haiku. Так дорогой лимит тратится там, где он действительно окупается.
Второе: размер контекста. Раз огромный контекст делает каждое действие почти в восемь раз дороже, короткие сессии под одну задачу экономят больше любой другой настройки.
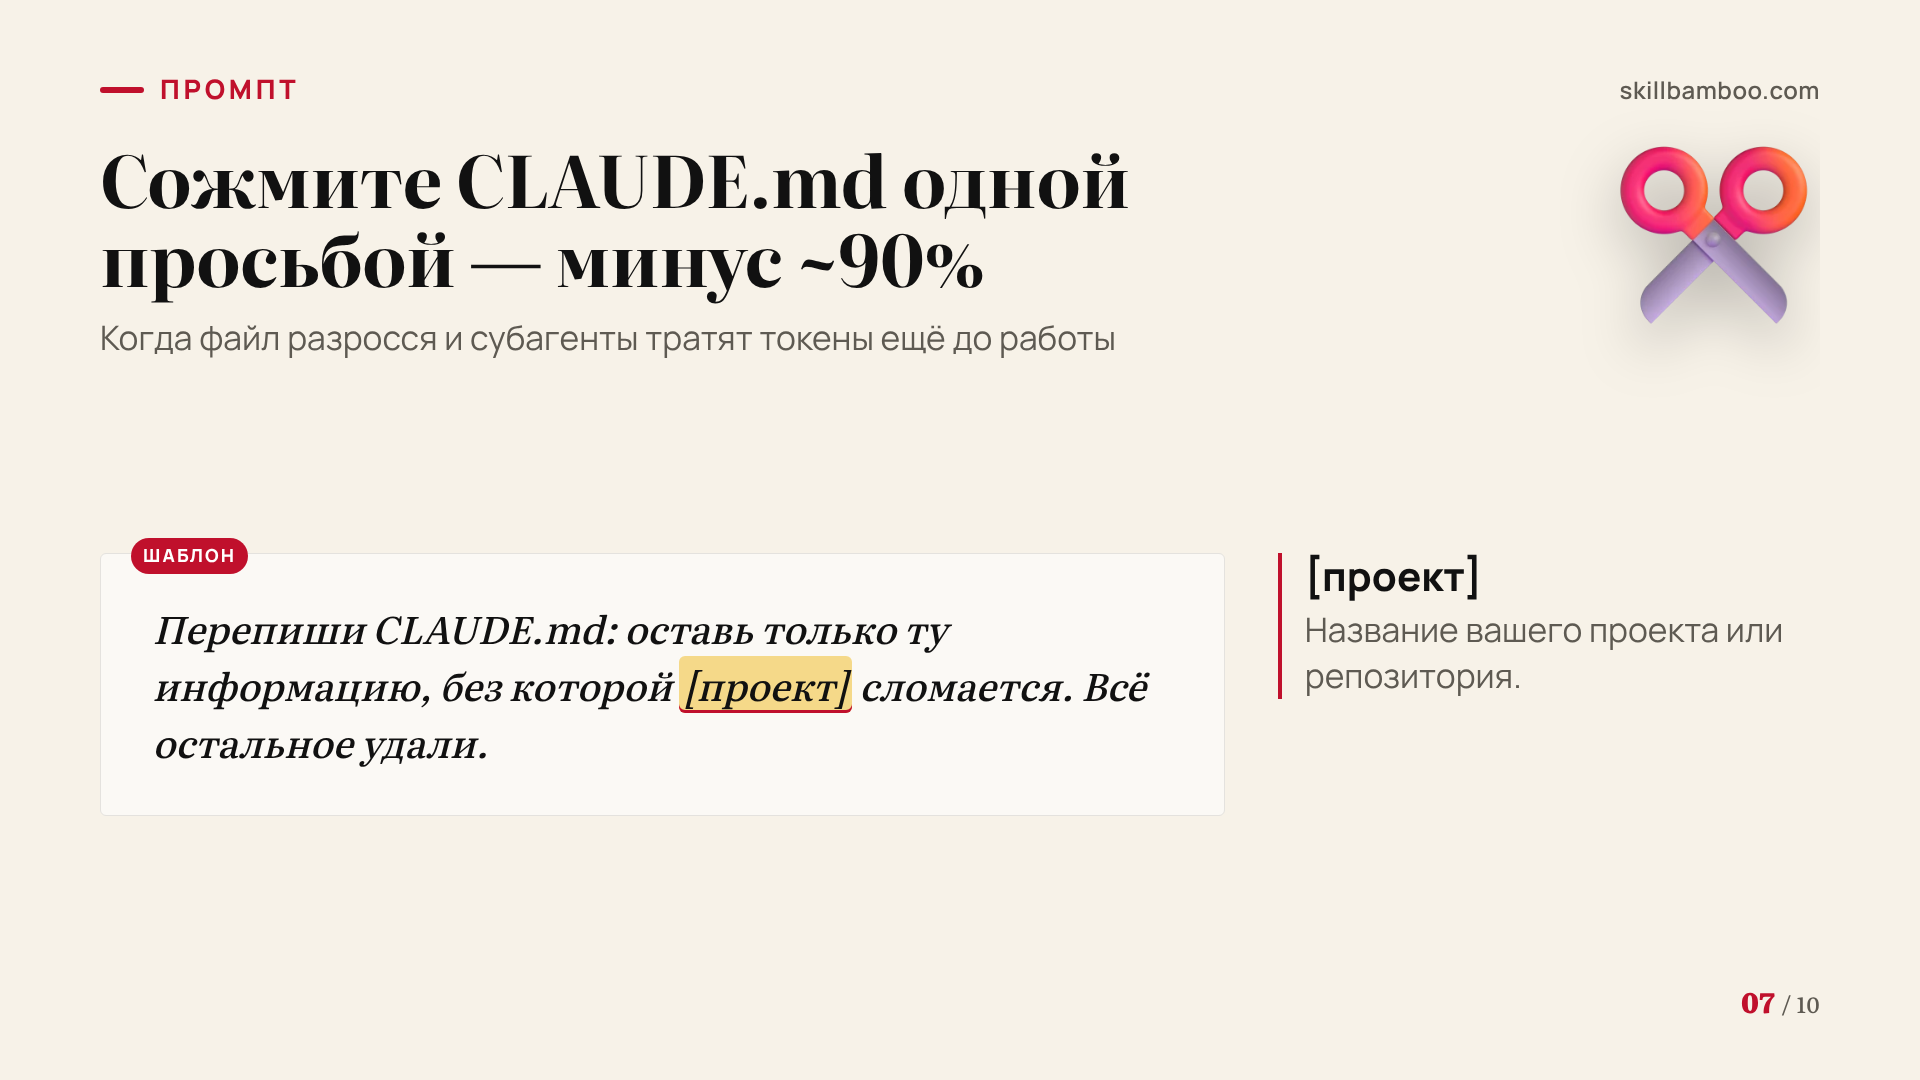
Третье: служебные файлы. Попросите агента оставить в CLAUDE.md только то, без чего проект сломается. В одном случае такая чистка сжала файл примерно на 90% (зависит от того, насколько он запущен), и каждый новый субагент стартует заметно дешевле. Мелочь, а приятно.
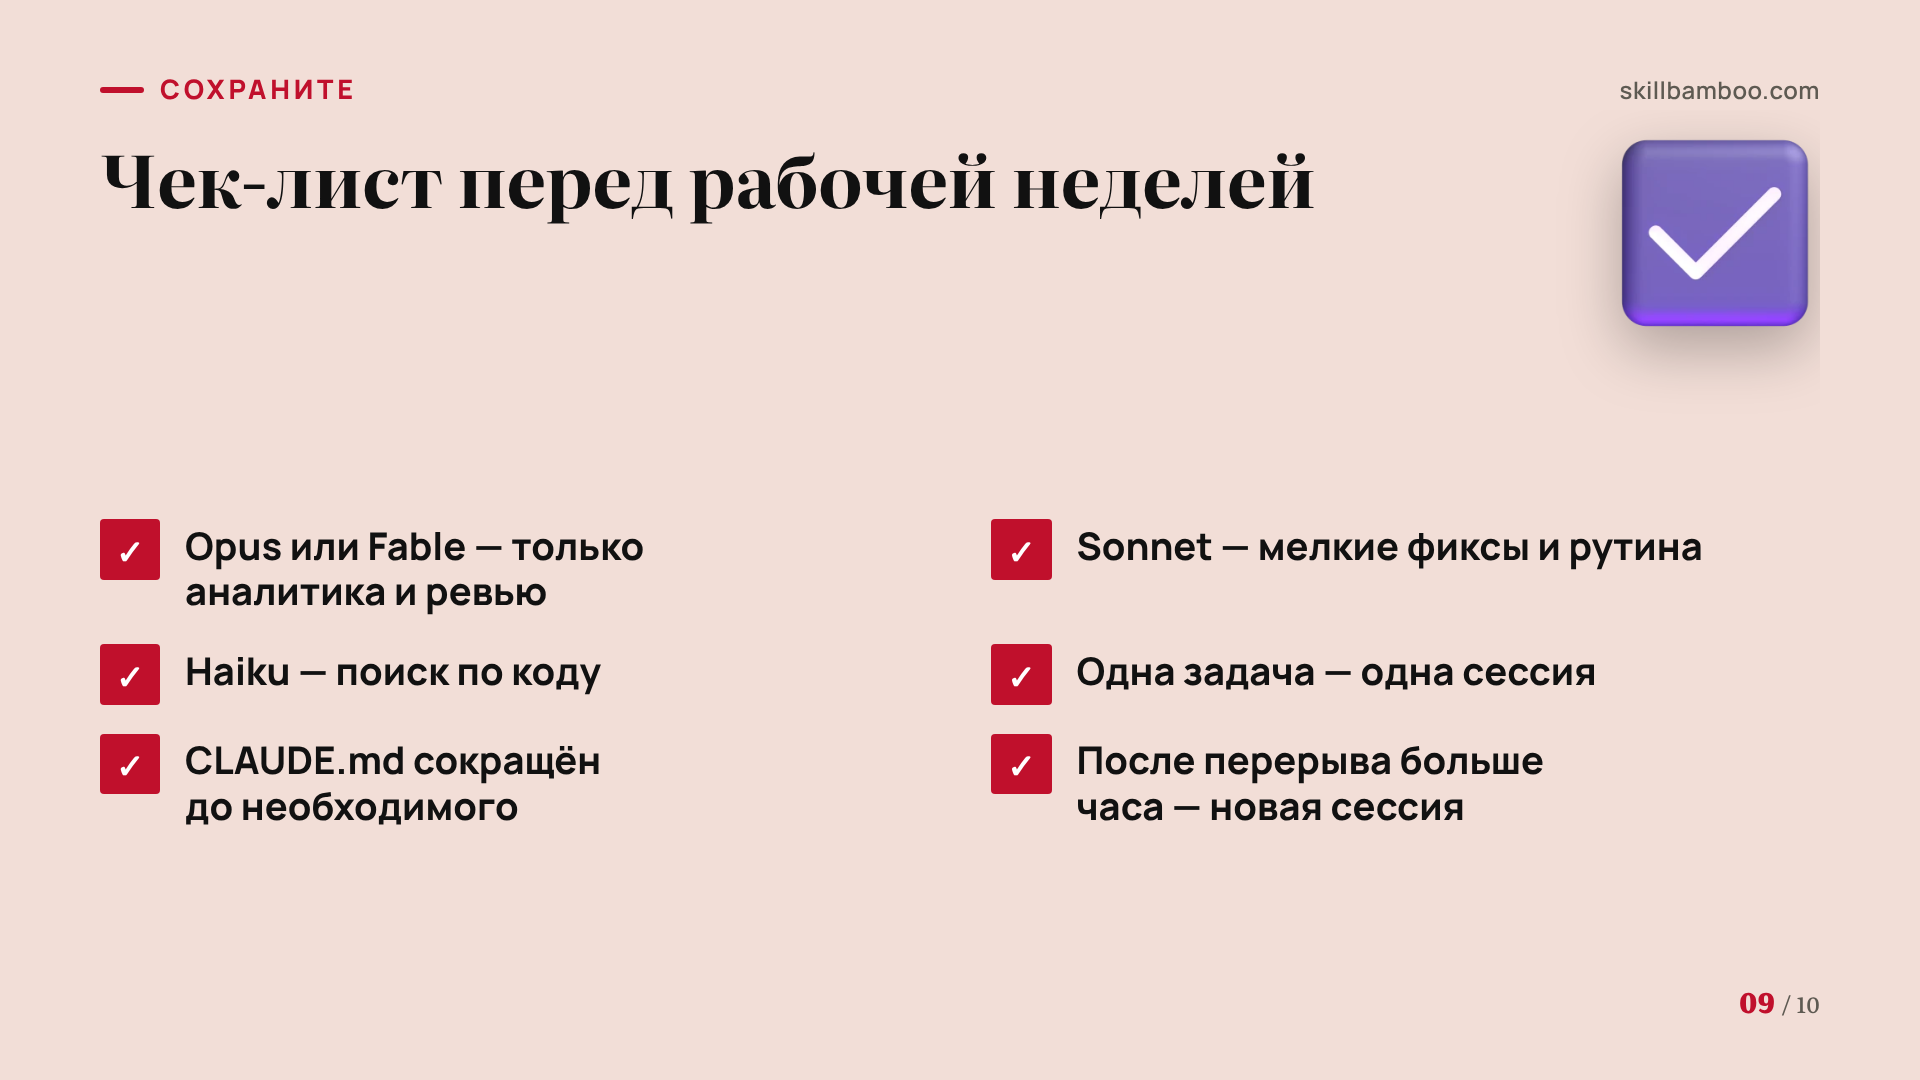
Короткий чек-лист перед следующей рабочей неделей:
- Opus или Fable: только на аналитику и ревью
- Sonnet: на мелкие фиксы и рутинную разработку
- Haiku: на поиск по коду
- Одна задача – одна сессия, без многочасовых «простыней» контекста
- CLAUDE.md сокращён до того, без чего проект не работает
- После перерыва больше часа – новая сессия, а не возврат в старую
Haiku и дешёвые модели: когда их хватает
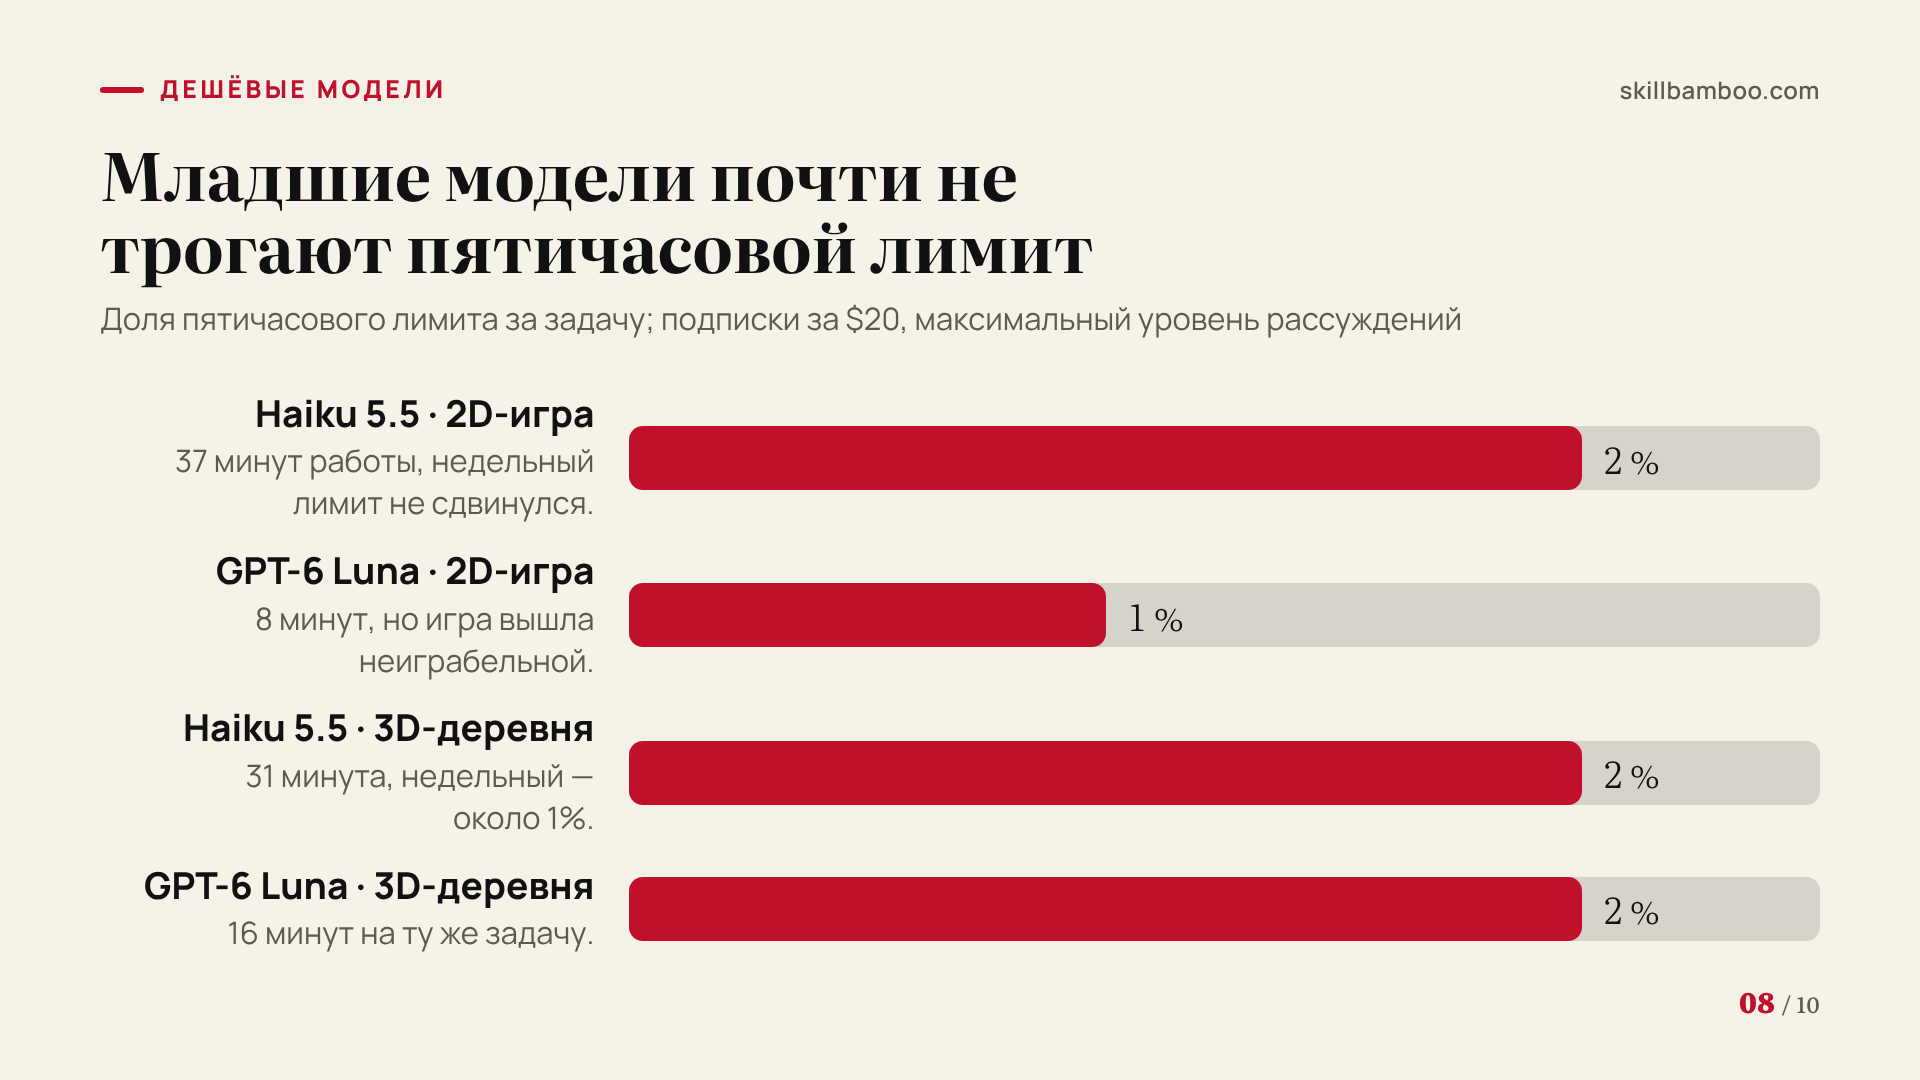
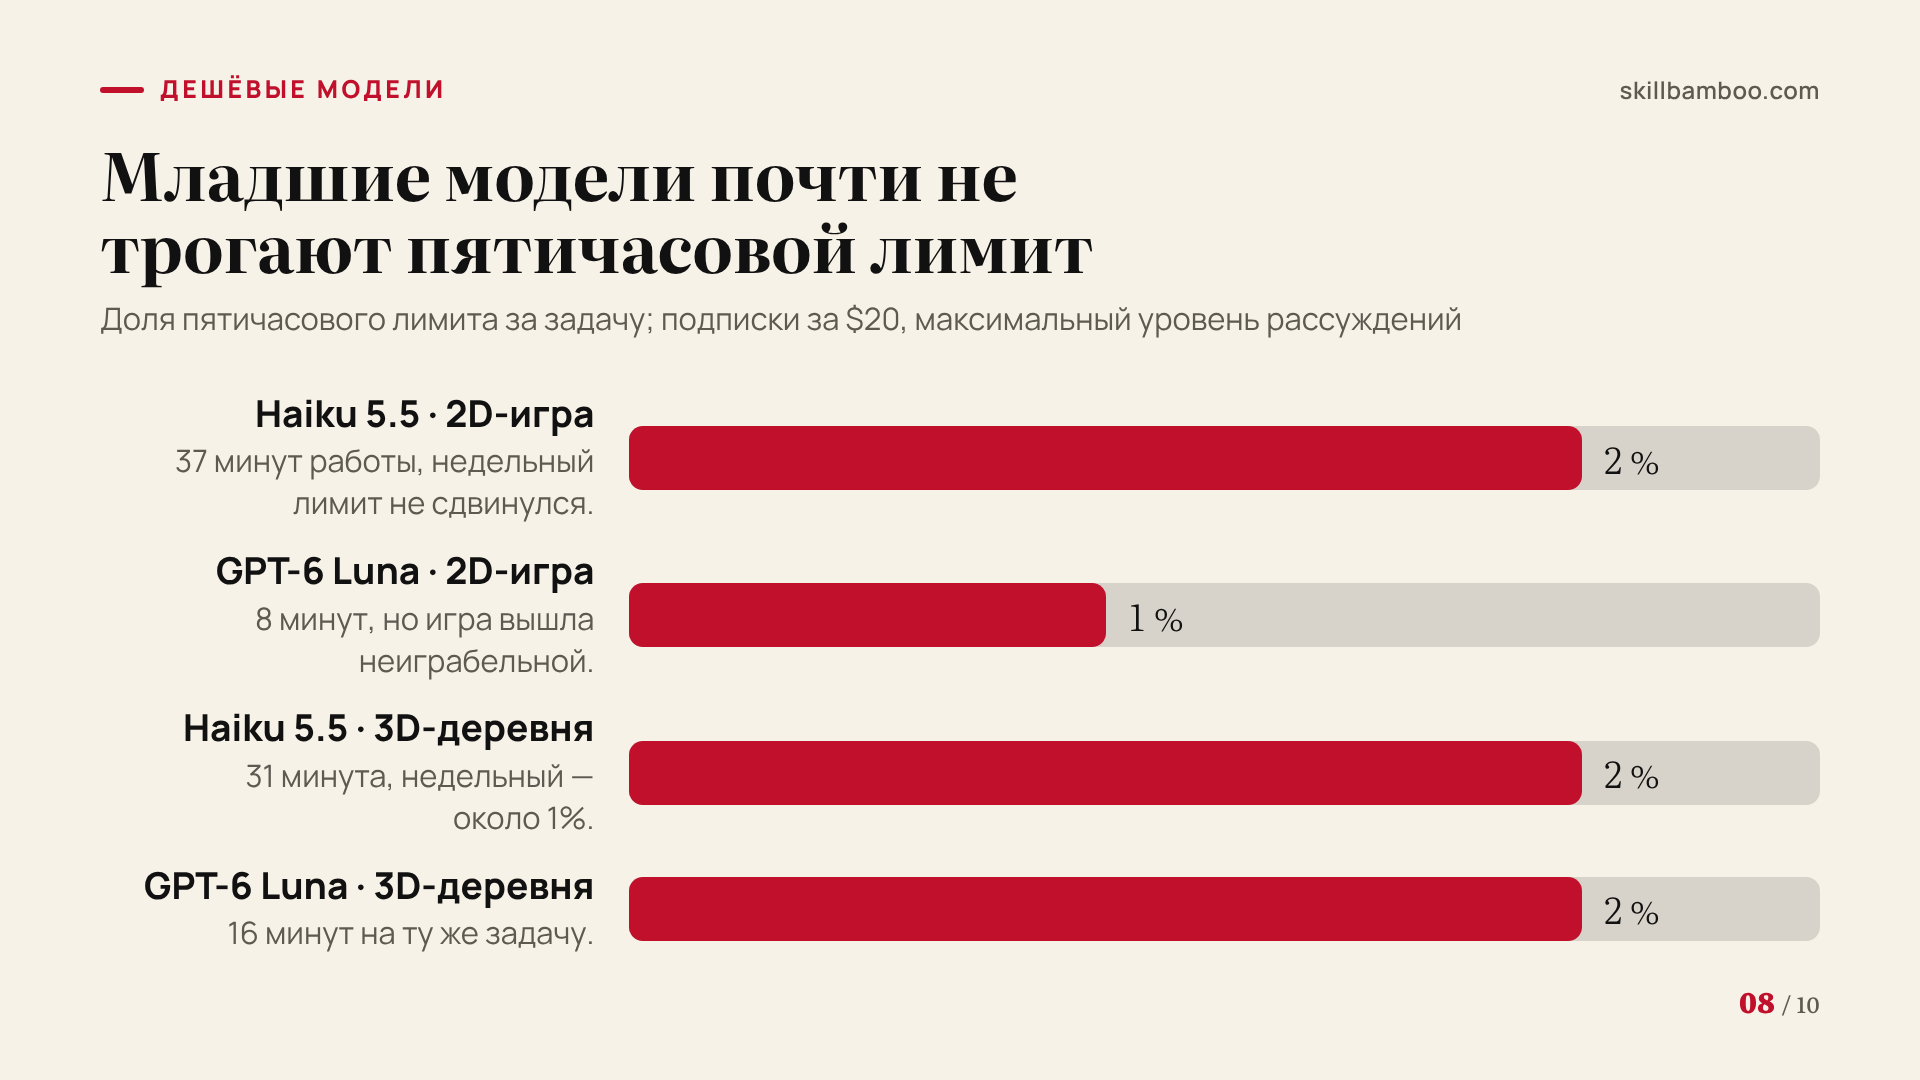
Дешёвая модель на подписке лимиты почти не трогает. Даже на задачах по полчаса. В другом тесте, тоже на подписках за $20, одни и те же задачи на максимальном уровне рассуждений делали младшие модели: Haiku 5.5 в Claude Code и GPT-6 Luna от OpenAI.
| Задача | Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| 2D-игра (файтинг) | 37 минут, 2% пятичасового лимита, недельный не сдвинулся | 8 минут, 1% пятичасового лимита, недельный не сдвинулся |
| 3D-симуляция деревни | 31 минута, около 2% пятичасового и 1% недельного лимита | 16 минут, 2% пятичасового лимита |
Luna быстрее, зато по качеству сильнее Haiku: он работал стабильнее, а игра у Luna вышла неиграбельной. С таблицей замера выше эти цифры не сравнить: задачи и тест другие. Вывод один: на прототипах, черновиках и учебных проектах с младшей моделью можно работать часами и не думать о счётчиках.
Правило выбора простое. Если результат вы всё равно будете проверять и дорабатывать (прототип, поиск, рутинный код), берите Haiku или Sonnet. А для глубокого анализа или проверки чужого кода, где ошибка дорого обойдётся, тратьте лимит на Opus.
Начинайте с дешёвой модели
Запускайте задачу на Haiku или Sonnet и переключайтесь на Opus, только когда результат не устраивает. Так основной лимит остаётся на действительно сложное.
Ключевые термины
- Пятичасовой лимит – Доля использования подписки, которая восстанавливается через пять часов после начала активной работы.
- Недельный лимит – Общий объём использования подписки на неделю, после исчерпания которого приходится ждать сброса.
- Кэш промпта – Сохранённый контекст сессии, повторное чтение которого дешевле, чем отправка всех токенов заново, но живёт ограниченное время.
- Компакт (compact) – Сжатие контекста сессии в краткий конспект, после которого агент продолжает работу с меньшим объёмом токенов.
- Субагент – Отдельный агент, которого главный агент запускает под узкую задачу со своим контекстом.
- Уровень усилий (effort) – Настройка глубины рассуждений модели – medium, high и выше – от которой зависят качество, время и расход.
- Оболочка (агент для кода) – Программа вроде Claude Code, Codex или Cursor, через которую модель работает с файлами и командами; расход лимита и качество задаёт модель внутри неё и её уровень рассуждений.
Итог: Claude Code или Codex – какой тариф за $20 выбрать
Если вы работаете плотными сессиями по несколько часов, Codex с GPT-6.1 Sol даст больше задач в пятичасовом окне, но каждая будет идти дольше. Если нагрузка распределена по неделе, связки Claude Code с Opus 5.5 и Codex с Sol за $20 на одинаковых задачах тратят недельный лимит одинаково, а независимая оценка и вовсе считает подписку Claude выгоднее. Решает не тариф, а то, какую модель вы ставите на задачу и как держите контекст.
Что делать дальше
Посмотрите, какой счётчик у вас заканчивается первым, перенесите рутину на Sonnet и Haiku, оставьте Opus для аналитики и ревью и дробите работу на короткие сессии. Подписки сравнивайте связками: продукт, модель, уровень. Если выбираете Claude и находитесь в России, начните с аккаунта и оплаты: пошагово в курсе по подписке на Claude.ai.
Проверьте себя
1. Вы работаете короткими, но очень плотными сессиями по 2–3 часа подряд. На какой лимит Claude Code на Opus вы, скорее всего, наткнётесь первым?
- А. На месячный
- Б. На пятичасовой
- В. На недельный
Показать ответ
Ответ: Б. Opus быстро выедает пятичасовое окно, хотя недельный лимит тратит умеренно.
2. Агент работает в сессии на 800К токенов, а субагенты ушли в задачи больше чем на час. Что произойдёт с расходом?
- А. Расход упадёт, потому что агент простаивает
- Б. Ничего: кэш хранится всю сессию
- В. Кэш главного агента протухнет, и следующий запрос заново оплатит весь контекст
Показать ответ
Ответ: В. На подписке кэш главного агента живёт 1 час между запросами; промах на большом контексте оплачивается каждым токеном.
3. Какое распределение моделей по задачам экономит лимит без потери качества там, где оно критично?
- А. Opus на всё, чтобы не было ошибок
- Б. Haiku на ревью, Opus на поиск по коду
- В. Haiku на поиск, Sonnet на разработку и мелкие фиксы, Opus на аналитику и ревью
Показать ответ
Ответ: В. Дорогая модель работает только там, где её качество окупается, а рутина уходит дешёвым.
4. Почему одни и те же действия в длинной сессии обходятся дороже, чем в короткой?
- А. Длинные сессии тарифицируются по отдельной ставке
- Б. Каждый вызов инструмента перечитывает кэш всего контекста, и цена растёт с его размером
- В. Модель устаёт и думает дольше
Показать ответ
Ответ: Б. Чтение кэша пропорционально контексту: на 800К примерно в 8 раз дороже, чем на 100К.
5. Знакомый пишет: «Codex тратит лимит бережнее Claude Code». Чего не хватает этому выводу?
- А. Ничего: подписки сравнивают целиком
- Б. Модели и уровня рассуждений у каждой стороны
- В. Цены тарифа в рублях
Показать ответ
Ответ: Б. Claude Code и Codex – оболочки, расход задаёт модель внутри: у Opus и Sonnet, у Sol и Astra он разный. Сравнивают связки «продукт · модель · уровень».
6. Один замер показывает, что тарифы Claude и Codex за $20 равны по недельному расходу, другой – что Claude выгоднее. Как поступить?
- А. Проверить расход на своих задачах: любой бенчмарк зависит от промптов и проектов
- Б. Выбрать тариф подешевле – они всё равно одинаковые
- В. Поверить замеру с большим числом тестов
Показать ответ
Ответ: А. Результат сильно зависит от типа задач, длины сессий и кэширования.