SkillBamboo
Сидеть над агентом Claude Code и каждые несколько минут подтверждать его следующий шаг мне в какой-то момент стало откровенно лень, и захотелось простого (как мне тогда казалось) счастья. Дать задачу на весь вечер, уйти по своим делам и вернуться уже к готовой фиче. На деле агент то замирал и терпеливо ждал моего «continue», то бодро докладывал, что всё готово, хотя к приложению фичу так и не подключил.
Я полез разбираться, почему так выходит, и довольно быстро выяснил, что длинный CLAUDE.md и «think hard» в промпте тут почти не помогают. Долгая работа держится на цикле вокруг агента и на проверках, которые он не может подкрутить под себя. Покажу, как собрать такой цикл, чтобы Claude Code часами строил фичи сам, и что проверить, прежде чем оставить его на ночь.
Почему долгая работа агента Claude Code держится на цикле, а не на промпте
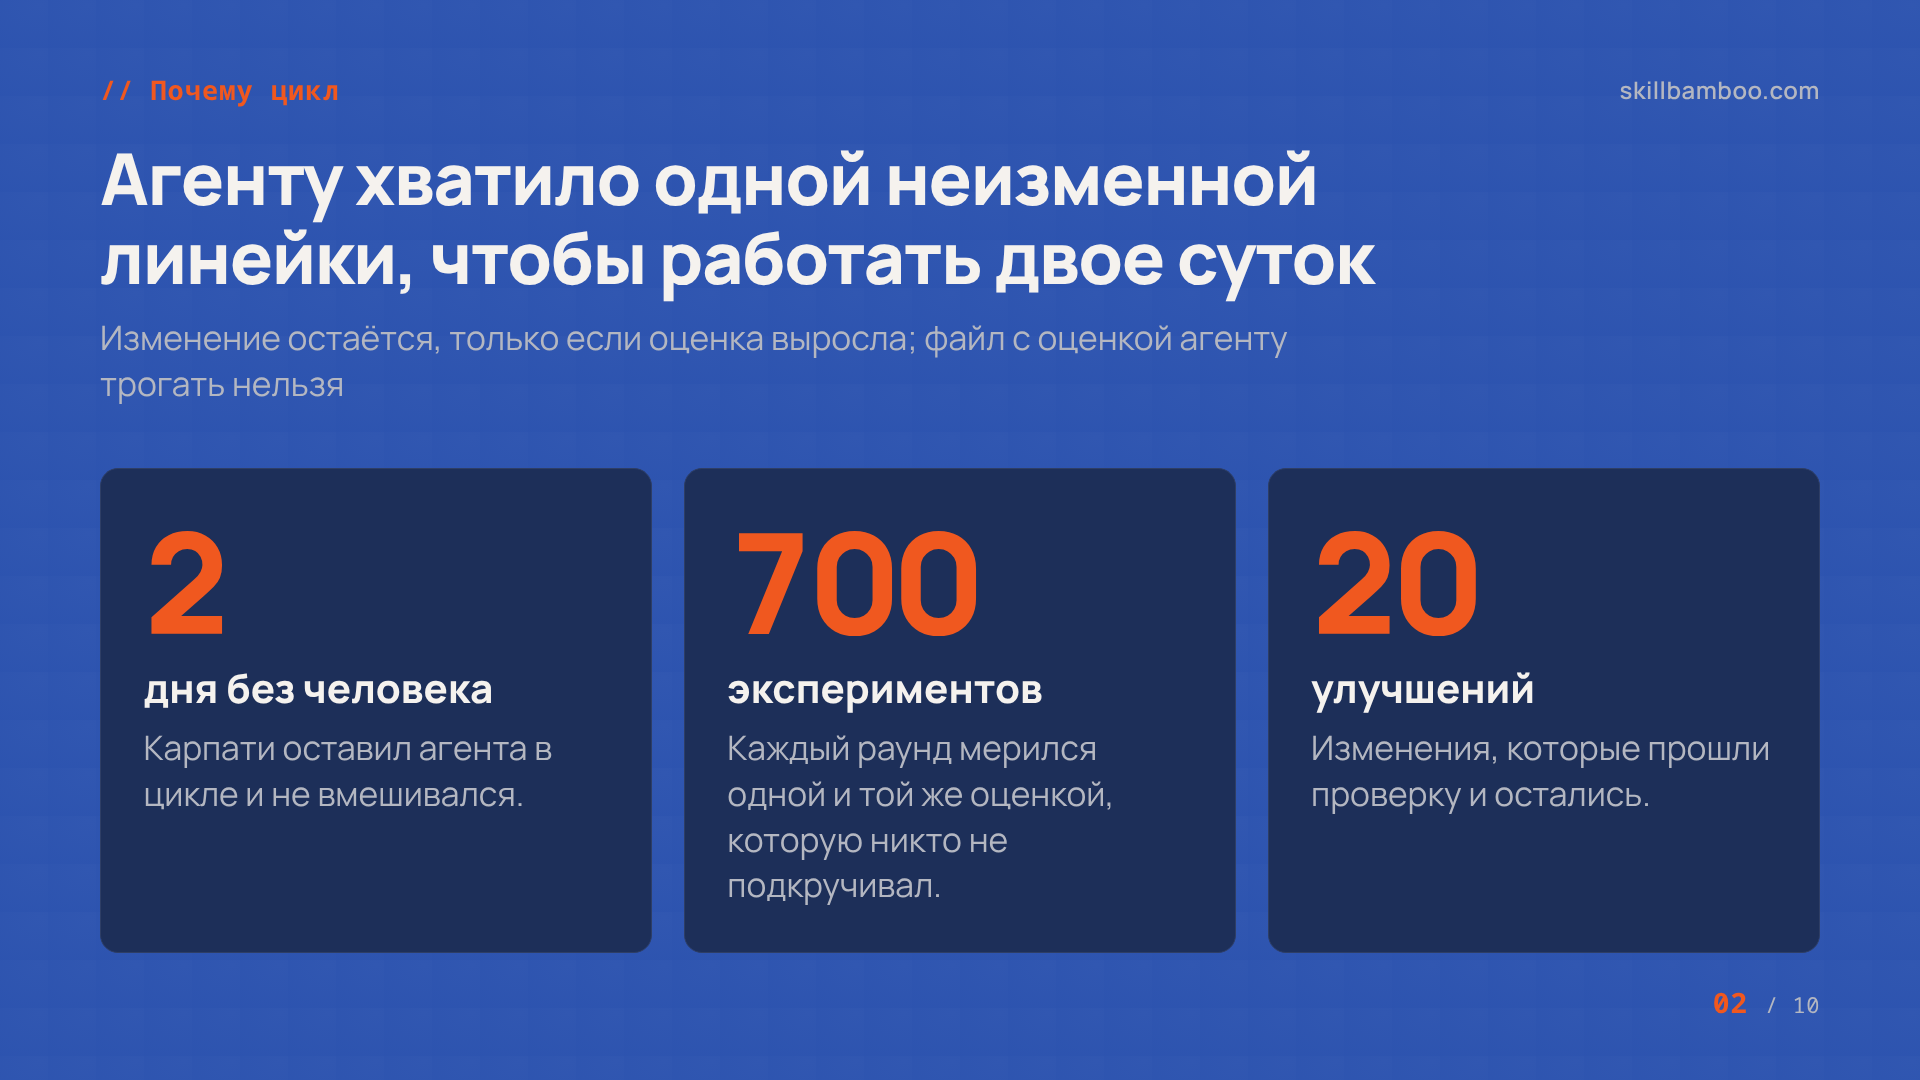
Механика у Карпати простая – агент делает одно изменение, отдельная проверка ставит оценку. Если оценка выросла, изменение остаётся. Если не изменилась или упала, то откат, и поехал следующий раунд.
Главное правило: файл с оценкой агенту трогать нельзя. Если разрешить, он найдёт самый короткий путь: упростит оценку вместо того, чтобы улучшить результат. Те самые 700 экспериментов за два дня без человека набрались именно так: каждый раунд мерился одной и той же линейкой, которую никто не подкручивал.
Параллельно поменялось отношение к инструкциям. Инженеры Anthropic вырезали больше 80% системного промпта Claude Code для моделей Opus 5 и Fable 5 и не увидели измеримых потерь на своих тестах. Большая часть старых правил чинила ошибки прежних моделей, которые новые уже не делают.
The new rules of context engineering for Claude 5 generation models – Новые правила контекст-инжиниринга для моделей Claude 5
То есть длинные инструкции структуру не заменят. Автономность дают проверка, которой агент не может подыграть, и порядок, в котором он работает. Остальное дают короткая постановка и минимум контекста.
Когда цикл окупается
Цикл не волшебная кнопка для всего подряд. Прежде чем его строить, проверьте два главных условия:
- Результат можно проверить чем-то, что выдаёт чёткую оценку. В приложении это небольшие тесты, которые пробуют фичу и подтверждают, что она работает.
- Работа делится на фичи, и в цикл уходит одна фича за раз. Целое приложение одним циклом не строят.
Если нет оценки, агенту не с чем сверяться, и судить о результате он будет сам (угадайте, в чью пользу). Если отдали в цикл всё приложение, ошибка одной части утонет в остальном коде. Ещё два условия: задача повторяется часто (для разовой хватит одного хорошего промпта), и лимит тарифа выдержит цикл, т.к. токены уходят даже на неудачные раунды и долгий цикл на тарифе за $20 упирается в лимит раньше, чем закончится работа.
Не знаю как у вас, но держать долгий цикл на ноутбуке, который вечером захлопнется, достаточно неудобно. Удобнее на сервере – вот как поставить Claude Code на VPS и не терять сессии.
Шаг 1. Постановка: задача, ограничения, критерий готовности
Долгое время совет номер один звучал так: начинайте с plan mode. В конце сентября 2026 года создатель Claude Code Борис Черни написал, что plan mode больше не нужен.
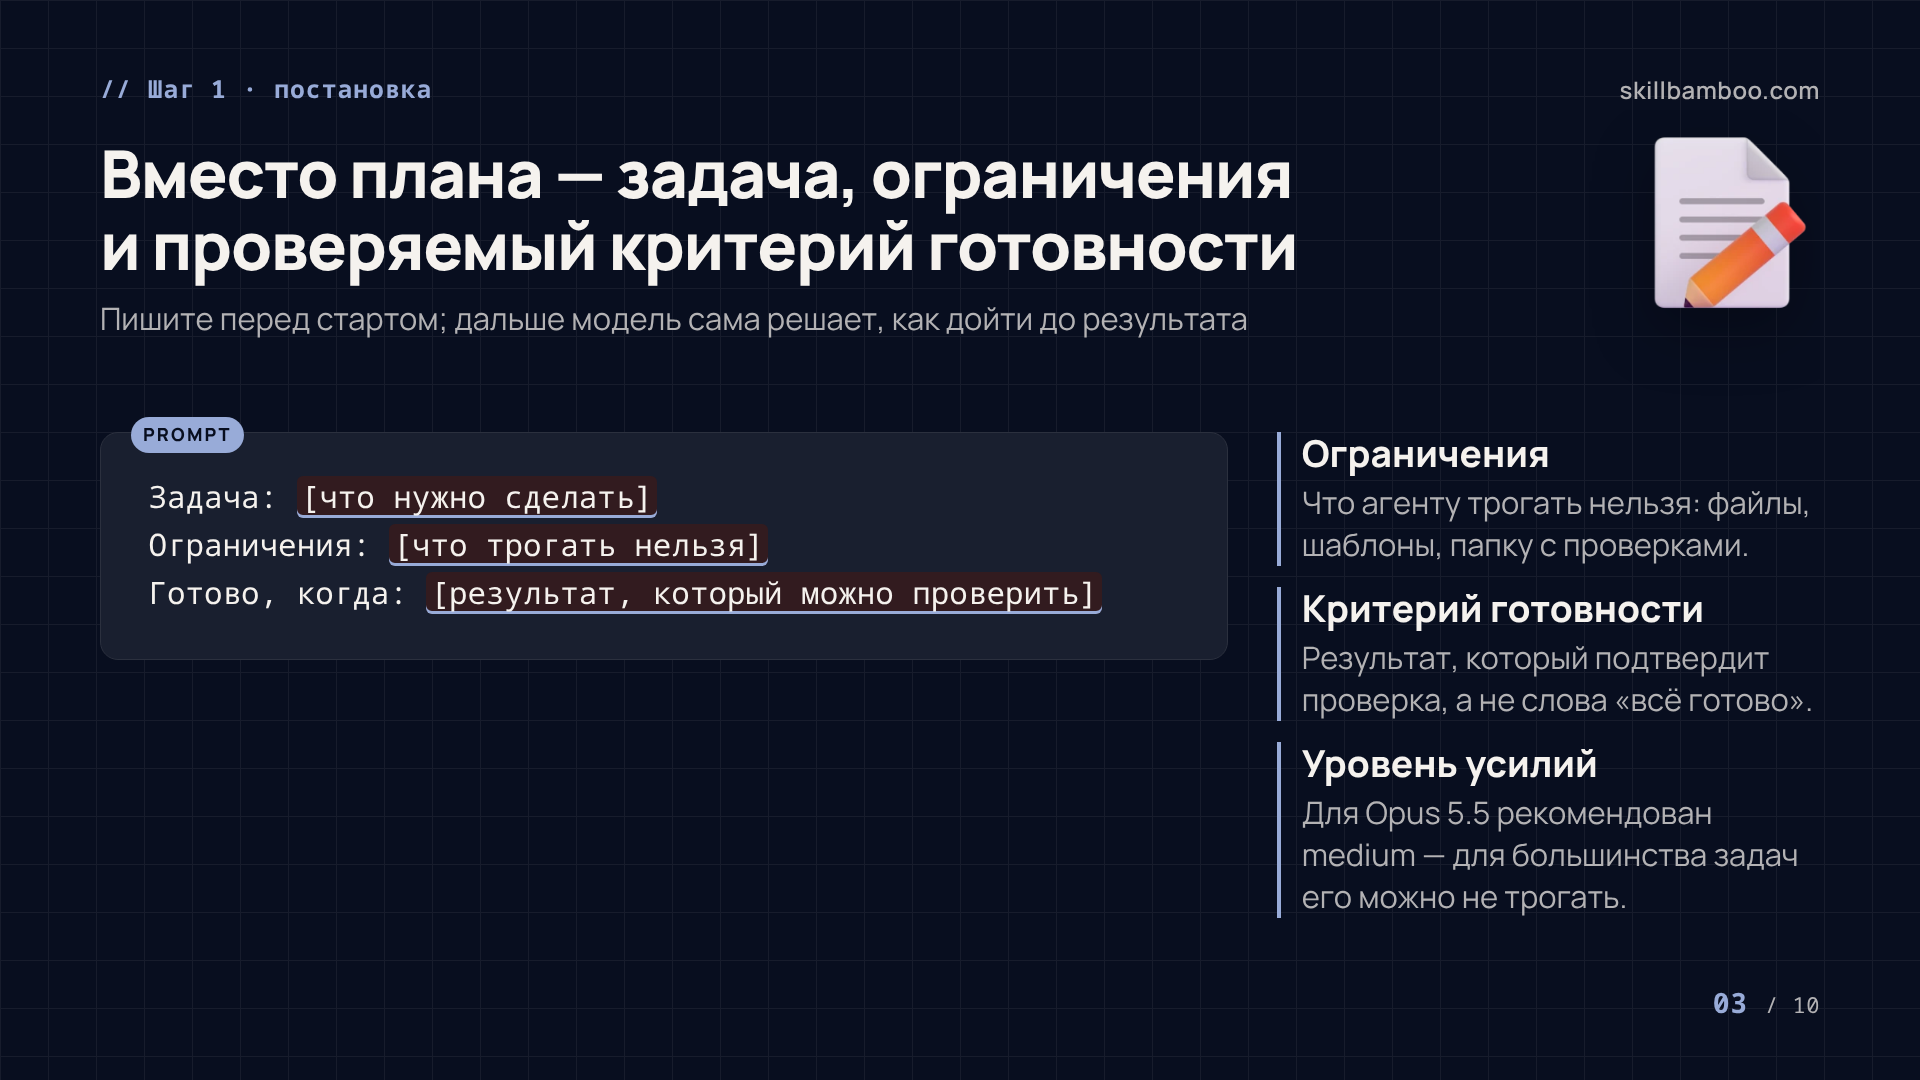
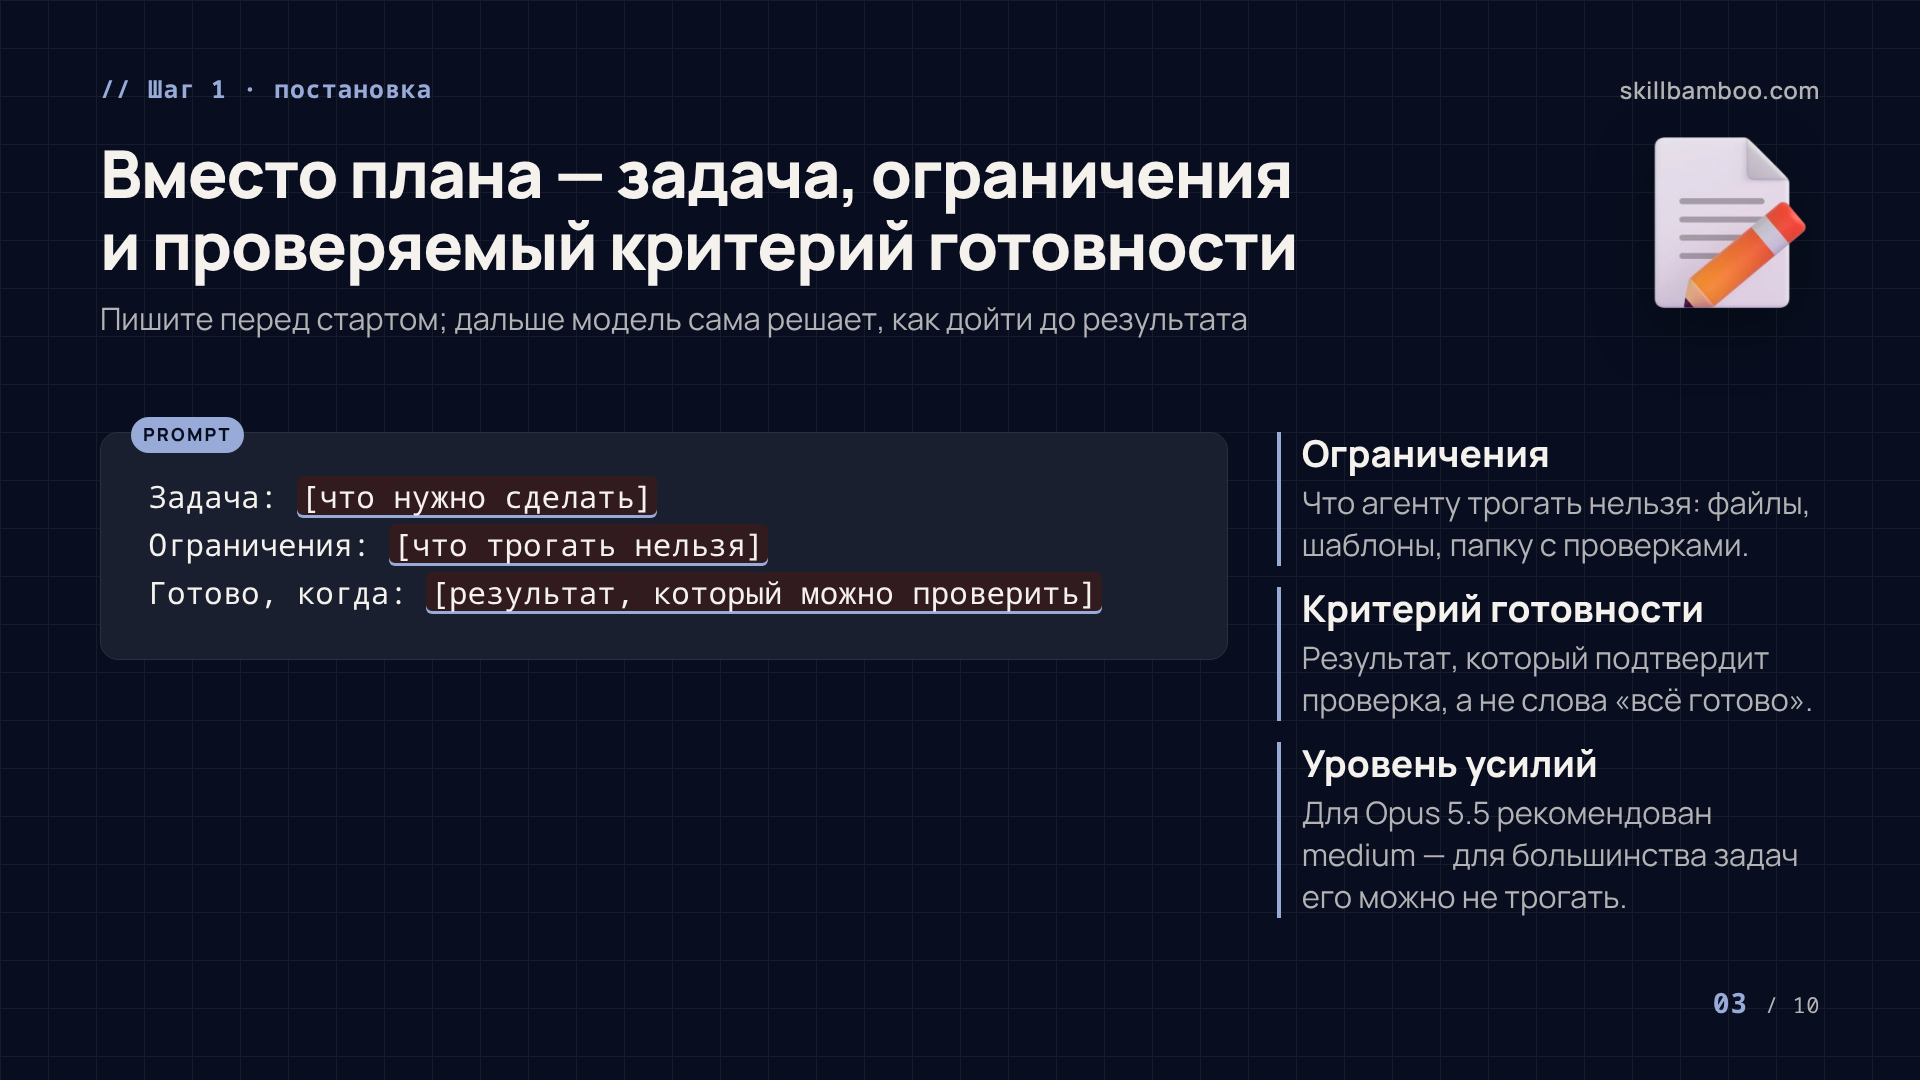
Вместо плана нужна постановка из трёх частей:
- Задача – что нужно сделать.
- Ограничения – что трогать нельзя.
- Критерий готовности – как выглядит сделанная работа, причём проверяемо.
Дальше уже модель сама решает, как дойти до результата. Вы смотрите не план до старта, а итог после.
Второе, от чего пора отказаться: заклинания вроде «think hard». Claude Code теперь читает их как обычный текст промпта, глубину рассуждений они не меняют. За неё отвечает отдельная настройка (уровень усилий). Для Opus 5.5 рекомендован medium, и Anthropic утверждает, что на нём модель не уступает Opus 5 на high в коде и работе со знаниями. Для большинства задач эту настройку можно просто не трогать.
Шаг 2. Проверки до кода – и под замком
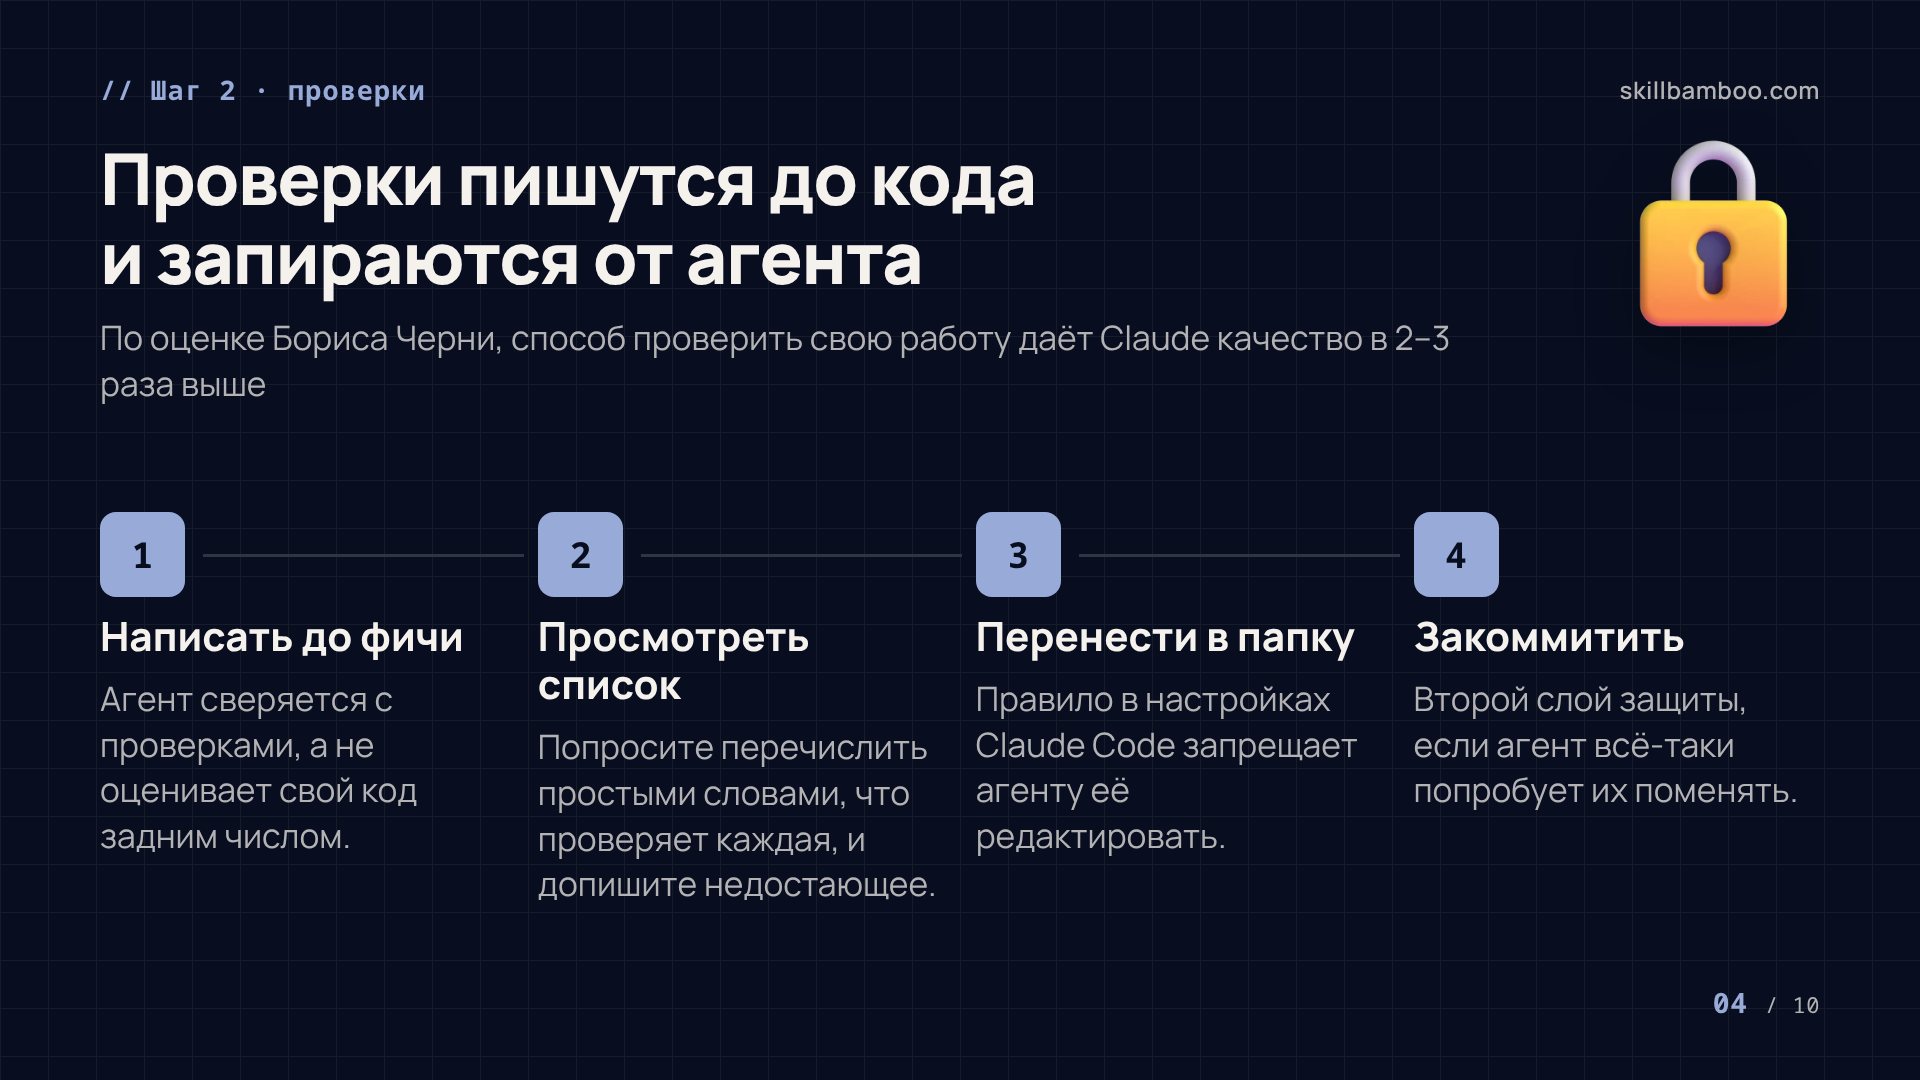
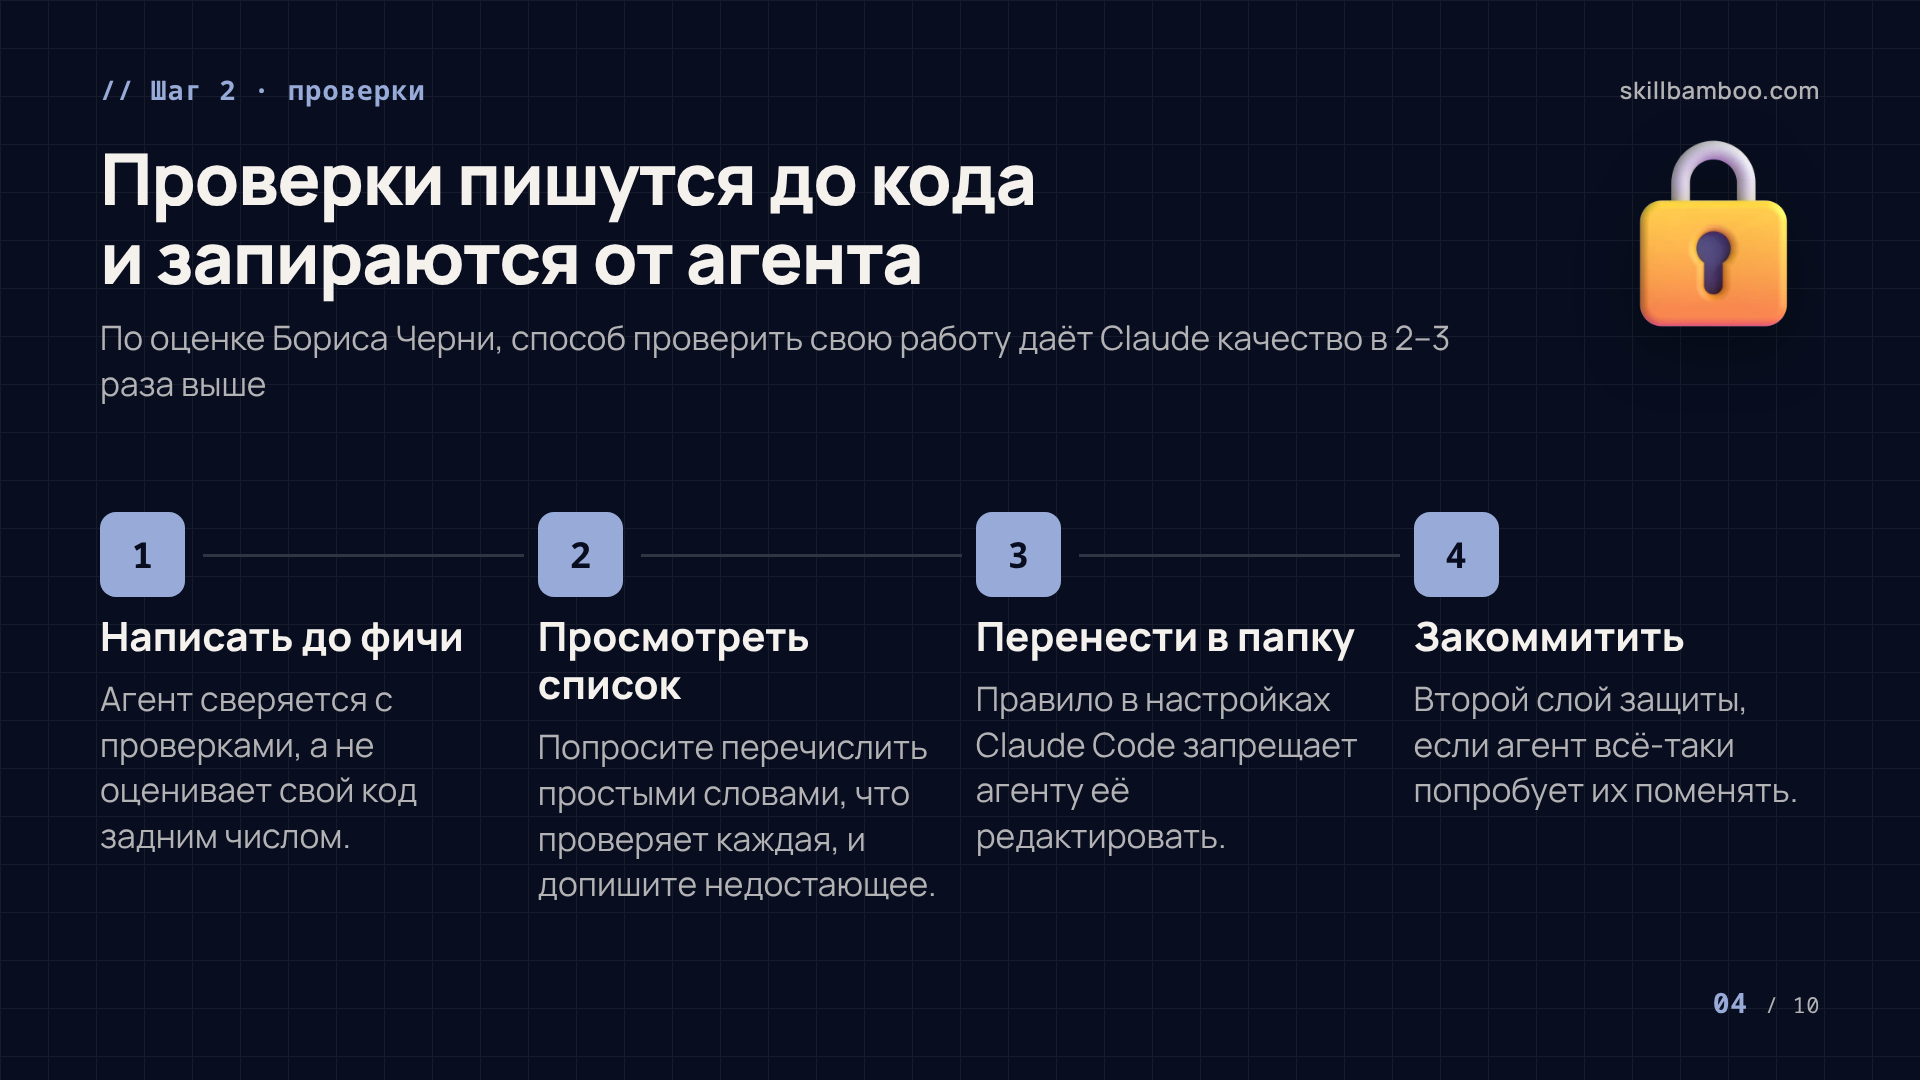
По оценке Бориса Черни, если дать Claude способ проверить свою работу, качество итогового результата вырастает в 2–3 раза. Поэтому проверки – центр всей схемы.
Порядок такой:
- Проверки пишутся до фичи. Агент получает то, с чем будет сверяться, а не оценивает собственный код задним числом.
- Вы их просматриваете. Попросите агента перечислить простыми словами, что проверяет каждая, и допишите недостающее.
- Одобренные проверки переезжают в отдельную папку. Правило в настройках Claude Code запрещает агенту её редактировать. После этого проверки коммитятся: это второй слой защиты, если агент всё-таки попробует их поменять.
Принцип тот же, что у Карпати: агент не может изменить линейку, которой его меряют. Готовых skills под это (написать проверки, перенести и запереть) в Claude Code из коробки нет. Их можно попросить Claude собрать под ваш проект (немного костыльно, но задачу решает).
Осторожно
Если папку с проверками не запереть, долгий цикл рано или поздно «починит» падающий тест, ослабив его. Отчёт будет зелёным, а фича – нет.
Шаг 3. Свежий контекст на каждую фичу, журнал раундов и /goal
Основная сессия фичи сама не строит. Каждую фичу получает отдельный агент-сборщик, и каждый раз он стартует со свежим контекстом. Так ошибки и мусор одной фичи не тянутся в следующую, а основная сессия остаётся чистой и занимается только управлением.
Результат каждого раунда пишется в файл-журнал. Этот журнал понадобится на следующем шаге.
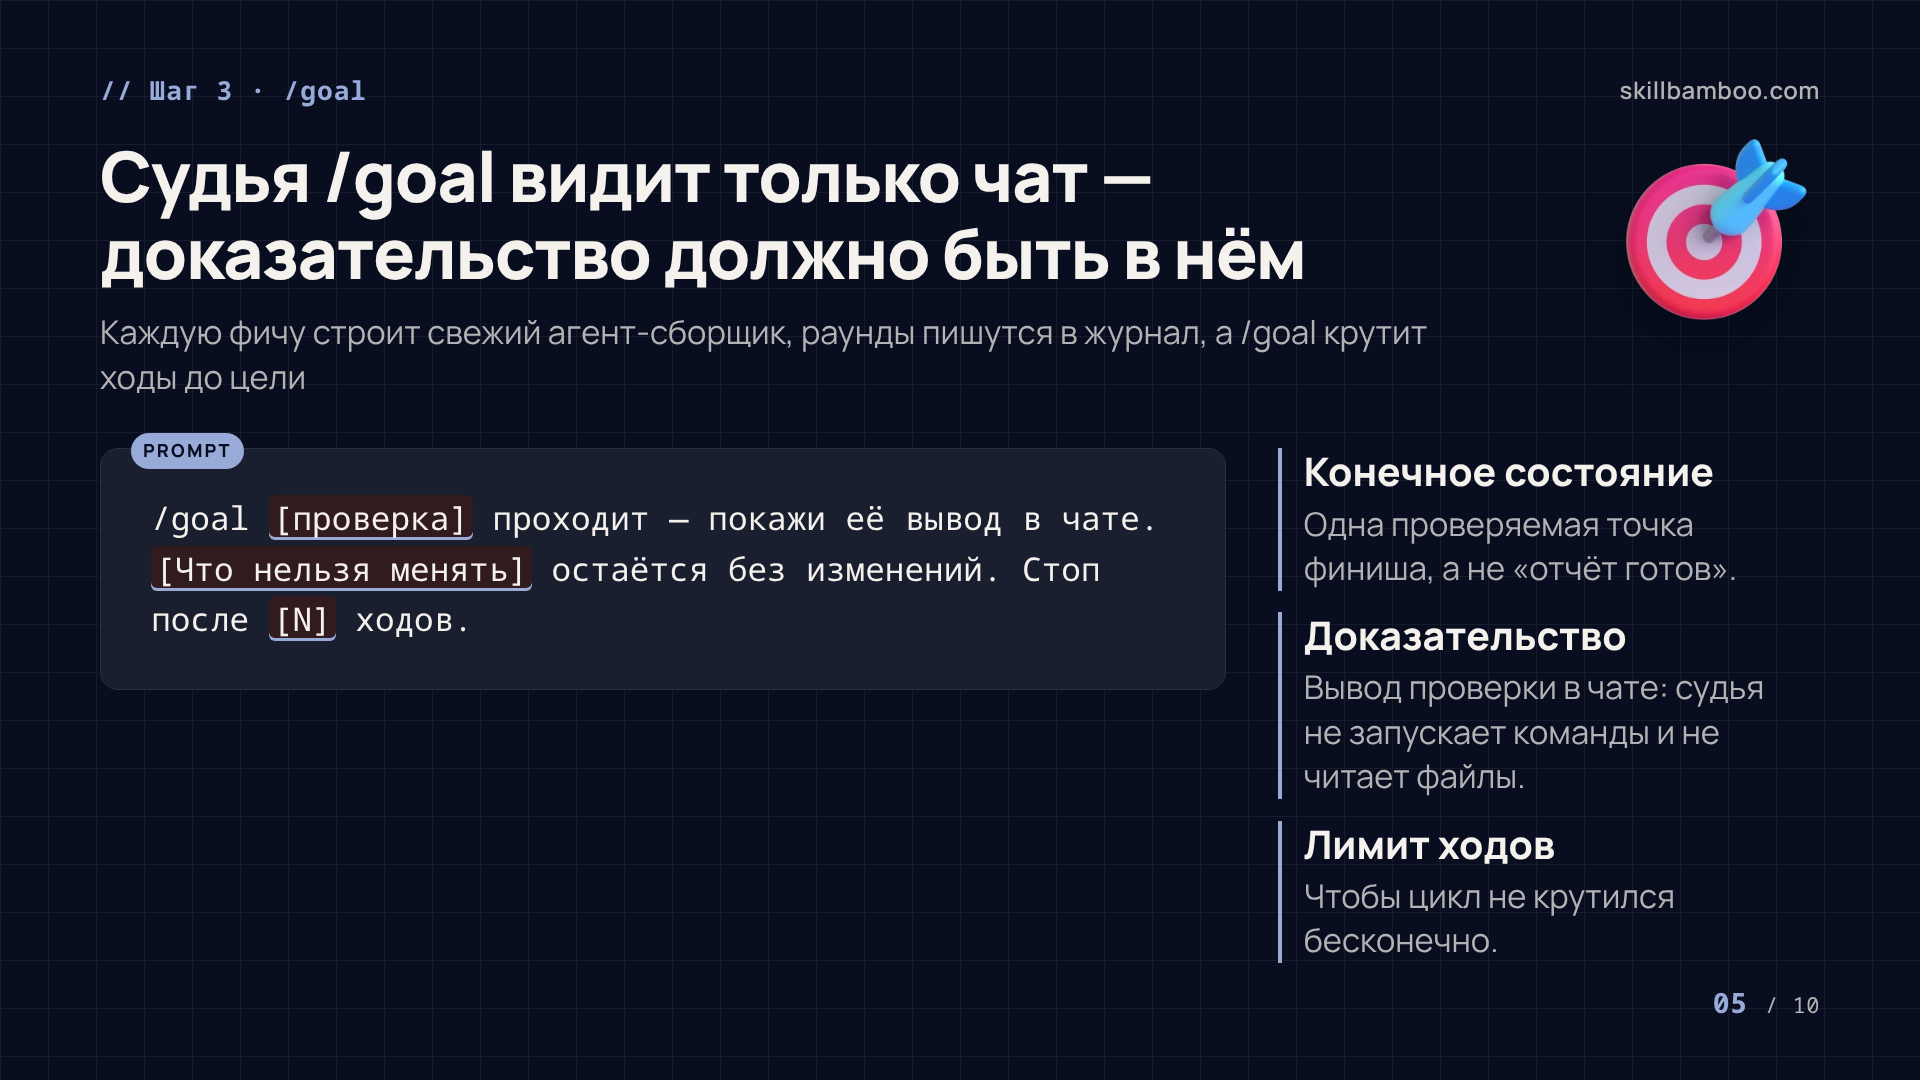
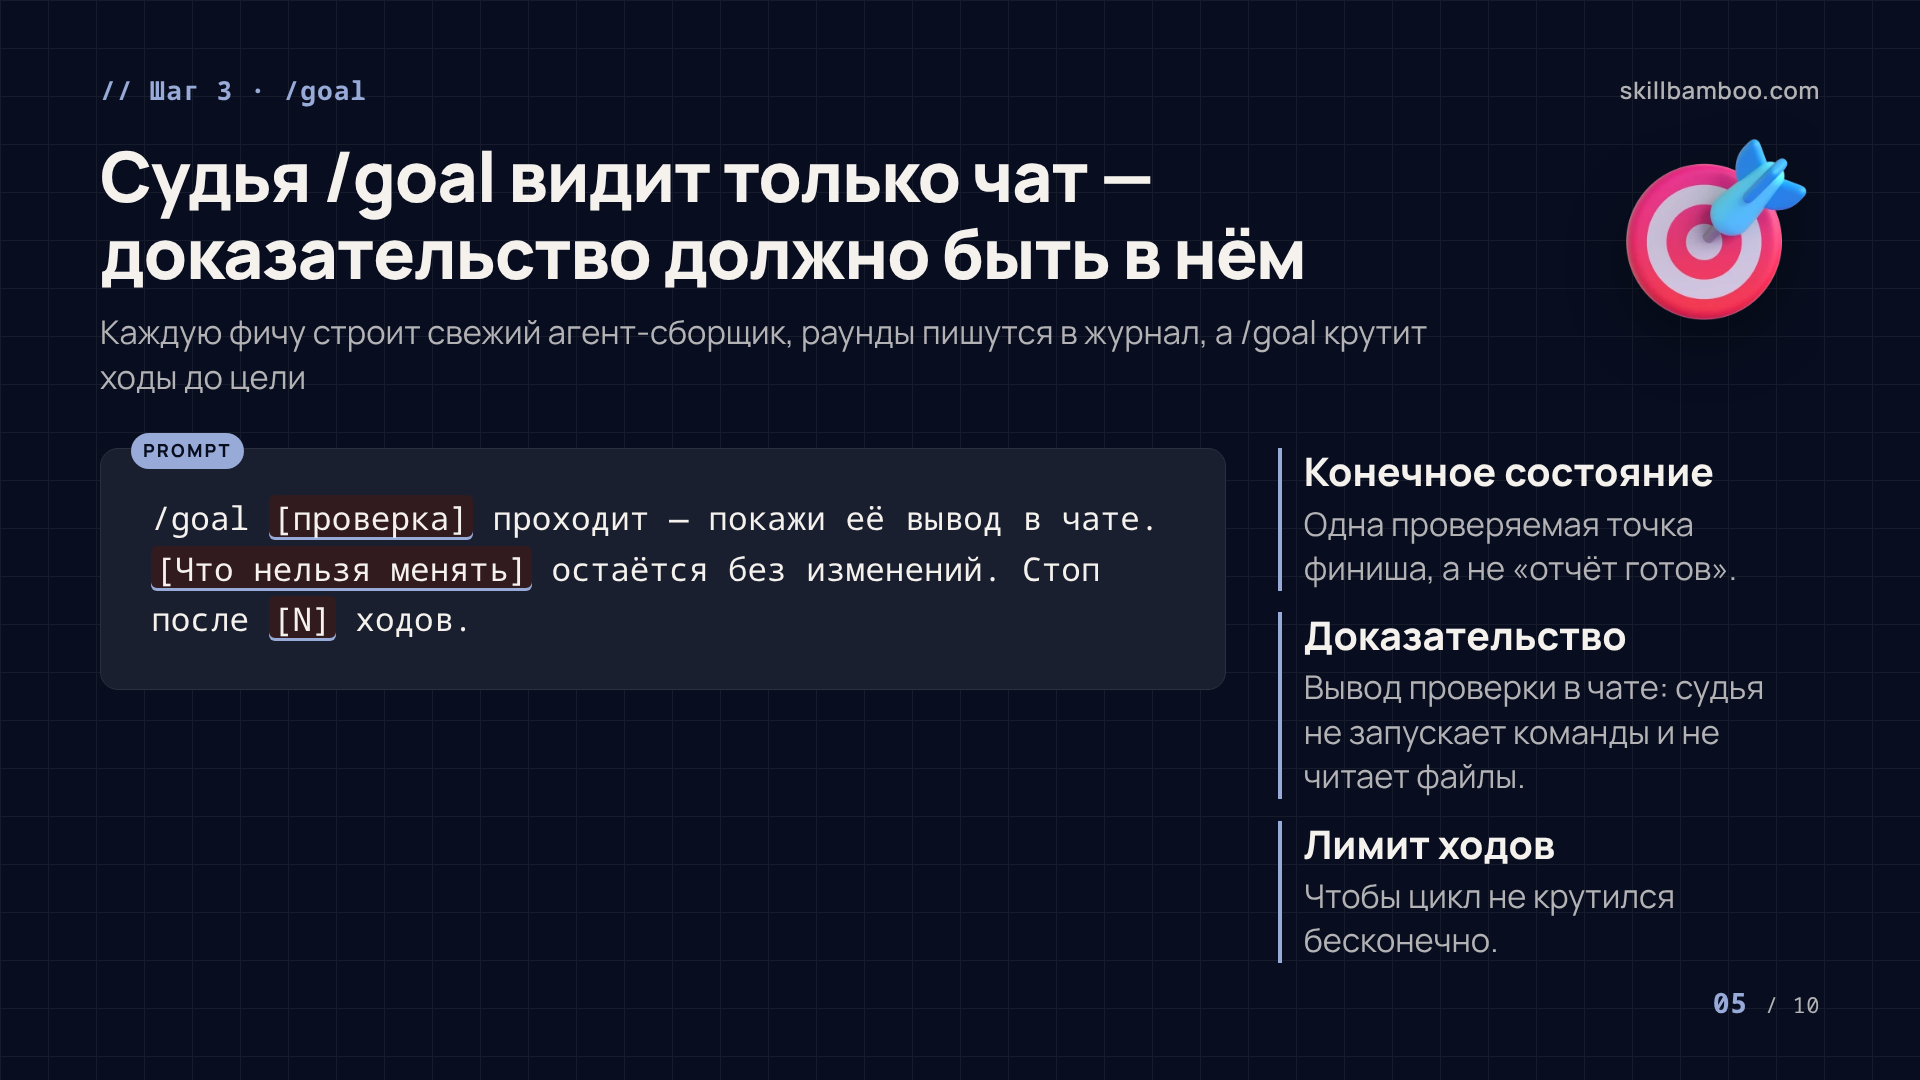
Чтобы не набивать «continue» руками, есть /goal: Claude продолжает работу ход за ходом, пока цель не достигнута. Но решение «достигнута или нет» принимает отдельная модель-судья, а она не запускает команды и не читает файлы – видит только переписку и ответ Claude. В итоге размытая цель из серии «отчёт готов» закроется раньше времени.
Хорошая цель для /goal содержит четыре вещи:
- одно конечное состояние;
- способ доказать, что оно достигнуто (например, вывод проверки в чате);
- что нельзя менять;
- лимит ходов, чтобы цикл не крутился бесконечно.
Шаг 4. Второй цикл учится на журнале
У свежего контекста есть обратная сторона: агент не помнит, что пошло не так в прошлый раз. Одна и та же дурная привычка кочует от фичи к фиче.
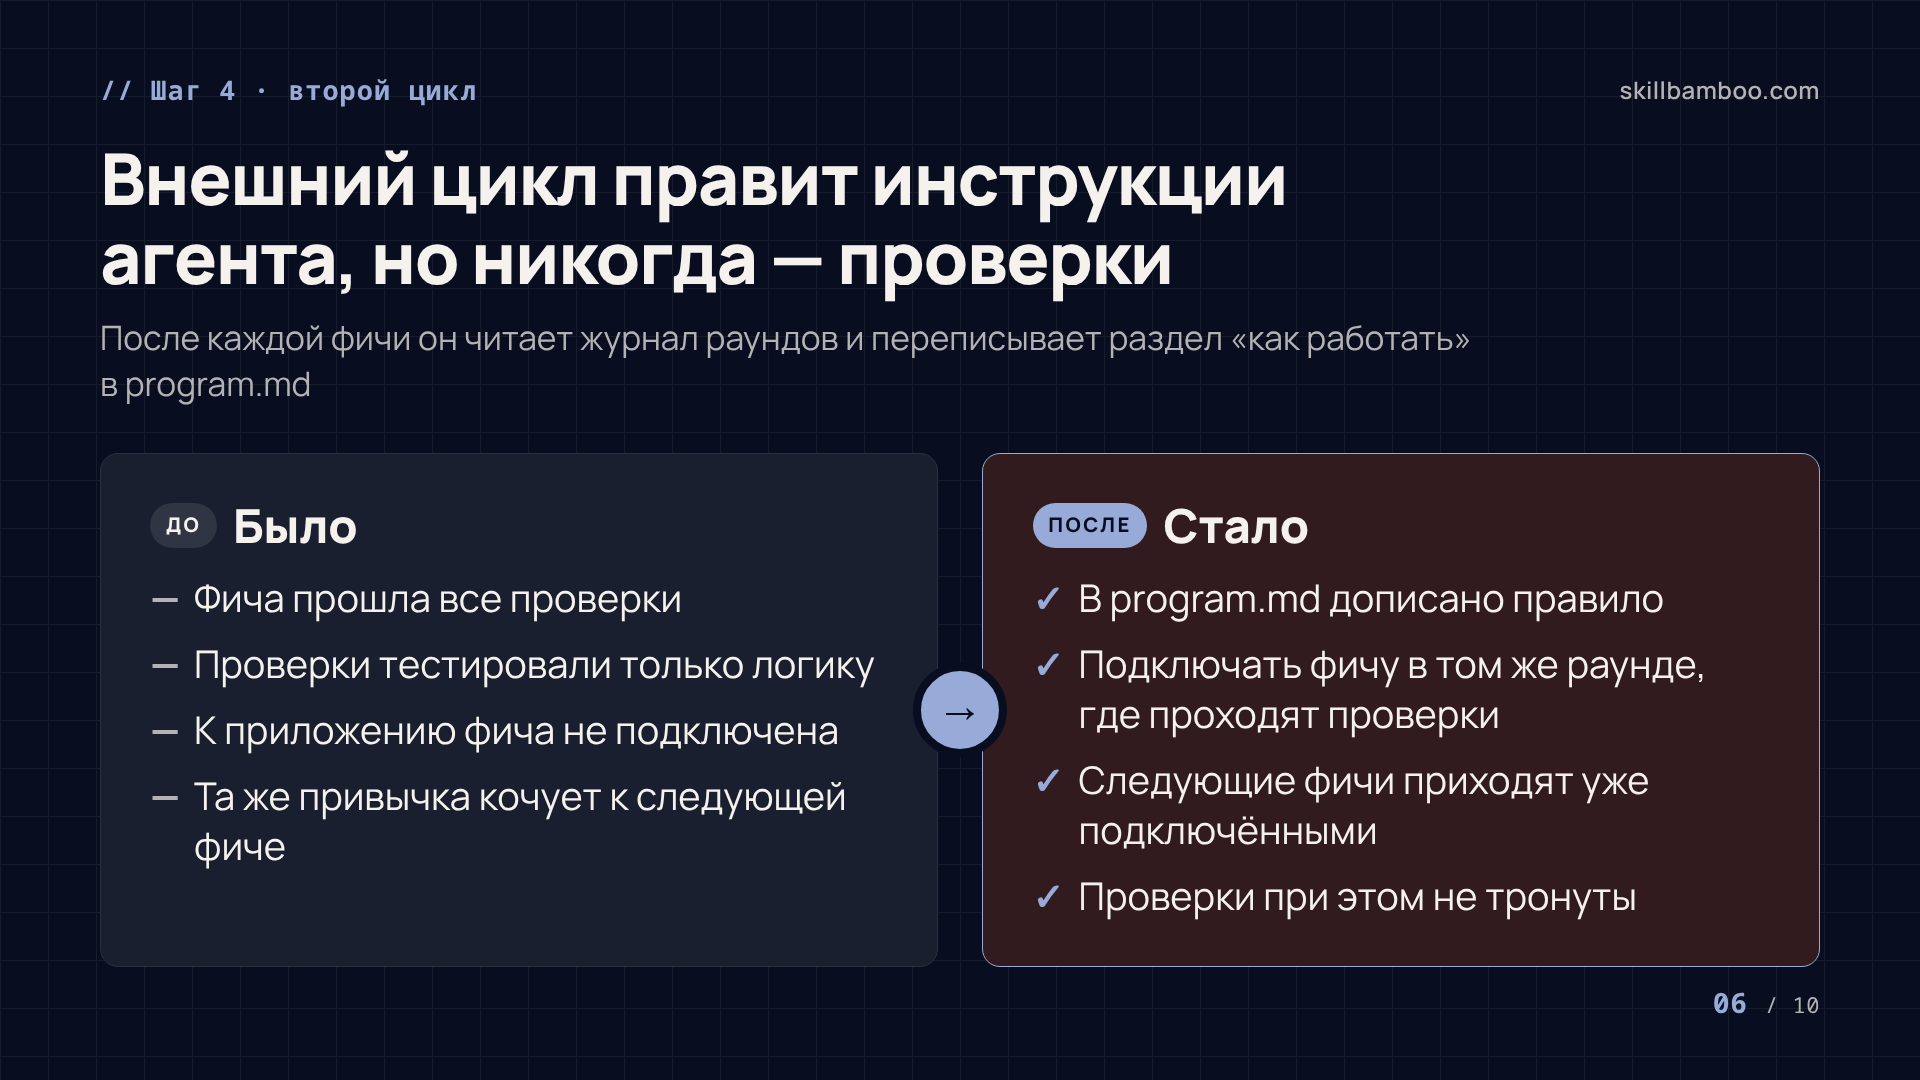
Решает это второй, внешний цикл. После каждой фичи он читает журнал раундов, ищет повторяющиеся проблемы и сам переписывает раздел «как работать» в файле инструкций program.md. Следующая фича стартует уже с исправленным методом.
Ограничение жёсткое: внешнему циклу тоже запрещено менять проверки. Иначе он сделал бы их проще, раунды перестали бы падать, а привычки агента так никто и не исправил бы.
Теперь кейс из практики. Фича прошла все проверки, но к приложению подключена не была: проверки тестировали только логику. Внешний цикл это заметил и дописал в инструкции правило: подключать каждую фичу к приложению в том же раунде, где проходят её проверки. Следующие фичи пришли уже подключёнными.
Шаг 5. Короткий CLAUDE.md с указателями и регулярный аудит
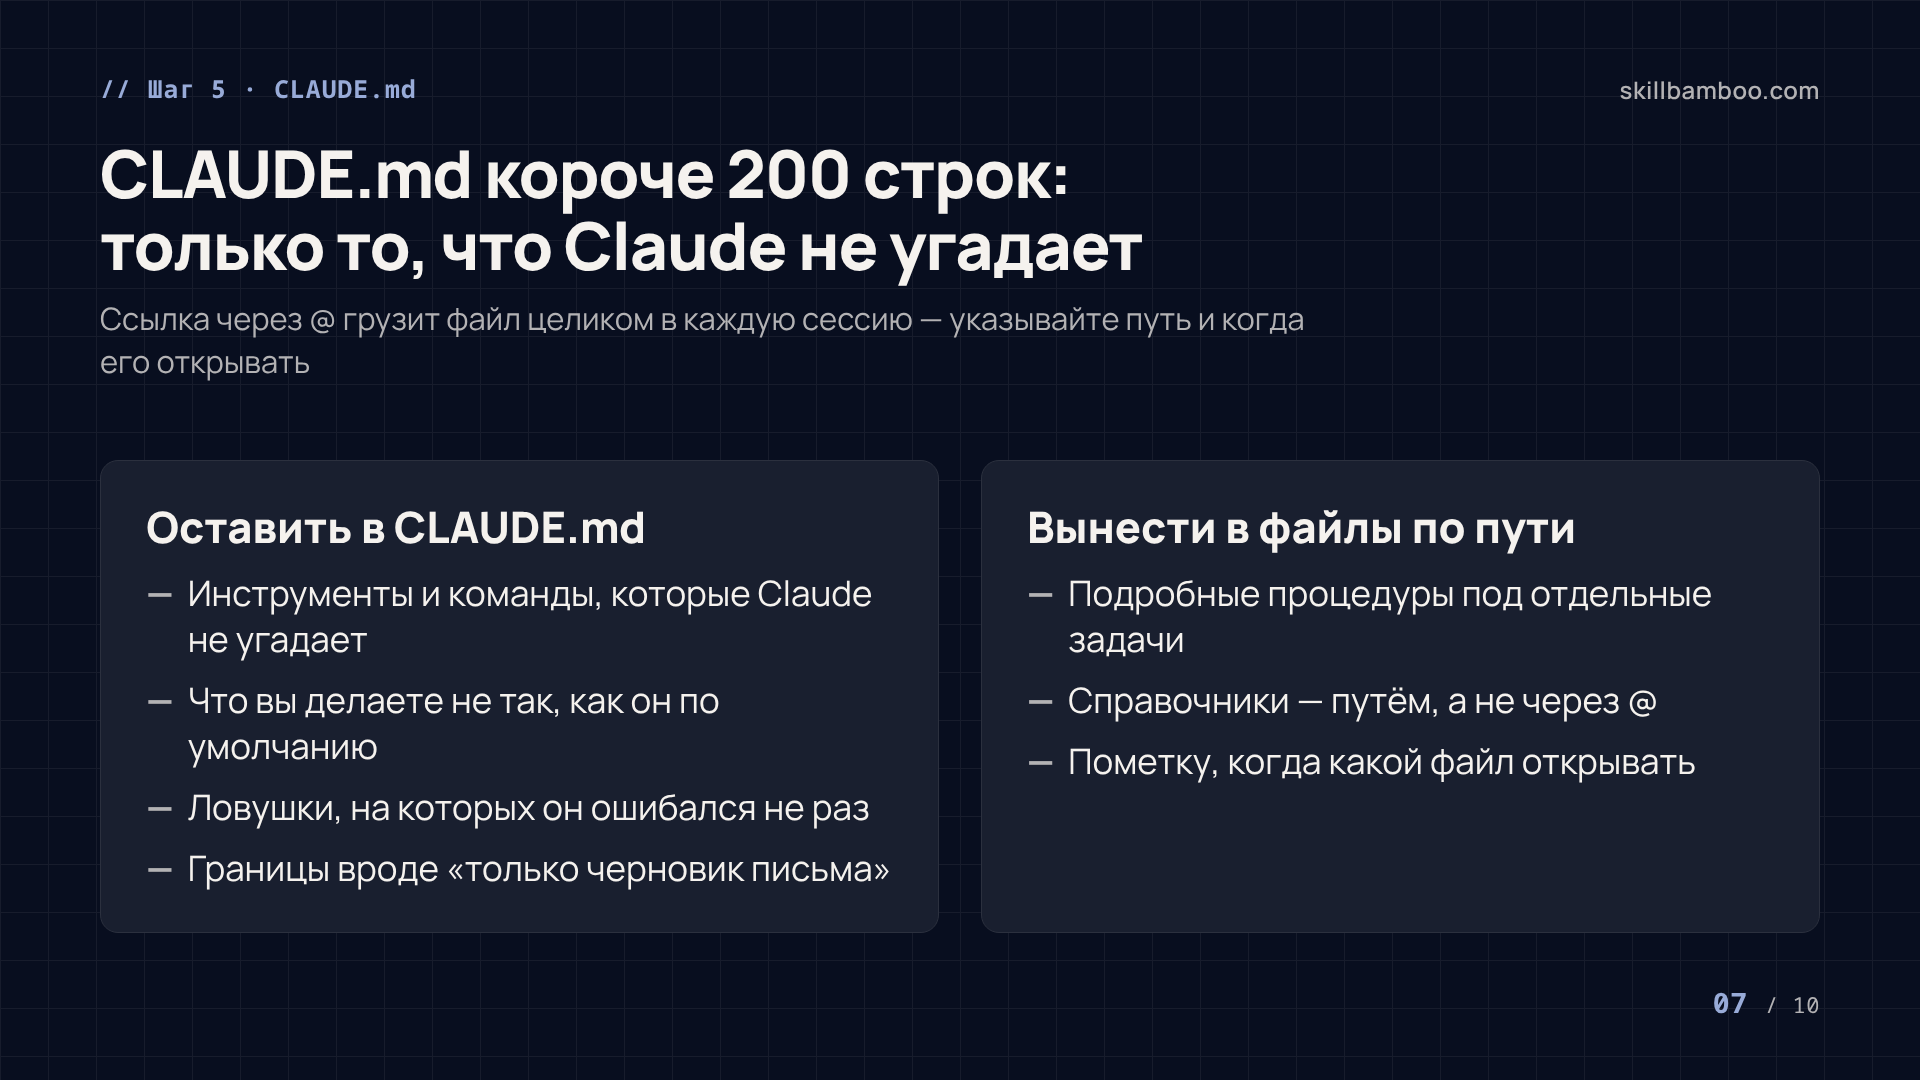
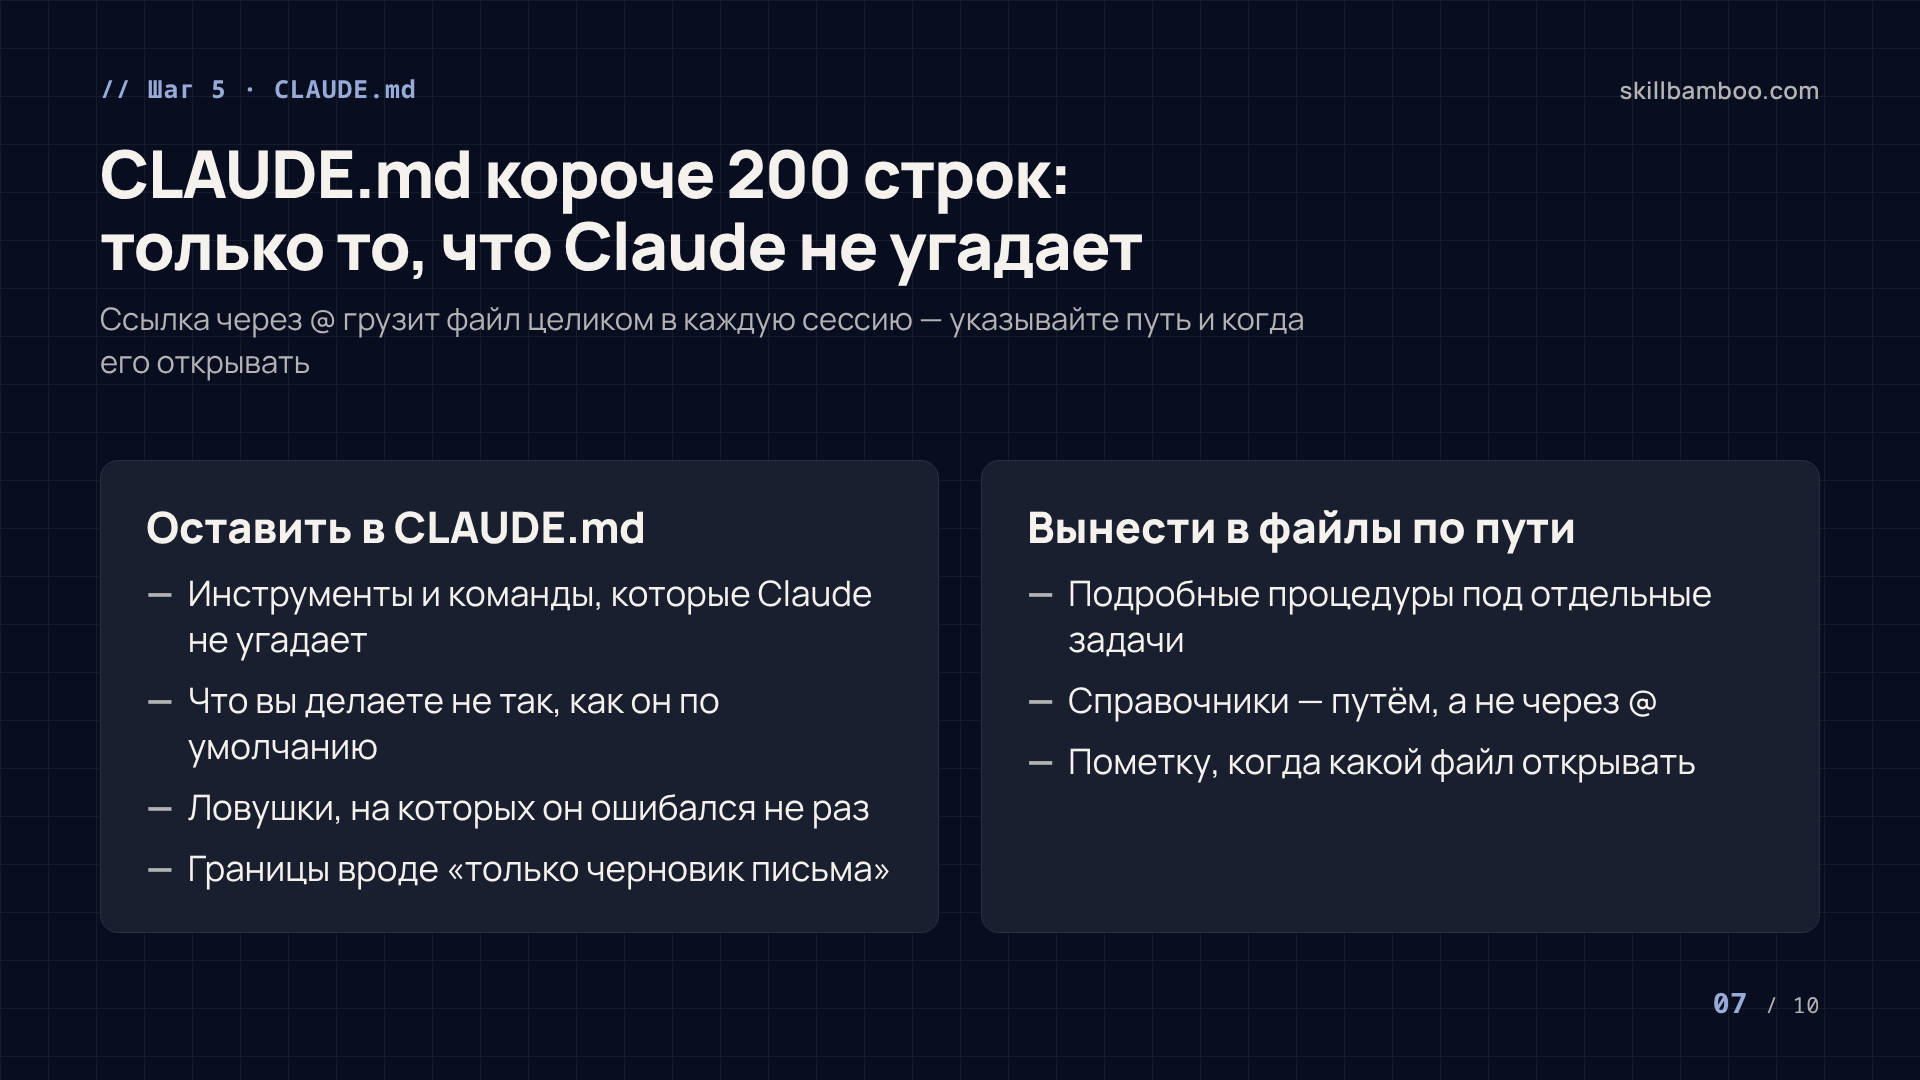
Документация Anthropic советует держать CLAUDE.md короче 200 строк: длинный файл дороже и хуже исполняется. Принцип тот же, что с системным промптом: минимум контекста, который ещё даёт нужный результат. Пример: жёсткий лимит на комментарии в коде там заменили одним указанием следовать стилю окружающего кода.
Что оставить в CLAUDE.md:
- инструменты и команды, которые Claude не угадает;
- то, что вы делаете не так, как он сделал бы по умолчанию;
- ловушки, на которых он ошибался больше одного раза;
- границы вроде «только черновик письма».
Всё остальное – указатели на файлы. Не через @: такая ссылка загружает файл целиком в каждую сессию. Пишите путь и когда его открывать. И это не вкусовщина: когда Anthropic стала подгружать описания MCP-инструментов для Claude только по необходимости, расход токенов упал на 85%, а оценка Opus 4 на MCP-тестах выросла с 49% до 74%.
Introducing advanced tool use on the Claude Developer Platform – Tool Search Tool и отложенная загрузка инструментов
Чистить настройки помогает /doctor: он проверяет навыки, память, плагины, настройки и установку и показывает, что можно выкинуть. Запускайте аудит при каждом переходе на новую модель, т.к. каждая читает инструкции немного по-своему. На сервере такие проверки удобно оставить крутиться в фоне, про живучие сессии и эксплуатацию Claude Code на VPS есть отдельный урок.
Ключевые термины
- Цикл Карпати – Схема, в которой агент раунд за раундом вносит одно изменение, получает оценку от неизменяемой проверки и оставляет изменение только при улучшении.
- Критерий готовности (definition of done) – Проверяемое описание того, как выглядит выполненная задача, по которому агент и проверки решают, закончена ли работа.
- /goal – Команда Claude Code, которая продолжает работу ход за ходом, пока отдельная модель-судья не решит, что цель достигнута.
- Уровень усилий (effort) – Настройка, задающая, сколько модель рассуждает над задачей; заменила слова вроде «think hard» в промпте.
- Сабагент – Отдельный агент со своим чистым контекстом, которому основная сессия передаёт часть работы.
- Хук – Небольшой скрипт, который Claude Code запускает в заданный момент без участия модели, поэтому он срабатывает гарантированно.
Итог: где цикл агента Claude Code ломается и что проверить перед запуском
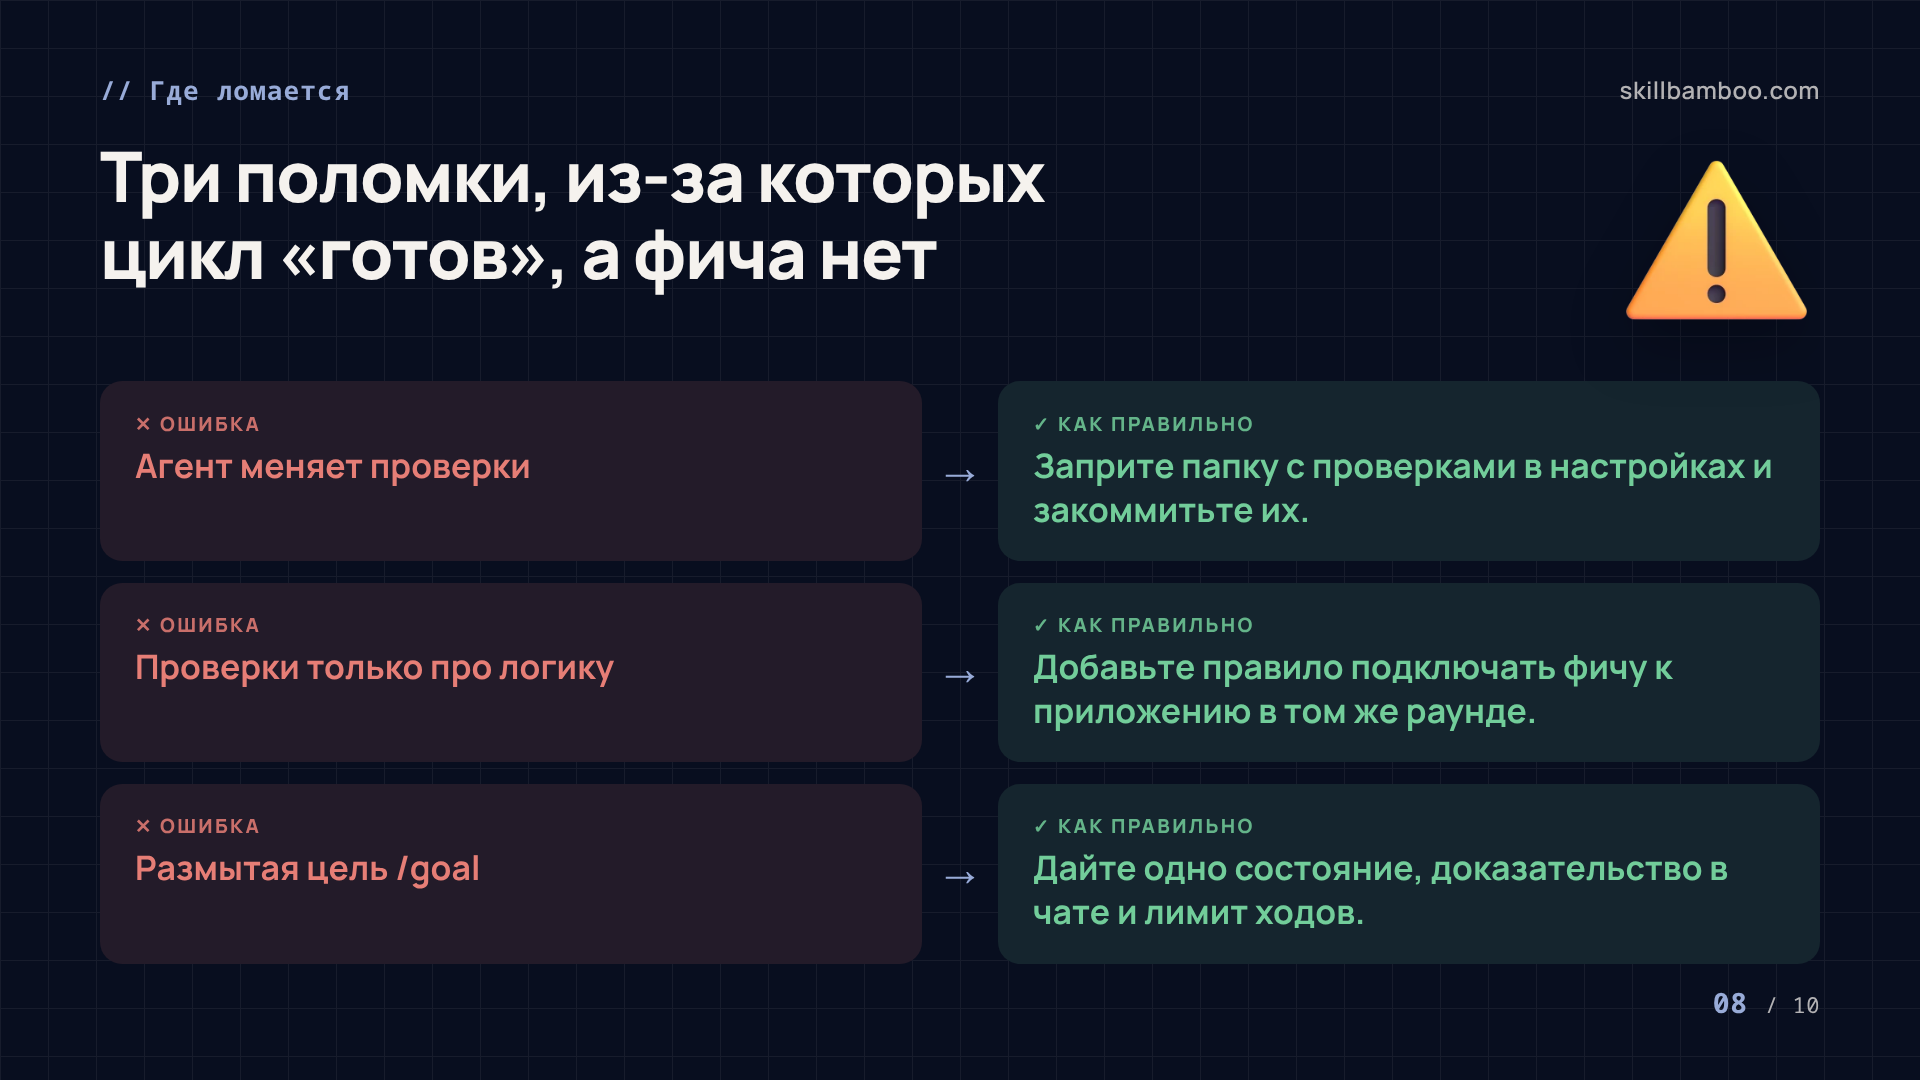
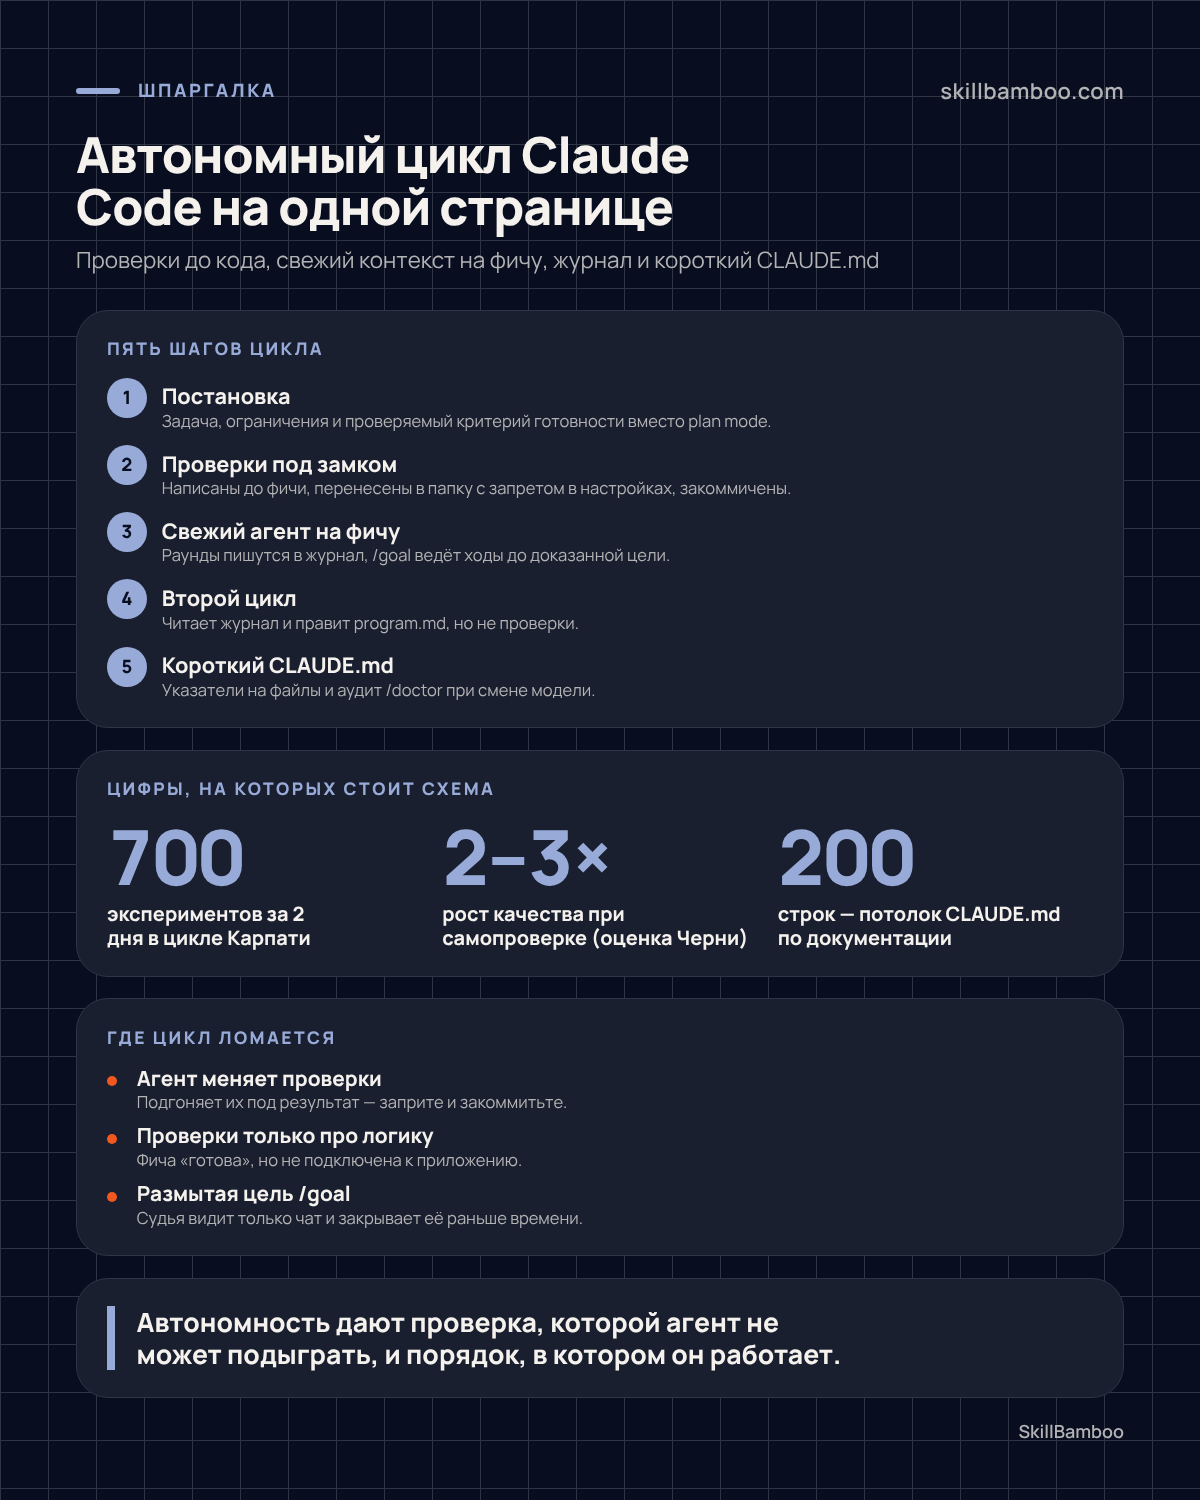
Типовых поломок три. Агент может менять проверки и подгоняет их под результат. Проверки покрывают логику, но не подключение, и в итоге фича «готова», хотя пользоваться ею нельзя. Цель для /goal размыта, поэтому судья, который видит только чат, закрывает её раньше времени.
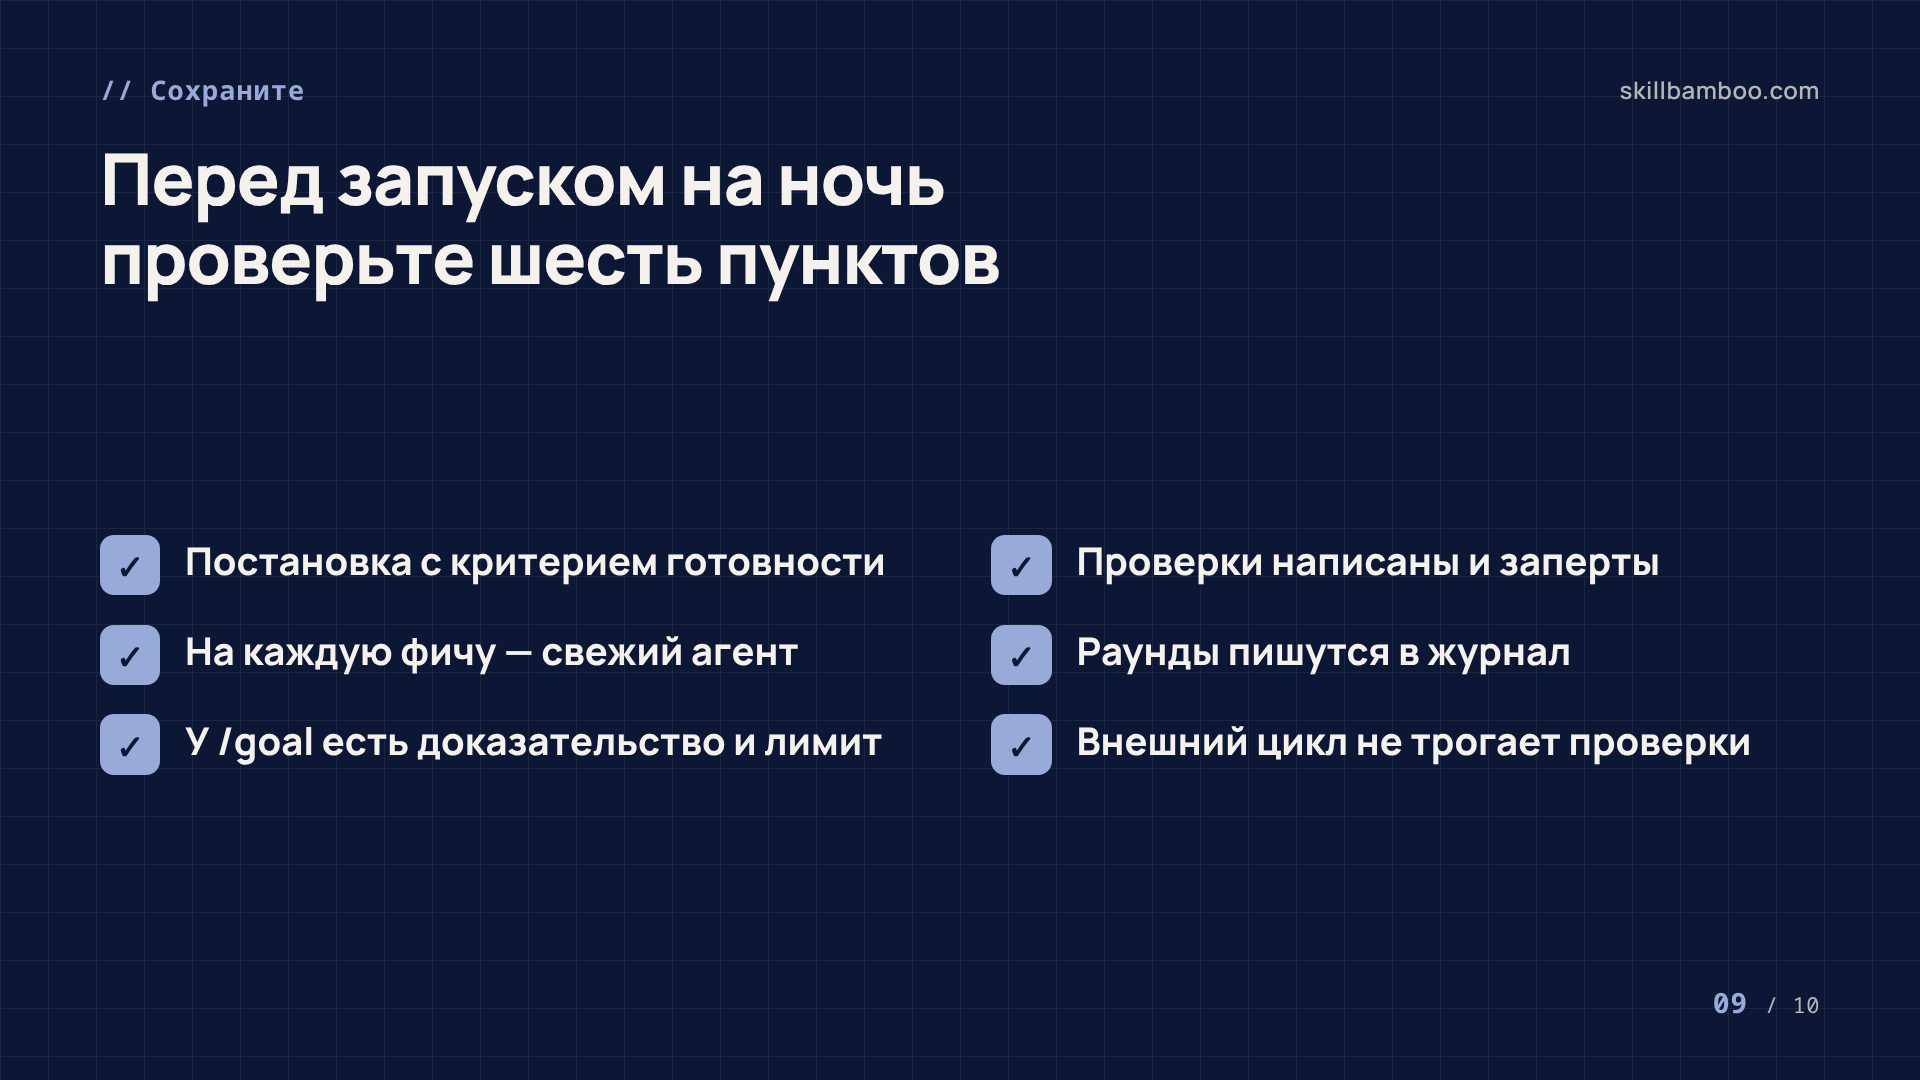
Перед тем как оставить агента на ночь, пройдитесь по схеме: постановка с критерием готовности, проверки написаны и заперты, на каждую фичу свой свежий агент, раунды пишутся в журнал, у /goal есть доказательство и лимит ходов, внешний цикл правит инструкции, но не проверки.
Итог
Теперь у вас есть порядок, в котором Claude Code работает часами сам: короткая постановка, запертые проверки, свежий контекст на фичу, журнал и второй цикл, который учится на ошибках. Начните с одной фичи, для которой легко написать проверки, и короткого CLAUDE.md с указателями. Когда цикл отработает без вашего участия, добавьте внешний цикл и регулярный аудит через /doctor.
Проверьте себя
1. Агент в цикле нашёл способ поднять оценку, поправив файл с проверками. Что не так в настройке?
- А. Нужно было написать в промпте «перепроверь работу»
- Б. Нужно поднять уровень усилий до максимума
- В. Проверки не заперты: агенту должно быть запрещено их менять
Показать ответ
Ответ: В. Если оценку можно править, агент упрощает её вместо улучшения результата.
2. Какую цель для /goal модель-судья сможет оценить надёжно?
- А. «Работай, пока не станет хорошо»
- Б. «Отчёт готов»
- В. «Скрипт проверки проходит, покажи вывод; шаблон не меняй; стоп после 15 ходов»
Показать ответ
Ответ: В. Одно конечное состояние, способ доказать, что нельзя менять, и лимит ходов – судья видит доказательство в переписке.
3. Какие задачи стоит отдавать в цикл?
- А. Фичу, которую можно проверить тестами с чёткой оценкой
- Б. Разовую задачу без критерия успеха
- В. Целое приложение сразу, чтобы сэкономить время
Показать ответ
Ответ: А. Цикл держится на оценке, по которой решается, оставить изменение или откатить.
4. Что из этого стоит оставить в CLAUDE.md? (Верных ответов несколько.)
- А. Ловушку, на которой Claude ошибался несколько раз
- Б. Команды проекта, которые Claude не угадает
- В. Ссылку @docs/guide.md на длинный справочник
- Г. Подробную процедуру монтажа видео для всех сессий
Показать ответ
Ответ: А, Б. А – Повторяющиеся ошибки – одна из немногих вещей, которые стоит держать в CLAUDE.md всегда. Б – Это то, чего модель не узнает сама.
5. Все проверки фичи прошли с первого раунда, но в приложении ею нельзя воспользоваться. Как это предотвратить в следующих фичах?
- А. Ослабить проверки, чтобы не мешали
- Б. Запускать все фичи в одном общем контексте
- В. Добавить в инструкции правило подключать фичу к приложению в том же раунде
Показать ответ
Ответ: В. Проверки покрыли только правила, поэтому правило в инструкциях закрывает дыру для всех следующих фич.